9 月 17 日,在华为全联接大会 2026 上,华为副董事长、轮值董事长汪涛系统阐述华为面向智能时代的 AI 基础设施战略,并集中公布昇腾 960 芯片、昇腾 960 超节点、Hi-ONE NPO 光互联、鲲鹏超节点以及 OceanStor M900 等多项产品与技术进展。
汪涛将华为的 AI 战略概括为七个方面:
以算力作为 AI 战略核心,坚持硬件变现;围绕“超节点+集群”进行系统架构创新;构建开源开放的算力生态,支持主流大模型原生训练;以盘古大模型推动华为自身产品智能化;通过本地基础设施和云服务提供灵活算力供给;面向端侧提供大、中、小、微多样化算力,加速 AI 入端、上车和物联智能化;同时围绕“用算”构建新一代通信网络。
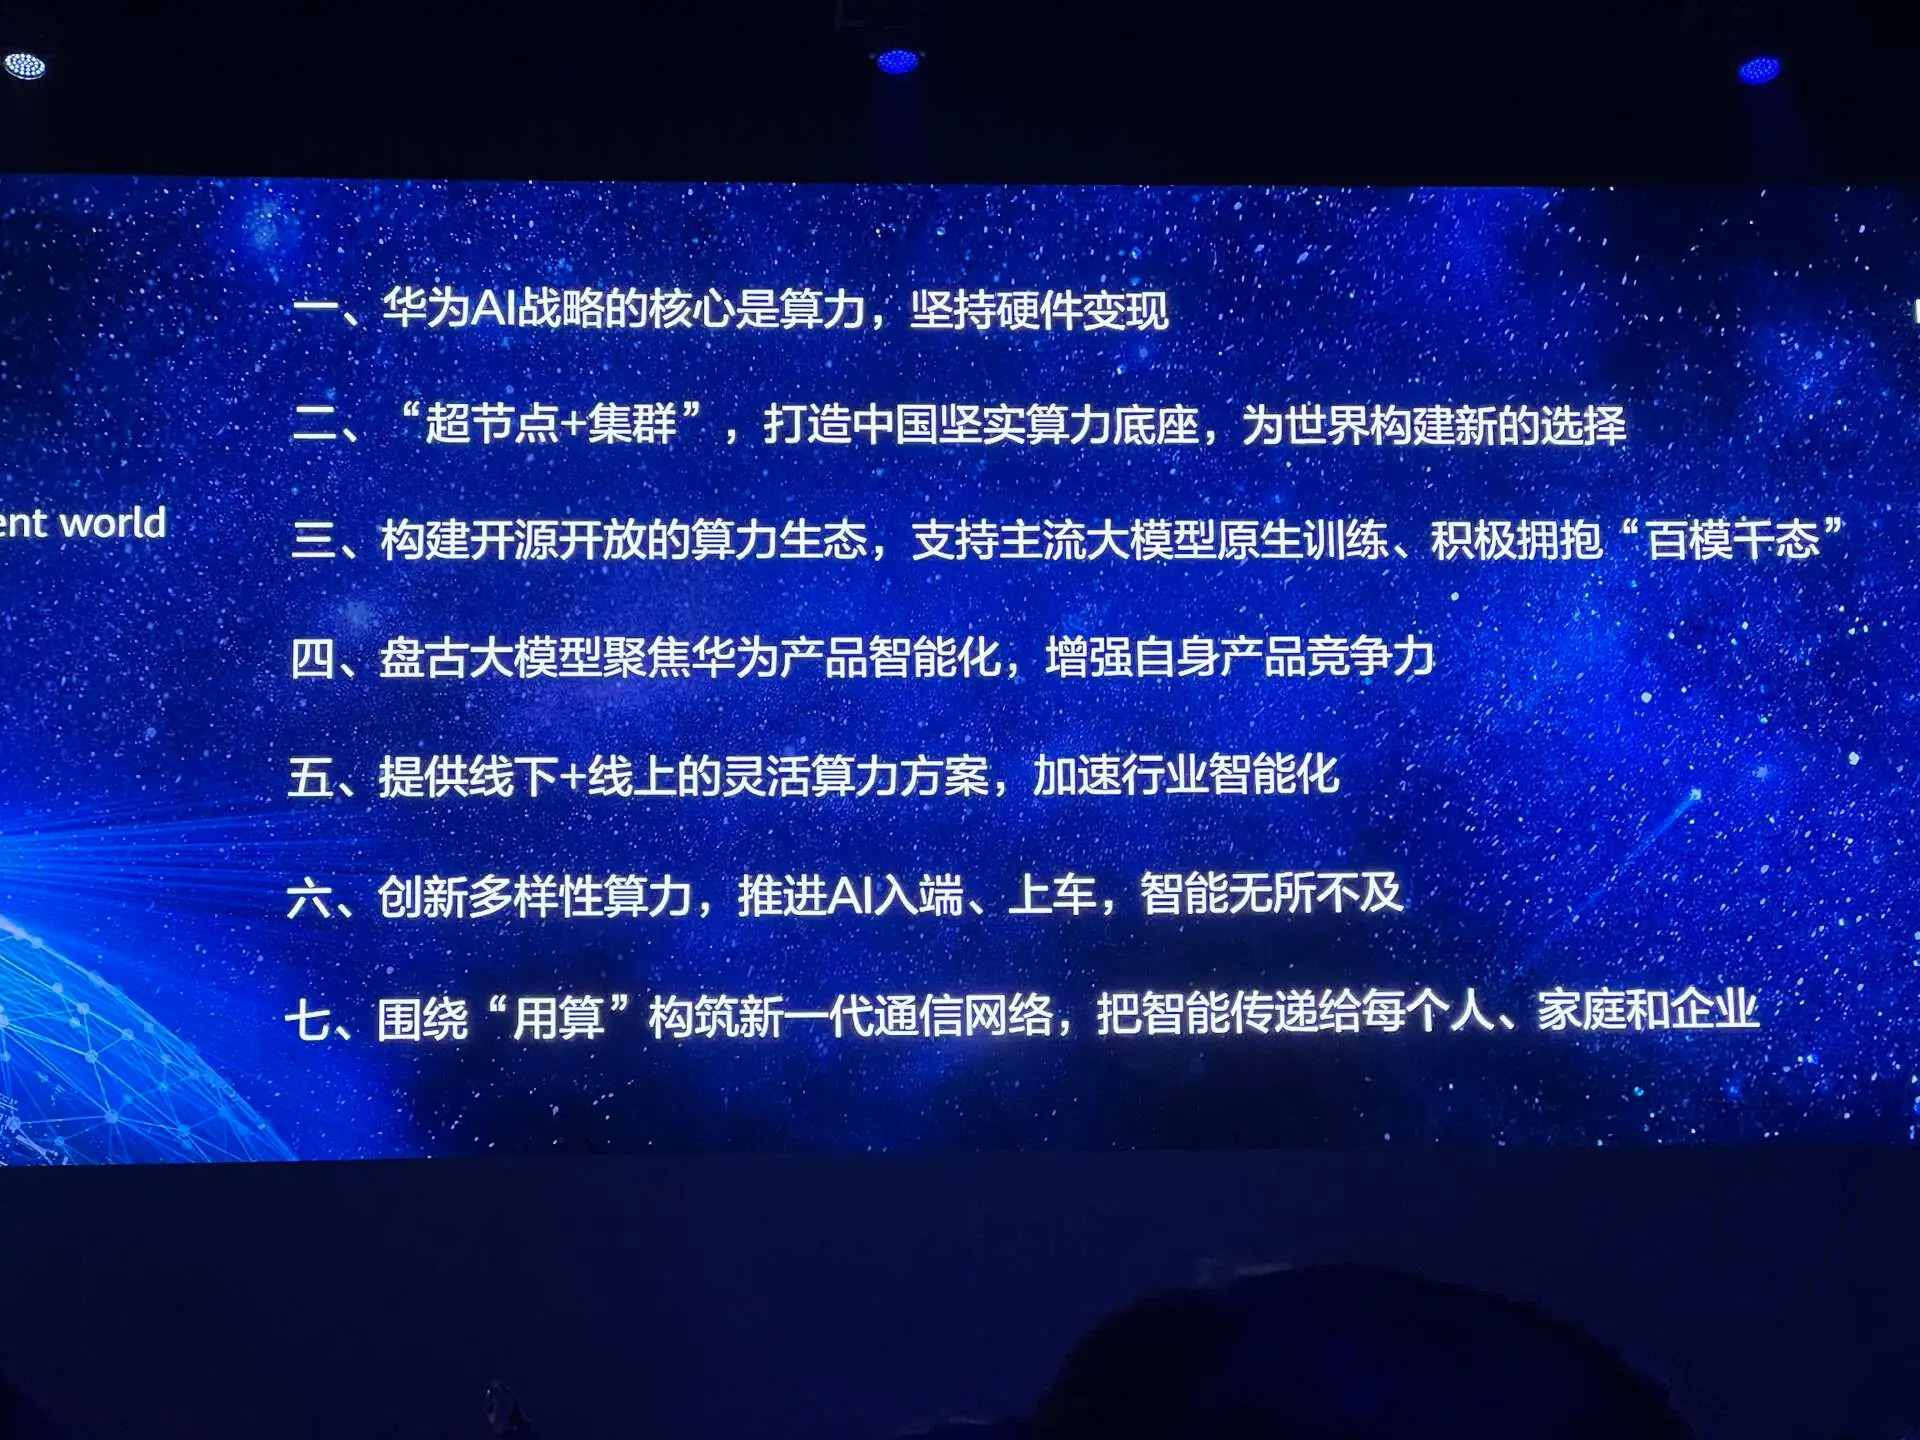
具体看,围绕算力,华为将重点通过“超节点+集群”进行系统架构创新,打造中国坚实的算力底座,并为全球市场提供新的选择。
生态方面,华为将继续构建开源开放的算力生态,支持主流大模型基于昇腾进行原生训练,积极拥抱“百模千态”;盘古大模型则更多聚焦华为自身产品智能化,持续增强产品竞争力。
在算力供给方面,华为面向客户提供线下基础设施与线上云服务相结合的灵活算力方案;面向端侧,则通过大、中、小、微多样化算力,加速 AI 入端、上车以及物联轻智能升级。
与此同时,华为还计划围绕“用算”构筑新一代通信网络,把中心、边缘和终端的算力连接起来。
10 万卡成为十万亿级模型新标配,超节点被推向核心位置
随着万亿乃至十万亿参数 MoE 模型快速迭代,大规模 AI 集群正在迅速扩张。华为判断,10 万卡集群已经成为训练十万亿级 SOTA 模型的标配。
但大规模集群并不是简单地把服务器数量相加。真正决定集群有效算力的关键之一,是芯片间通信效率以及模型浮点算力利用率 MFU。
按照华为的仿真结果,在传统 8 卡服务器组成的 10 万卡集群中,芯片间通信开销可能超过全部训练时间的 40%。服务器间通信相比服务器内部会出现数量级的时延增长,进而明显限制 MFU。
因此,华为选择通过超节点架构缩短大量计算组件之间的通信距离。
华为将超节点定义为:多个计算节点通过高效互联紧密连接组成,具备跨物理节点统一内存编址能力,并在逻辑上具备“一台计算机”特征的计算系统。
截至目前,昇腾 910C 超节点已经部署超过 1000 套,昇腾 950 超节点也已经实现规模商用。
根据华为马尔科夫实验室的仿真结果,由 4K 规模超节点组成的 10 万卡集群,相比由传统 8 卡服务器组成的 10 万卡集群,MFU 提升 2.75 倍。
在华为看来,随着 AI 集群规模不断扩大,超节点正在成为建设超大规模 AI 基础设施的重要架构基础。
昇腾 960 芯片路线图公布:2027 年进入新一代产品周期
围绕超节点架构,华为此次进一步披露了下一代昇腾芯片的演进路线。
其中,昇腾 960DT 支持 2 PFLOPS FP8 算力和 4 PFLOPS FP4 算力,片上 HBM 最大容量达到 288GB,访存带宽可达到 9.6TB/s。昇腾 960DT 研发进度较原计划提前三个季度,将于 2027 年第一季度准备就绪。
另一款昇腾 960PR 的 FP4 算力可达到 8 PFLOPS,研发进度较原计划提前一个季度,将于 2027 年第三季度准备就绪。
未来,昇腾系列芯片将维持“一年一代”的演进节奏。按照规划,华为将在 2028 年和 2029 年陆续推出昇腾 970 和昇腾 980 芯片。
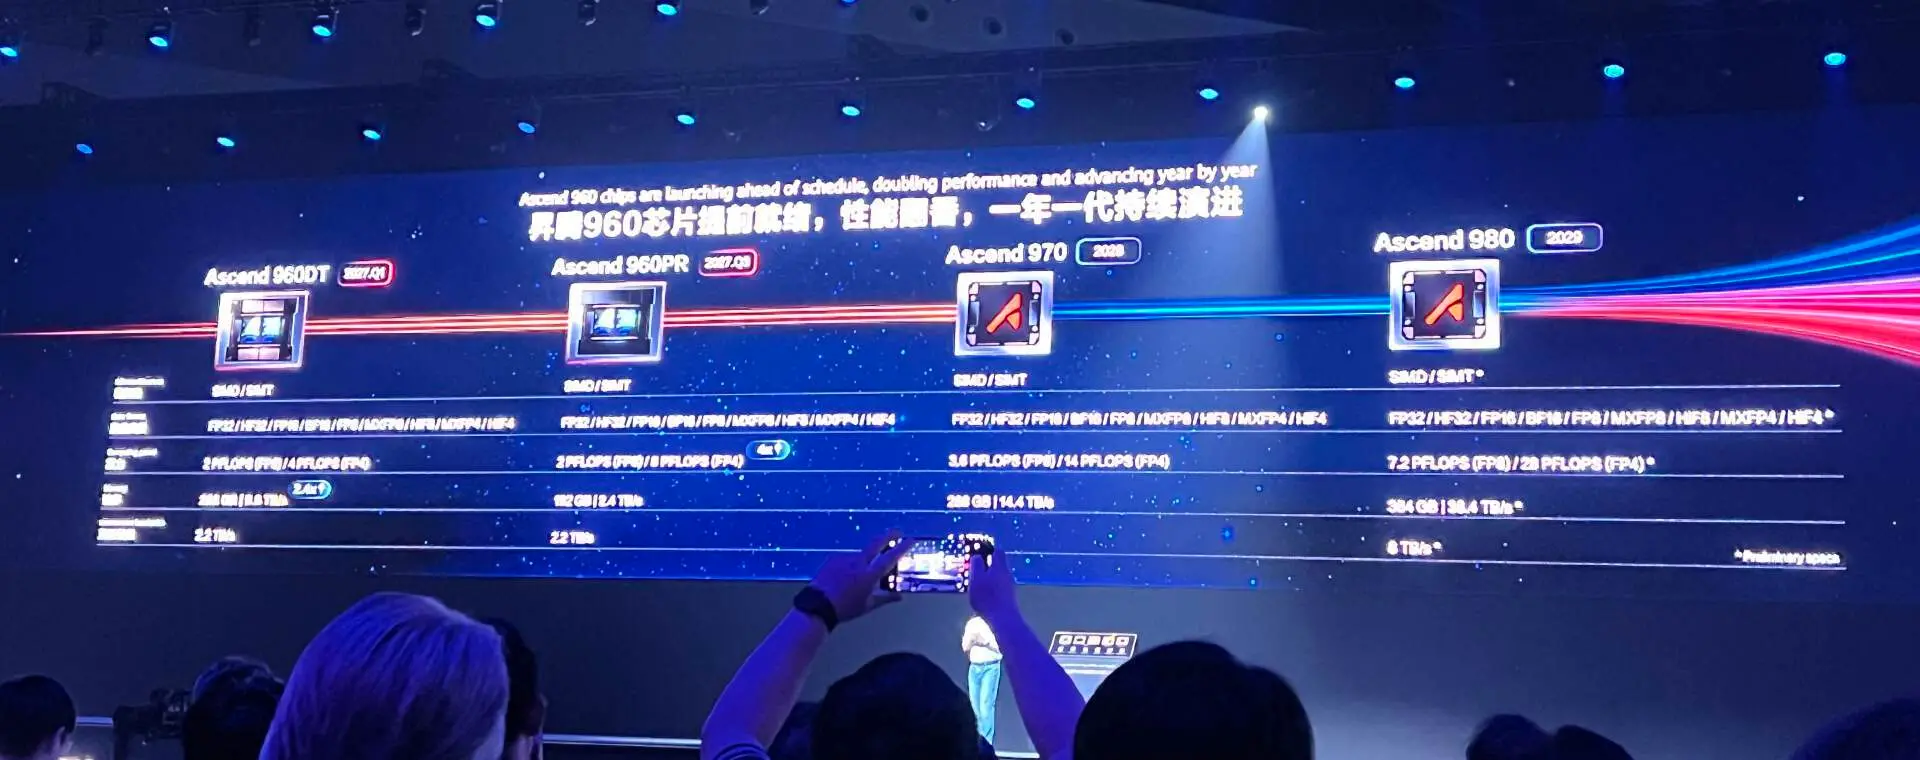
除了计算性能继续翻倍,访存带宽、访存容量和芯片互联带宽也将同步提升。华为将这一系统级演进路径称为“τ定律”。
7.2T Hi-ONE 量产,NPO 成为超节点光互联关键路径
对于数千乃至数万颗 NPU 组成的超节点而言,仅仅提高单颗芯片计算能力并不够,互联正在成为另一个关键瓶颈。
华为指出,当 SerDes 速率达到 224G 及以上时,传统铜缆的高速传输距离会快速下降;随着 NPU 数量增加,传统可插拔光模块也难以满足高密度互联所需要的扇出粒度。
为此,华为研发了新一代 NPO(Near-Packaged Optics,近封装光学)光互联产品 Hi-ONE。
NPO 与 CPO 的基本思路都是缩短高速电信号传输距离,让电信号更早转换成光信号。不同的是,CPO 将光电部件进行共封装,而 NPO 保留相对独立的光引擎。
华为认为,由于光器件和电芯片在材料体系以及热、力敏感度方面存在较大差别,CPO 共封装会带来可靠性、可制造性、可维护性以及 TCO 等方面的挑战,而 NPO 既能够缩短高速电信号路径,又能尽可能延续现有光模块产业生态。
Hi-ONE 采用华为自主创新的化合物光芯片、硅光芯片等技术,通过光、机、电、磁、热等多要素协同设计,实现单引擎 7.2T 传输容量。
汪涛称,Hi-ONE 是业界首个量产的 NPO 产品,也是目前行业传输能力最大的 NPO 产品和唯一实现内置光源的 NPO 产品。同时,华为已经向全球光互联标准组织 OIF 提出 NPO 标准立项建议,希望进一步推动 NPO 产业生态形成。
昇腾 960 超节点发布:4096 卡、8E FP8、1PB HBM
基于昇腾 960 芯片和 Hi-ONE,华为此次正式发布昇腾 960 超节点。这是华为所称业界首个采用 NPO 技术的超节点。
单个昇腾 960 超节点规模达到 4096 卡,最大可以提供 8E FP8 算力,同时形成高达 1PB 的 HBM 容量。在光互联方面,昇腾 960 超节点使用 5500 个 Hi-ONE,替代传统方案中约 4.8 万颗 800G 可插拔光模块。
华为表示,由此可以降低超过 550 千瓦功耗,系统无故障运行时间提升一倍,系统可用度达到 99.8%。
按照现场公布的规划,昇腾 960 风冷超节点和液冷超节点,将分别于 2027 年第二季度和第三季度陆续上市。
可以看到,华为对超节点的思路已经不再局限于增加单机 NPU 密度,而是试图通过芯片、内存、互联和光网络的一体化设计,将数千颗芯片进一步抽象成“一台计算机”。
超节点从 NPU 走向 CPU,鲲鹏瞄准 Agent 沙箱与向量检索
超节点并不仅仅服务于 AI 加速器。随着 Agent 应用进入生产环境,CPU 承担的计算负载也正在发生明显变化。
一方面,多 Agent 交互可能需要在秒级启动数十万个沙箱,对沙箱拉起速度提出毫秒级要求;另一方面,Agent 需要频繁进行知识和记忆检索,对向量数据库性能提出更高要求。
传统服务器采用以 CPU 为中心的通信架构,跨服务器数据访问所带来的时延和数据搬运开销,开始成为 Agent 负载中的瓶颈。
因此,华为进一步把超节点架构引入通用计算。
新一代鲲鹏超节点基于灵衢全光组网,最大支持 4096 个节点,并可以形成高达 256TB 的统一内存池。其核心思路,是将多台通用服务器中的内存组织为一个统一的共享内存池,并将沙箱镜像、向量检索引擎等放入共享内存中,以减少跨节点数据搬运。
汪涛表示,在 Agent 沙箱场景中,10 万级沙箱启动相比传统服务器方案性能提升 30 倍,同时沙箱密度还可以进一步提升 25%。
在 Agent 向量检索场景中,面对百亿规模、千维度的复杂向量检索,鲲鹏超节点相比传统服务器可以实现性能倍增。按照现场披露的数据,其检索能力可以达到 30 万 QPS。
Agent 把 KV Cache 推向 PB 级,OceanStor M900 补上 L3.5
除了算力和互联,KV Cache 也成为此次华为 AI 基础设施战略中的另一个重点。
Agent 上下文从 4K 扩展到 100 万 Token,序列长度增长约 250 倍。同时,Agent 与模型之间的交互频率也远高于传统人机对话。在这一趋势下,每张 AI 加速卡所对应的 KV Cache 需求可能达到 TB 级,并继续快速增长。
但 HBM 和 DRAM 容量有限、成本较高,因此,在系统层面构建 PB 级、低延迟 KV Cache 正在成为长上下文和 Agent 推理的重要基础设施问题。
华为由此提出多层 KV Cache 架构。其中,L1 层是 NPU 内部 HBM,拥有最高带宽和最低时延;L2 层为服务器 DRAM;L3 层为服务器本地 SSD;L3.5 层则是面向整个集群共享的 PB 级 KV 缓存系统。
此次发布的 OceanStor M900,就是华为面向 L3.5 层推出的 AI 记忆存储系统。OceanStor M900 基于灵衢 UnifiedBus,使 NPU 能够一跳访问全局 PB 级 KV 缓存。
披露的数据显示,传统 PCIe+RoCE 架构中,GPU 或 NPU 访问 SSD 池可能需要进行 5 次数据搬运,而 OceanStor M900 可以减少到 1 次,I/O 时延和首 Token 时延降低超过 50%。其访问时延约为 10 至 15 微秒,访问带宽可以达到 40GB/s。
针对 KV Cache 高频读写带来的 SSD 寿命问题,OceanStor M900 还采用混合介质与优化的 Retention 算法,将 SSD 读写寿命提升 16 倍,从底层保障 KV Cache 命中率和长期稳定运行。
灵衢 UnifiedBus 连接三大系统
昇腾 960 超节点、鲲鹏超节点和 OceanStor M900 并不是三个孤立产品。华为希望通过灵衢 UnifiedBus,把智算、通算和 AI 记忆存储连接成一个更大的 Agentic 超节点集群。
传统 AI 基础设施中,计算、网络和存储子系统通常采用不同互联协议,大量跨协议转换会增加时延和 CPU 参与开销。
灵衢 UnifiedBus 的目标,则是用一套协议实现不同子系统之间的平等互联,减少协议转换,让昇腾超节点、鲲鹏超节点和 KV Cache 集群之间可以更直接地交换数据。
华为表示,自己正在发挥“计算+通信”的综合优势,以这一架构加速 10 万亿参数大模型训练和推理。
在存储侧,系统同时提供多层次、高带宽、大容量的 KV Cache,各层缓存都可以实现一跳访问,从而分别承载热、温、冷等不同数据。
在集群规模方面,采用两层 Clos 单平面组网,可实现约 3.2 万张昇腾 960 卡高效互联。通过两层 Clos 四平面组网,最大集群规模可以达到 51.2 万卡;进一步结合多轨道拓扑技术,最大可扩展至 100 万卡规模。
针对跨楼栋和远距离部署,华为还提供基于 OCS 光交换的互联方案,用于降低超大规模集群中的光互联成本。
10 万亿参数模型怎么部署?华为给出训练和推理参考方案
针对十万亿参数模型训练,华为给出了一套 10 万卡参考配置:采用 25 个 4096 卡昇腾 960 超节点组成约 10 万卡集群,并通过两层 Clos 单平面网络互联。
按照现场披露的数据,整个系统可以提供约 200 EFLOPS FP8 算力,用于支撑 10 万亿级大模型快速训练和迭代。
在对时延更加敏感的推理场景中,华为则给出了另一套思路。
针对 10 万亿参数大模型和 5 毫秒级低时延需求,可以采用 352 张昇腾 960 卡组成超节点,通过单层灵衢交换实现一跳直达;随后再按照用户量和并发需求扩展为“352×N”的推理集群系统。
从 CANN 到 PyTorch,继续推进开源开放
除了硬件和系统架构,构建开源开放的算力生态仍然是华为 AI 战略的重要组成部分。
截至目前,鲲鹏全球开发者数量已经超过 416 万,全球生态合作伙伴超过 7200 家,支持 560 多个全球开源项目。openEuler 装机量超过 2000 万套。
在昇腾侧,CANN 正在进一步进入常态化开源社区运营。
华为表示,目前 CANN 外部开发者数量已经首次超过内部开发者,占开发者总数的 61%,社区月活跃开发者突破 5200 名。
基于“昇腾+CANN”进行原生训练的模型已经超过 40 个。华为称,这是目前国内唯一支持预训练的技术路线。同时,昇腾已经覆盖 90 多个主流第三方社区,包括 PyTorch、Triton、vLLM、veRL 等。
在 Linux 基金会支持下,昇腾目前已经成为可以在 PyTorch 官网直接安装的算力平台,也是首个来自中国的算力平台。
在模型生态方面,昇腾已经适配超过 200 个开源大模型,包括国内主要开源模型,并持续针对最新版本进行适配。
算力不只卖设备,线下基础设施与云算力并行
随着 AI 进入企业核心生产系统,算力供给本身也正在从单一采购模式向多种方式并存演进。
大型企业越来越倾向于将 AI 算力中心视为长期战略资源,而大量中小企业更加看重算力敏捷获取、弹性扩容以及按需使用。
因此,华为的算力供给同时覆盖线下 AI 基础设施和线上云服务。一方面,华为通过系列化超节点和集群产品支持企业自建 AI 基础设施;另一方面,也通过华为云向客户提供弹性算力。
目前,华为云已经在贵安、内蒙古和芜湖等地布局核心算力资源。其中,内蒙古包括和林格尔、乌兰察布等算力资源池,用于降低企业获取 AI 算力的门槛。
终端算力布局:手机、电脑和汽车
如今,AI 正在进一步从数据中心向终端渗透。
汪涛表示,手机端侧模型已经从 2024 年的 3B 发展到目前的 30B,未来将进一步走向 100B 级。
在近期发布的 HUAWEI Mate XT 2 非凡大师上,华为已经商用原生盘古 30B-A2B MoE 全模态大模型,总参数量 30B,激活参数约 2B。
他预测,从 2026 年到 2030 年,端侧模型参数规模还将出现约 10 倍跃迁,由 17B、30B 逐渐提升至 70B 甚至 100B,端侧算力则会向 180 至 200 TOPS 以上发展。
为此,华为将在端侧主要从四个方面推进 AI 能力。
首先,通过麒麟和昇腾组合,实现端侧算力自给和自治;其次,通过盘古与第三方大模型提升端侧智能;第三,将 HarmonyOS 进一步向 Agent OS 方向演进,从系统底层架构、运行机制和交互逻辑上支撑 Agent 与人协同;第四,则通过 AI 生态扩展小艺系统智能体能力。
华为将重点围绕 AI Phone、AI PC、车和家庭场景,打造四大端侧算力平台,并通过端端算力协同和端云算力协同,形成分布式群体智能。
汽车也是端侧 AI 快速增长的重要场景。截至 2026 年 9 月,华为乾崑智驾累计搭载量已经突破 200 万辆,累计辅助驾驶里程超过 150 亿公里。
真实世界的大规模部署正在不断产生驾驶数据,并进一步与云端训练算力、车端智能结合,形成数据、算法和算力闭环。华为预测,到 2030 年前后,伴随 L4 自动驾驶逐步进入规模商用,自动驾驶相关算力与应用规模将增长 10 倍以上。
华为乾崑智驾 WEWA 架构由云端 World Engine 与车端 World Action Model 组成,通过云端多智能体在线学习、车端多传感器融合感知以及 MoE 模型,提高系统协同和泛化能力。未来 5 年,华为乾崑智驾还计划投入超过 700 亿元人民币,继续推动汽车产业从辅助驾驶向自动驾驶演进。
除了手机、PC 和汽车,大量 IoT 设备也可能成为 AI 新的入口。
当前千行百业仍然存在大量“无智能、无连接、无感知、无显示”的轻量化终端。华为希望为这些设备提供从小于 1 TOPS,到 1 至 10 TOPS,再到 10 至 100 TOPS 的不同级别算力。
与此同时,华为将继续推动 OpenHarmony 小型化,使其逐渐成为面向轻智能场景的 AI OS。
目前,星闪终端累计数量已经突破 3 亿。未来,华为还计划进一步结合星闪与 OpenHarmony,构建轻智能终端的原生连接能力。
当算力从数据中心向边缘和终端扩散之后,如何连接这些算力,也成为 AI 基础设施的一部分。
“没有网络的算力就是信息孤岛”汪涛说道。
传统通信网络主要围绕人的通信、信息获取和娱乐构建,而进入 AI 时代后,网络连接主体正在进一步扩展到智能体、汽车、机器人以及海量 IoT 设备。
华为计划围绕“用算”建设下一代通信网络,以 5G-A/6G、万兆光网以及多级协同低时延承载网为基础,将中心、边缘和端侧算力连接起来。
在数据中心内部,光电融合网络将面向最高百万卡规模超节点集群,通过算、网、存协同提升网络效率。按照现场数据,通过相关网络技术,集群网络带宽利用率可以达到 95%以上。
在数据中心互联和接入侧,华为还提出通过新一代 DCI 和 DCA 网络,以 AIDC 为中心建立枢纽、区域、边缘多级架构,并通过全光网络构建 1 毫秒、5 毫秒和 20 毫秒时延圈。
而在移动和固定网络接入侧,网络则需要进一步面向人、车、物和具身智能等不同主体,满足智能体实时交互和推理产生的大流量、低时延通信需求。
结束语
从此次发布可以看出,华为 AI 基础设施一条更完整的技术路线正在形成:底层以昇腾和鲲鹏提供计算能力,以超节点突破传统服务器的物理边界;通过 Hi-ONE 和灵衢 UnifiedBus 解决 Scale-up 和跨系统互联问题;通过 OceanStor M900 将 KV Cache 进一步提升到独立的基础设施层;再将智算、通算和存储组合成 Agentic 超节点集群,并向最高百万卡规模扩展。
在此基础上,云服务、终端、汽车、IoT 和通信网络又进一步将 AI 基础设施的边界从数据中心扩展到整个数字世界。
汪涛表示,人工智能带来的变革之深、之广、之快远超想象,没有任何一家公司能够独自支撑整个智能世界。华为接下来的路线仍然非常明确:聚焦 AI 基础设施,坚持软件开源开放,拥抱“百模千态”,并通过与产业伙伴合作,让算力最终能够触达更广泛的企业、设备和场景。