从「构建 AI」到「驾驭 AI」,100+ 实战案例拆解 AI Native 时代的工程新实践!
推理模型持续突破能力边界,Coding Agent 深度参与研发流程,Agent Runtime、Agent Framework 快速演进……AI 正在从回答问题的模型,演变为能够自主规划、调用工具、执行任务的软件系统。AI 不再只是软件中的一个能力,而开始成为软件系统的一部分。这意味着软件工程面对的挑战也发生了变化:团队需要思考的不再只是如何训练模型、模型、部署模型 或优化 Prompt,而不是如何让具备自主能力的 AI 稳定、可信、可控地运行。模型决定 AI 能做什么,系统决定 AI 能否真正创造价值。
在这一背景下,2026 年 QCon 全球软件开发大会大会 · 上海站正式启动。本次大会将于 10 月 22 日—24 日举办,聚焦 Harness AI 时代的工程实践,围绕 AI Native 架构、Agent Runtime、AI Infra、Data Systems、Agent 安全与可观测、Loop Engineering、Vibe Coding、具身智能与世界模型、端云协同等前沿技术方向,邀请全球技术社区与产业一线的实践者,系统性分享前沿洞察与实战经验,共同探索 AI 从能力到系统、从实验到生产的真实路径。
香港科技大学助理教授袁彬航博士已确认出席 “AI Infra:算力效率决定规模化落地” 专题,并发表题为《让 Agent 越用越强:AReaL 2.0 构建 Agent 在线强化学习闭环》的主题分享。随着 Coding Agent、企业智能助手等 Agent 应用进入真实生产环境,如何让 Agent 在持续使用过程中不断提升能力,成为下一阶段的重要挑战。传统 Agent 系统产生的大量交互轨迹、工具调用记录和用户反馈通常仅用于日志分析,难以转化为模型能力提升的数据闭环。本次分享介绍 AReaL 2.0 如何构建面向 Agent 自演进的在线强化学习基础设施。方案通过 Agent 轨迹协议、数据代理层和演进控制平面,将真实业务交互转化为可训练、可回放、可治理的数据,并通过微服务化 Agent-Compute 架构,实现无需重构原有 Agent 即可接入 Online RL。在 Hermes Agent 和软件工程 Agent 场景中,该方案支持大规模并发环境、异步训练和持续优化,使 Agent 从“一次性执行系统”逐步演进为“持续学习系统”。
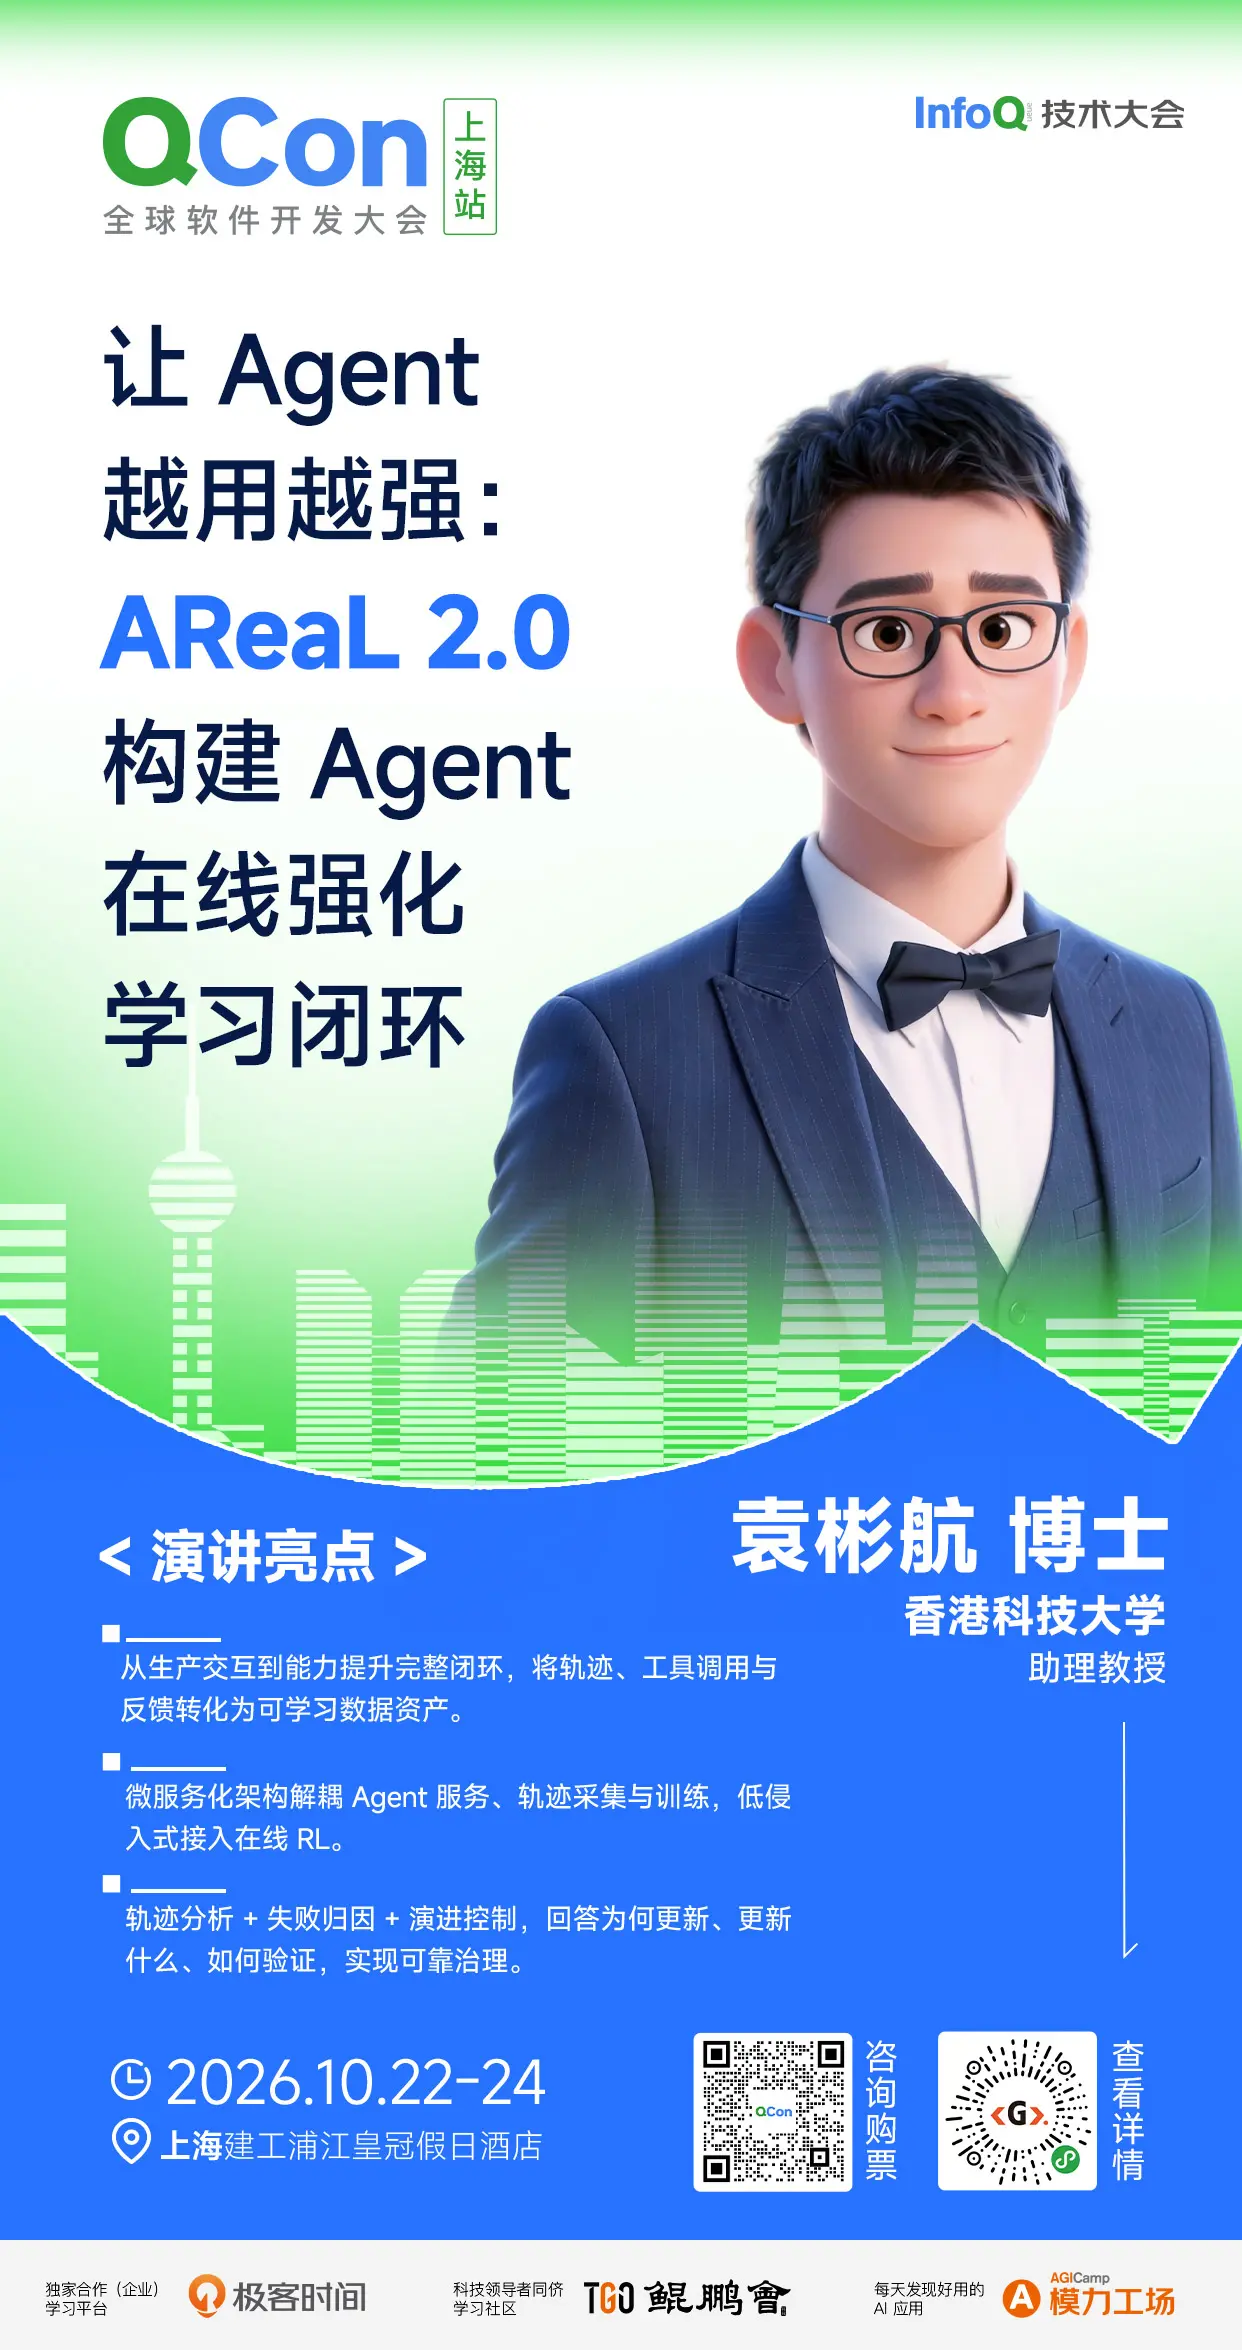
袁彬航博士,香港科技大学(HKUST)计算机科学与工程系(CSE)的助理教授。他在莱斯大学(Rice University)获得博士学位和硕士学位,并在复旦大学获得学士学位。在加入香港科技大学之前,他曾在瑞士联邦理工学院苏黎世分校(ETH Zurich)担任博士后研究员。主要研究方向包括大语言模型服务系统,面向机器学习的数据管理系统,以及分布式和去中心化的机器学习系统。他曾经获得 2019 年 VLDB 最佳论文提名奖,2020 年 SIGMOD 研究亮点奖。他在本次会议的详细演讲内容如下:
演讲提纲:
1. Agent 为什么需要从执行闭环走向学习闭环
分析当前 Agent 在工具调用、任务规划方面的发展,以及真实生产环境中“无法持续变强”的核心问题。
介绍线上 Agent 产生的多轮交互、工具调用、用户反馈等数据为何无法直接用于训练。
2. 面向 Agent 自演进的新型 RL 基础设施设计:
介绍 Agent Trajectory Data Protocol:将传统日志升级为包含状态、动作、反馈、奖励和环境信息的学习轨迹。
介绍 Agentic Data Proxy:解决生产环境中的轨迹采集、权限隔离、数据治理和回放问题。
介绍 Agent Evolution Control Plane:根据失败类型决定优化对象,例如 Memory 更新、Harness 调整或模型 RL 更新。
3. Online RL 微服务化实践:
分享如何通过 Gateway、Router、Data Proxy 和 Agent-Compute Worker 解耦 Agent 服务与 RL 训练系统。
重点介绍低侵入式接入方式:无需重写 Agent workflow,仅替换推理入口即可引入真实交互训练闭环。
4. 实践中的关键踩坑经验:
线上日志不足以支撑 RL,需要设计面向学习的数据协议。
直接在线更新容易造成模型回归,需要结合离线评估、灰度发布和版本回滚。
Agent 失败原因复杂,需要区分 Memory、Tool、Prompt、Model 等不同优化路径。
实践痛点:
首先,Online RL 的最大挑战是稳定性。Agent 的运行环境不断变化,包括用户行为、工具版本和任务分布变化,因此一次模型更新可能提升部分任务,同时导致已有能力退化,需要额外设计回放评估、灰度发布和快速回滚机制。
其次,Reward 设计仍然困难。相比传统 RL 任务,Agent 的成功往往涉及多个维度,例如任务完成率、工具调用效率、成本、安全性和用户满意度。过于简单的奖励容易导致 reward hacking,而过于复杂的奖励又增加系统建设成本。
第三,Agent 自演进并不是单纯更新模型参数。一个完整 Agent 包含模型、Prompt、Memory、Tool、规划策略等多个模块,如何准确定位问题来源,并决定应该优化哪一部分,是实际部署中的关键挑战。
此外,在线学习和生产稳定性存在天然矛盾。快速更新可以提高适应能力,但也会增加业务风险,因此需要在学习速度、系统可靠性和治理成本之间进行权衡。
演讲前沿亮点:
区别于传统 RLHF 或 RLVR 系统主要关注模型训练过程,本方案关注 Agent 从生产交互到能力提升的完整闭环。核心创新在于将真实 Agent 工作流中的轨迹、工具调用和反馈转化为可学习的数据资产,使 Agent 能够基于实际使用经验持续优化。
采用低侵入式 Online RL 接入方式。传统 Agent 强化学习通常需要重新构造环境或开发专门模拟器,与真实业务存在较大差距。本方案通过微服务化架构,将 Agent 服务、轨迹采集和训练系统解耦,使已有 Agent 可以较小改动接入在线学习流程。
强调 Agent 演进过程中的系统治理能力。不仅关注“如何训练更好的模型”,还关注“为什么更新、更新什么、如何验证更新效果”。通过轨迹分析、失败归因和演进控制,实现更加可靠的企业级 Agent 持续优化。
听众收益:本次分享将帮助听众理解 Agent 基础设施发展的下一阶段趋势:从传统的模型调用和工作流编排,进一步发展到能够持续学习和自我优化的智能体系统。技术层面,听众可以了解如何构建 Agent Online RL 闭环,包括轨迹协议设计、生产数据采集、Serving 与 Training 融合、奖励反馈管理以及模型更新流程。工程实践层面,分享将总结真实部署中的关键经验,包括为什么简单日志无法支撑强化学习、为什么在线更新容易导致系统退化、如何通过数据治理和版本管理保障生产稳定性。对于正在建设企业级 Agent 平台的团队,本次分享能够提供一种新的系统设计思路:无需推倒已有 Agent 架构,而是通过基础设施升级,将现有 Agent 转变为具备持续优化能力的学习型系统,为未来构建“越使用越强”的 AI 应用提供参考。
除此之外,本次大会还策划了Loop Engineering、千行百业 Agent 创新实践、Agent 自主进化:从记忆到持续学习、Agent as a Service、Vibe Coding 时代的新质量债、理性驾驭 AI 的 SRE 可靠性工程、金融 AI Native工程实践:从研发提效到业务破局、AI Infra:算力效率决定规模化落地、AI Native 架构等 20 个专题论坛,届时将有来自不同行业、不同领域、不同企业的 100+资深专家在现场带来前沿技术洞察和一线实践经验。
查看更多详情可扫码或联系票务经理 18514549229 进行咨询。