【TechWeb】9月17日,华为轮值董事长徐直军在全联接大会2026上宣布,正式发布AI时代全新计算架构——Peerium。这套架构可实现百万级处理器作为一台计算机协同工作,以应对不断攀升的AI算力需求,并宣称在编程模型、系统架构和互联拓扑三个层面,同时突破图灵范式与冯·诺依曼单机架构的限制。
要理解Peerium的意义,需先回到计算机体系结构的"出厂设定"。冯·诺依曼体系结构要求计算机按程序顺序执行,运算器、控制器、存储器、输入与输出系统各司其职,主从关系贯穿其中;从ENIAC到当下最先进的消费级与企业级计算机,几乎全部沿用这一架构。然而在AI大模型时代,程序顺序执行的假设与超大规模并行计算的需求之间的矛盾日益尖锐——业界数据显示,十万卡规模的AI集群有效算力利用率目前仅约两成,互联通信正是主要瓶颈。
针对这一痛点,Peerium架构的核心设计可概括为三句话:基于嵌套并行实现计算任务的分层递归组织;通过统一内存寻址让百万级处理器共享同一地址空间;以全节点平等互联取代传统的主从层级。该架构同时提出Nested BSP(嵌套批量同步并行,一种将并行计算任务分层递归组织的计算范式)编程模型,突破传统图灵范式的限制。用华为的说法,百万级处理器由此不再是多台独立计算机的简单叠加,而是"真正成为一台更大的计算机"。
支撑Peerium落地的关键,是基于开放协议的灵衢(UnifiedBus)高速互联总线——它可无限扩展地联接CPU、NPU、内存、SSD、网卡和交换机,实现计算、存储与网络的平等互联。
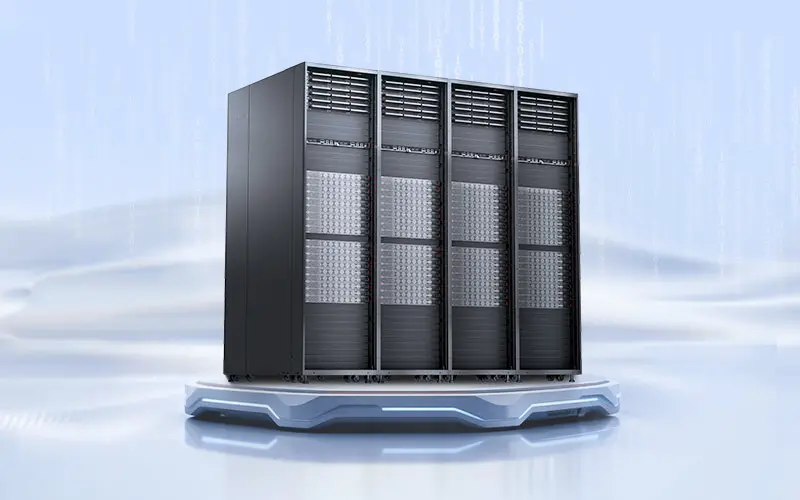
技术细节上,灵衢将十余种互联协议统一归一,互联带宽从百GB级提升至TB级,RTT通信时延从7微秒压缩至2微秒,并支持超节点内全局内存统一编址。在设备层面,柜内灵衢互联刀片实现零电缆、零电路损耗,一个4096超节点可节省196公里铜缆;跨柜灵衢互联设备支持176个端口、每端口1.6T,单机280T全光互联;星河UBG网络交换机具备1024路Radix扇出能力,可支撑百万卡超节点集群,满足模型参数向几十万亿演进的需求。
商用化进程方面,Atlas 950超节点是Peerium计算架构的首代产品,25.6万卡Atlas 950超节点集群已在部署中;下一代基于NPO技术的Atlas 960系统目前正处于测试阶段。
值得注意的是,华为还将灵衢架构延伸至中小规模场景,推出1卡到8卡系列化一体机及鲲鹏昇腾模组,其中Atlas 650E风冷服务器通过双机灵衢直连实现16个NPU免交换互联,"两台机器像一台一样运行",支持中小企业本地运行万亿参数大模型。
徐直军表示:"AI时代,华为基于开创的Peerium计算架构,持续打造满足客户训练和推理需求的超节点和集群,让算力无处不在,让智能无所及。"
把视野放大,Peerium与灵衢的发布,将AI算力竞争的重心上移了一层——单芯片性能之外,互联协议的归一程度、跨节点通信时延和资源池化能力,开始决定集群的有效算力。英伟达GB200 NVL72将72颗GPU接入同一个NVLink算力域、可扩展至576颗,被视为同一路线的另一种实现;华为的做法则是把协议层统一为灵衢并对外开放,设备谱系从8卡一体机延伸到百万卡集群。
不过,这场架构革命仍面临待解课题:存量系统向灵衢迁移的成本与周期、新产品的价格与上市节奏、百万卡集群对昇腾960等后续芯片按期就绪的依赖,以及Nested BSP编程模型能否获得足够广泛的开发生态支持,都需在真实的客户环境中逐步检验。