作者 | Jürgen Schmidhuber
翻译 | 林绮蓓
最近一段时间,RSI(递归自我改进)成为人工智能领域的热门话题。
近期,OpenAI 首次通过内部量化数据,系统披露 RSI 项目的实际推进情况;谷歌团队又发布论文《Deam-RSI:通过演化世界实现递归自我改进》,提出了一种新的递归式自我改进框架。
随着众多大模型公司纷纷加码 RSI,围绕这一方向的讨论也持续升温,有不少人发出警告的声音。
OpenAI 首席科学家 Pachocki 发文指出,RSI 可能成为未来科学发现的核心路径;但他认为目前尚无任何实验室真正解决 AI 对齐问题,并呼吁在推进相关研究的同时放缓步伐、建立统一的安全标准。
就在这一背景下,被誉为“现代人工智能之父”的 Jürgen Schmidhuber 发布了一篇长文,系统回顾并详细披露了自己研究 RSI 的历程。
文章中,作者系统梳理了几条主要研究路线:1987 年的元进化与元强化学习;1994 年以来基于自修改策略的强化学习;1991—1992 年通过快速权重和自指神经网络实现的神经网络元学习;2002 年提出的能够复用既有知识、逐步解决新问题的 OOPS 课程学习方法;以及 2003 年提出的,在数学意义上实现自我改进最优性的 Gödel Machine。此外,文章还讨论了人工好奇心、内在动机与 RSI 的结合,以及近年来快速权重、MetaGenRL、VS-ML、SRWM 和基于 LLM 的 Gödel Machine 等进展。
Jürgen Schmidhuber 最后强调,软件层面的自我改进只是 RSI 的一部分。如果要实现真正的人工智能,必须将其与机器和机器人所处的物理世界结合起来。
Sakana AI 的联合创始人兼首席执行官 David Ha 转发文章并表示,当前大模型头部实验室所谓的引领前沿的技术措施并非能够真正的提供安全保障。当下真正的风险也并非是超级智能,而是两家公司控制前沿人工智能技术带来的权力的集中。他认为唯一真正保障的,是建立一个健康的独立实验室生态系统和强大的开源社区。
以下是 Jürgen Schmidhuber 发布的文章内容:
递归自我改进(RSI),始于 1987 年
摘要
截至 2026 年,包括 Anthropic、OpenAI、Sakana AI 和 SpaceX 在内的每个人都在讨论递归自我改进(Recursive Self-Improvement,RSI)或元学习(Meta Learning,即“学习如何学习”),一些初创公司甚至明确将自己定位为 RSI 企业。然而,RSI 的历史远比这更为久远。
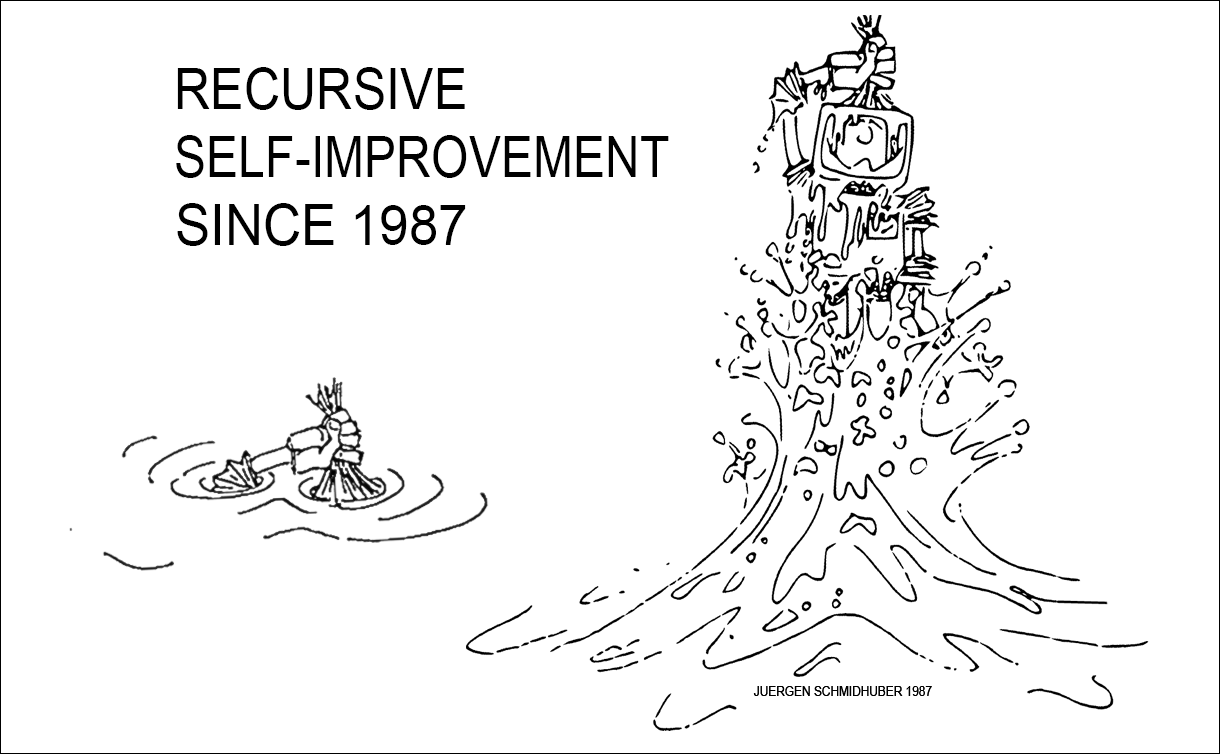
1987 年,当时的计算成本约为今天的 10⁸倍,我在毕业论文中发表了第一批具体的 RSI 算法。我还为论文封面绘制了一个能够自我引导程序的机器人形象(见上图)。该论文是我长期开展 RSI 研究的一系列成果中的第一篇。这一研究方向在 2010 年代逐渐受到广泛关注, 2020 年代则更甚。
本文总结了我们在以下方面开展的 RSI 研究:自 1994 年以来关于具有自修改策略的强化学习(RSI)的研究;自 1992 年以来基于梯度下降的人工神经网络中的 RSI 研究;自 2002 年以来针对课程学习的渐近最优 RSI;自 2003 年以来通过自指性的 Gödel Machine 实现数学上最优的 RSI; 自 1990 年/1997 年以来,将 RSI 与人工好奇心和内在动机相结合的研究;以及 2020 年以来有关 RSI 的最新研究。 另请参阅有关 RSI 的视频推文。
如今,计算成本已经大幅下降,基于软件的 RSI 也变得切实可行。然而,要实现完整意义上的 RSI,仅有能够自我改进的软件还不够,还需要现实物理世界中能够自我改进的硬件。
目前,应用最广泛的机器学习算法大是由人类发明和设计的。那么,我们能否构建元学习算法,使其能够学习更好的学习算法,从而构建真正意义上的自我改进型人工智能,而不受计算能力和物理极限之外的任何限制?自 1987 年围绕这一主题撰写毕业论文以来,这个问题一直是推动我开展研究的重要动力。
首先需要指出的是,元学习有时会被误认为只是将一个训练集上学到的知识迁移到另一个训练集上(参见 N(eur)IPS 2016 演示文稿)。然而,即便是标准的深度前馈神经网络(NN),也可以通过在其他图像数据集上进行预训练,更快地学会识别新的图像,从而实现迁移学习,例如 [TRA12] 所示。
真正的元学习和 RSI 远不止于此,也远不止于学习调整进化策略中的突变率等超参数。
真正的 RSI,意味着使用一种通用编程语言来编码初始学习算法,例如将其编码在循环神经网络(RNN)中,并赋予其能够以任意可计算方式修改自身代码的基本指令。随后,我们再用一个递归框架包围这段具有自指性、能够自我修改的代码,确保只有“有用的”自我修改才能够保留下来,例如本文第 2 节和第 5 节所述的机制。
元学习可能是机器学习领域最具雄心、同时也最值得投入的目标之一。一个优秀的元学习系统能够学会任何东西。在适当情况下,它可以通过类比、组块化、规划、生成子目标,或将这些方式结合起来进行学习——只要能够想到的学习方式,都有可能成为其学习对象。
1、元进化与 PSALMs(1987)
1987 年,我们发表了 [GP87][GP]。据我所知,这是第一篇关于遗传编程(Genetic Programming,GP)的论文之一,研究如何在通用编程语言中进化生成任意长度的程序。
同年,我的毕业论文第 2 节进一步将这种遗传编程方法应用于其自身,使其能够递归地进化出更优的遗传编程方法。该系统不仅包含一个元层级,还包含元元层级、元元元层级,依此类推。我将这种 RSI 方法称为元进化(Meta Evolution)。
毕业论文的第 4 节还提出了用于收益最大化或强化学习(Reinforcement Learning,RL)的元学习机制,即原型式自指关联学习机制(Prototypical Self-Referential Associating Learning Mechanisms,PSALMs)。这是元元强化学习,或者说基于强化学习的 RSI 的一种早期形式。
这项工作将 I. J. Good 在 1966 年关于通过自我改进的“超级智能”产生“智能爆炸”的非正式推测性论述具体化了。需要指出的是,Good 当时并没有提出具体的 RSI 算法。此外,这项工作也与 Bellman 在 1967 年关于“元策略(metapolicies)”的思考有关。
https://people.idsia.ch/~juergen/genetic-programming-1987.html
2、基于自修改策略强化学习的 RSI(1994 年至今)
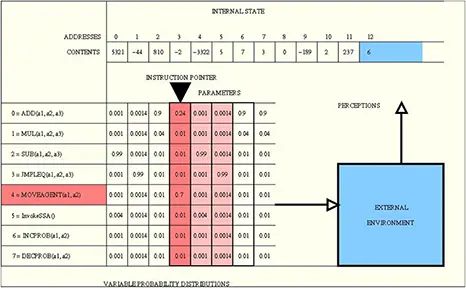
1994 年,我提出了另一种元强化学习或 RSI 形式,称为增量式自我改进(Incremental Self-Improvement) [METARL2],适用于具有单一生命周期(即一次终身试验)的通用强化学习机器。
也就是说,与传统强化学习不同,该方法不假设存在可重复且相互独立的试验,强化学习智能体也不会被重置。它由一个自修改策略(Self-Modifying Policy,SMP)驱动。
SMP 是一种可修改的概率分布,其对象是使用通用编程语言编写的程序,因而能够执行任意计算。SMP 的学习算法本身就是 SMP 的组成部分——换言之,SMP 不仅能够修改自身,还能够修改“修改自身的方式”。
在这种情况下,信用分配过程必须考虑到:早期的自我修改会为后续的自我修改创造条件、奠定基础。
一种称为环境无关的强化加速(Environment-Independent Reinforcement Acceleration,EIRA),或称成功故事算法(Success-Story Algorithm)的方法,会促使 SMP 不断提出更优的自我修改算法,持续提高单位时间内获得的奖励。
尽管当时的计算成本约为今天的 10 万倍,这种方法在具有挑战性的实验中仍然取得了良好效果。
相关内容可参见 2003 年的演讲幻灯片,或 N(eur)IPS 2018 年研讨会的概览幻灯片,以及有关 RSI 的视频推文。
https://people.idsia.ch/~juergen/rsi2016white.pdf
3、基于梯度的 RSI 在学习编程其他神经网络(1991)和自身的神经网络(1992)中的应用
正如我自 1990 年以来经常指出的那样,人工神经网络(NN)的连接强度或权重,应当被视为其程序。
受到 Gödel 的通用自指形式系统启发,我构建了这样一类神经网络:其输出为其他神经网络的程序或权重矩阵。这类网络被称为快速权重编程器(Fast Weight Programmers,FWP)。
我甚至构建了具有自指能力的循环神经网络(RNN),使其能够运行并检查自身的权重变化算法或学习算法 。
与 Gödel 的通用编程语言不同的是,我的通用编程语言并非基于整数,而是基于实数值权重,使得每个神经网络的输出可相对于其程序是进行求导。这意味着,一个简单的程序生成器便能够在程序空间中计算出一个方向,沿着这个方向可能找到更好的程序 ,尤其是更好的程序生成程序。自 1989 年以来,我的大量研究都利用了这一事实。
深度架构中的成功学习可以追溯到 1965 年。当时,Ivakhnenko 和 Lapa 发表了第一批通用且能够实际运行的深度多层感知器学习算法,这些网络可以包含任意数量的隐藏层。这些网络已经包含了如今广受关注的乘法门机制 ,而这种机制后来成为动态连接神经网络或快速权重网络的重要组成部分。
1981 年,von der Malsburg 首次明确强调了具有快速变化连接的神经网络的重要性,随后也有其他研究者开展了相关工作。
不过,在此之前,这些研究尚未实现一种能够通过梯度下降进行学习、并且能够快速操纵快速权重存储的端到端可微分系统。我于 1991 年发表了这样一种系统:在这个系统中,一个慢速神经网络学习控制另一个快速神经网络的权重变化。换言之,我以完全神经网络化的方式,将存储与控制分离开来,这与传统计算机中的存储和控制分离相似,但并不是采用混合式架构。(相关研究还包括如今有时被称为“合成梯度”的工作。)
随后,我进一步展示了快速权重如何用于 RSI,或者说“学习如何学习”。在 1992 年以来的相关文献中,慢速 RNN 和快速 RNN 是同一个网络。该 RNN 能够看到自身的误差或奖励信号,这些信号在图中被称为 eval(t+1)。每条连接的初始权重通过梯度下降进行训练;而在训练过程中,每条连接都可以由 RNN 自身通过 O(log n) 个特殊输出单元进行寻址、读取和修改,其中 n 表示连接数量。相关变量包括图中的时间相关向量 mod(t)、anal(t)、Δ(t) 和 val(t+1)。
也就是说,每条连接的权重都可以快速变化。该网络因此具备自指性:从原则上说,它能够在自身上运行任意可计算的权重变化算法或学习算法,即针对其全部权重执行学习。
这就是面向神经网络的递归自我改进。
1991—1993 年间,我通过基于梯度下降、利用二维张量或外积更新来主动控制快速权重,从而对这一方法进行了简化。这样做的一个动机,是希望在大规模并行、端到端可微分的控制条件下,管理更多的时间变量。与相同规模的标准 RNN 相比,这种方法能够处理 O(H²) 而非 O(H) 数量级的变量,其中 H 为隐藏单元的数量。
1993 年的论文 [FWP2] 还明确讨论了如何在端到端可微分网络中学习内部注意焦点。
具有线性化自注意力机制的非归一化 Transformer,在形式上等价于我于 1991 年提出的基于外积的快速权重编程器。如今,这类架构被称为非归一化线性 Transformer(unnormalized linear Transformers)。ChatGPT 中的 Transformer 也与此有关。
2001 年,我的前博士生 Sepp Hochreiter 在 LSTM 网络中使用梯度下降 [LSTM1],而不是传统 RNN,来进行元学习,使其能够针对非平凡函数类别学习快速的在线学习算法。例如,该系统能够学习二元二次函数。
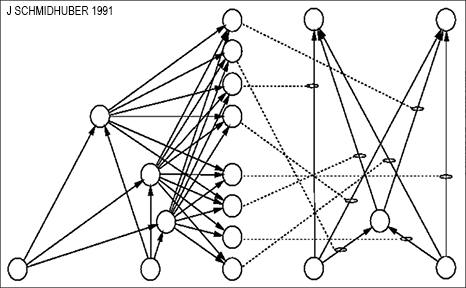
https://people.idsia.ch/~juergen/FKI-147-91ocr.pdf
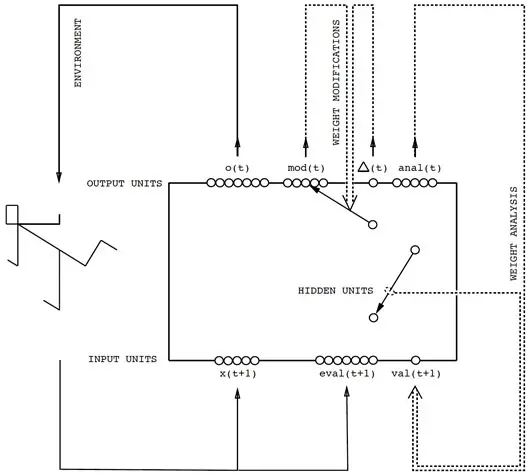
https://people.idsia.ch/~juergen/selfref1992.pdf
4、渐近最优的课程学习 RSI(2002 年至今)
2002 年,我提出了一种通用且渐近时间最优(asymptotically time-optimal)的课程学习方法(curriculum learning),即逐个解决问题:高效地搜索能够计算出候选解的程序空间,其中也包括那些能够以可计算的方式组织、管理、调整和复用此前获得知识的程序。
最优有序问题求解器(Optimal Ordered Problem Solver,OOPS)受到了 Levin 设计的针对单个问题的通用搜索算法(Universal search)的启发。OOPS 会将总搜索时间的一部分用于新问题,测试那些能够以可计算方式利用此前用于计算解决方案的程序的程序。
它会将新问题的总搜索时间的一部分用于测试那些以可计算方式利用先前求解程序的程序。如果通过复制、编辑或调用已有代码来解决新问题,比从头开始解决更快,那么 OOPS 就能够发现这一点;如果不能,至少此前的解决方案也不会造成太大损害。
我还提出了一种高效的、递归的、基于回溯(backtracking)的 OOPS 实现方法,使其能够在存储空间有限的现实计算机上运行。实验展示了 OOPS 如何从元学习(meta learning)或元搜索(meta searching)中获得巨大收益。这里的元学习或元搜索,指的是以递归自我改进(RSI)的方式,寻找更快速的搜索过程。图片展示的是我在 2003 年 N(eur)IPS 会议上关于 OOPS 的海报。
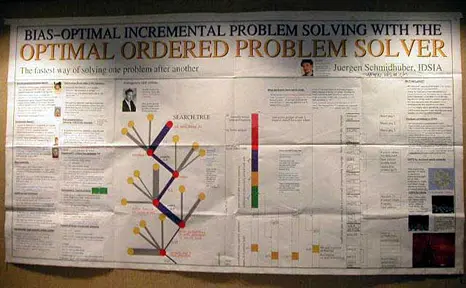
https://people.idsia.ch/~juergen/oops.html
5、最优 RSI:能够自我改进的 Gödel Machine(2003 年至今)
第 2 节所介绍的自指式 RSI 系统(1994 年至今),通过后续奖励加速的统计证据来证明自我改进具有合理性。然而,这种方法并不能保证执行理论上最优的自我改进。这促使我提出了 Gödel Machine。它是第一个在某种数学意义上真正实现最优性的、完全自指的通用 RSI 机器 。在通常情况下,它会使用相对而言通用性较弱的 OOPS 来寻找能够被证明为最优的自我改进方案。
RSI Gödel Machine 的灵感受到 Kurt Gödel 的启发。Kurt Gödel 是 20 世纪 30 年代初理论计算机科学的奠基人。他引入了一种以整数为基础的通用编码语言,可以用公理化的形式描述任何数字计算机的运算;他还利用这种语言同时表示数据(例如公理和定理)和程序(例如对数据执行操作、生成证明的操作序列)。此外,他还构造了著名的能够谈论其他形式命题的形式陈述,尤其是自指陈述。这些陈述表明,其真值无法通过任何计算性定理证明器来判定。由此,Kurt Gödel 揭示了数学、定理证明、计算以及人工智能所面临的一些根本性限制。这一工作对 20 世纪的科学和哲学产生了巨大影响。此外,20 世纪 40—70 年代的早期人工智能研究,在很大程度上也围绕 Gödel 式的定理证明和演绎展开,例如专家系统和逻辑编程等。
https://people.idsia.ch/~juergen/goedelmachine.html
Gödel Machine 是一种通用强化学习机器。当它找到某个证明,能够证明修改自身代码的某种方式是有益的时,它就会重写自身代码的相应部分。其中,与具体问题相关的效用函数、硬件以及完整的初始代码,都通过公理进行描述;而这些公理被编码在初始证明搜索器中,该搜索器本身也是初始代码的一部分。机器在与环境交互的过程中,最初可能采用次优的运行方式。与此同时,证明搜索器会系统地、高效地测试各种可计算的证明技术,即那些输出证明的程序,直到找到一个能够被证明有益的、可计算的自我重写方案。
我证明了这种自我重写具有全局最优性——不存在局部最大值。因为代码首先必须证明继续搜索替代自我重写的证明过程并无益处。与以往将证明搜索器预先固化的非自指方法不同,Gödel Machine 不仅拥有最优的复杂度阶,还能在任何 O()符号所隐藏的性能下降中实现最优优化,前提是此类提速的效用是完全可被证明的。
https://people.idsia.ch/~juergen/gmfaq.html
6、RSI 与人工好奇心、内在动机的结合(1990 年、1997 年至今)
在继续讨论元学习和 RSI 之前,我先解释一下带有内在动机的强化学习。
我于 1990 年提出的对抗式人工好奇心(Adversarial Artificial Curiosity)原理,如今不仅广泛用于强化学习中的探索,也被应用于图像生成。
其基本机制如下:
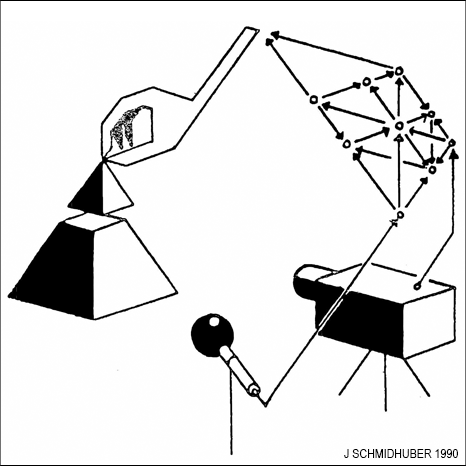
一个神经网络(控制器)以概率方式生成输出;另一个神经网络(世界模型)接收这些输出,并预测环境对这些输出的反应。通过梯度下降,世界模型神经网络试图最小化自身的预测误差,而生成器神经网络则试图生成能够最大化该误差的输出。也就是说,一个网络的损失就是另一个网络的收益。因此,控制器会受到内在动机驱动,主动生成某些行动或实验,使其产生的数据(GAN 是这种情况的一个特例,其中环境根据生成器的输出是否在给定的集合中简单地返回 1 或 0。
https://people.idsia.ch/~juergen/who-invented-generative-adversarial-networks.html
[AC90](1990)中的“与元学习的联系”一节已经指出:模型网络不仅可以用于预测控制器的输入,还可以用于预测控制器未来的输出。这种理想的模型可以模拟控制网络内部的变化。预测控制器的演化,从而预测梯度下降过程本身所产生的效果。在这种情况下,模型网络中的激活流就能够模拟控制网络的权重变化。这与“学习如何学习”的概念又非常的接近。
[AC90] 还提出了使用循环神经网络作为世界模型进行规划,并引入了高维奖励信号。与传统强化学习不同,这些奖励信号也被用作控制器神经网络的输入,使其能够学习执行最大化累积奖励的行动。这一点对于元学习非常重要:如果一个神经网络无法观察自身的错误或奖励,就无法学习如何更好地利用这些信号,并据此形成由自身发明的学习算法。
https://people.idsia.ch/~juergen/FKI-126-90ocr.pdf
几年之后,我将第 2 节所述的 RSI 强化学习系统与对抗式人工好奇心整合到了同一个系统中。该系统以程序的形式生成计算实验,而这些程序的执行可能同时改变外部环境和强化学习智能体的内部状态。每个实验都有一个二元结果:某种特定效果要么发生,要么不发生。
这些实验由两个以奖励最大化为目标的对抗性策略共同提出。两个策略都可以在实验发生之前预测并押注实验结果。当实验结果实际被观察到之后,预测成功的一方将获得与其押注金额成比例的正奖励,而失败的一方则获得等额的负奖励。因此,每个策略都会受到激励,去设计那些能够让另一个策略感到意外的实验。而另一个策略则会受到激励,去学习此前尚不了解的世界知识,从而避免再次被对方出其不意地击败。通过结合使用带有自我修改策略的 RSI ,该系统能够学习何时学习以及学习什么。
此外,只要两个“智能体”在每执行一个计算步骤时都获得少量负奖励,系统还会倾向于降低学习新技能的计算成本。这种机制会促使系统偏向于设计简单但仍然具有新颖性的实验,即那些反映简单但尚未解决的问题的实验。这可能有助于分层构建越来越复杂的实验,其中一些实验还可能产生外部奖励(如果存在外部奖励的话)。事实上,这种人工智能创造力不仅可能推动人工智能科学家和艺术家的发展,还可能加速外部奖励的获取。这直观地表明,对世界有更深入的理解有助于更快地解决某些问题。
2011 年提出的、较新的内在动机强化学习系统 PowerPlay ,可以利用元学习方法 OOPS,持续自主发明新的目标和任务,并以主动、部分无监督或自监督的方式逐步学习,成为更加通用的问题解决者。2015 年,具有高维视频输入和内在动机的强化学习机器人,例如采用 PowerPlay 思想的系统,已经能够开展探索学习。
7、关于 RSI 与元学习的近期研究(2020 年至今)
我的前博士生 Imanol Schlag 等人使用关联快速权重记忆 (FWM) 增强了 LSTM。
在给定输入序列的每一个步骤中,LSTM 都通过可微分操作更新并维护存储在快速变化的 FWM 权重中的、由多个组成部分构成的关联信息。该模型通过梯度下降进行端到端训练,并在组合式语言推理、小规模词级语言建模,以及部分可观测环境中的元强化学习(EML)任务中取得了出色表现。
我们于 2020 年提出的 MetaGenRL,能够元学习适用于训练环境之外、且与训练环境存在显著差异的新型强化学习算法。MetaGenRL 搜索的是能够描述这类学习算法的低复杂度损失函数空间。相关内容可参见我的前博士生 Louis Kirsch 撰写的博客文章。这种搜索简单学习算法的思想同样适用于快速权重架构。
我们近期提出的可变共享元学习(Variable Shared Meta Learning,VS-ML),将权重共享与稀疏性结合到了 RSI RNN 中。这种方法使得学习算法可以仅用少量参数进行编码,即使系统包含大量随时间变化的变量。
VS-ML 将端到端可微分的快速权重,与编码在 LSTM 激活状态中的学习算法结合起来。其中,一些激活值可以被解释为由 LSTM 动态更新的神经网络权重。具有共享稀疏矩阵项的 LSTM,能够发现可以泛化到新数据集的学习算法。这些通过元学习获得的学习算法不需要显式计算梯度。RNN 中的 VS-ML 甚至能够学习实现著名的反向传播学习算法,而且完全通过 RNN 的端到端可微分前向动力学实现。
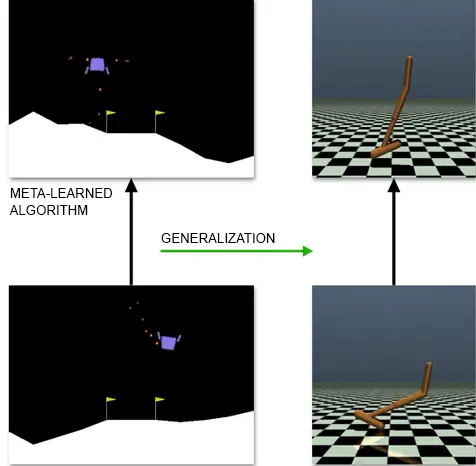
https://louiskirsch.com/metagenrl
2022 年,我们还在 ICML 上发表了一种现代化的自指权重矩阵(Self-Referential Weight Matrix,SRWM) [FWPMETA8]。该方法建立在 1992 年提出的 SRWM 基础之上。从原则上说,它能够进行元学习,甚至能够进行元元学习,依此递归下去,这正是递归自我改进的含义之一。我们在有监督的小样本学习任务,以及使用程序生成游戏环境的多任务强化学习任务上,对 SRWM 进行了评估。实验结果表明,SRWM 具有实际应用价值,并取得了具有竞争力的性能。
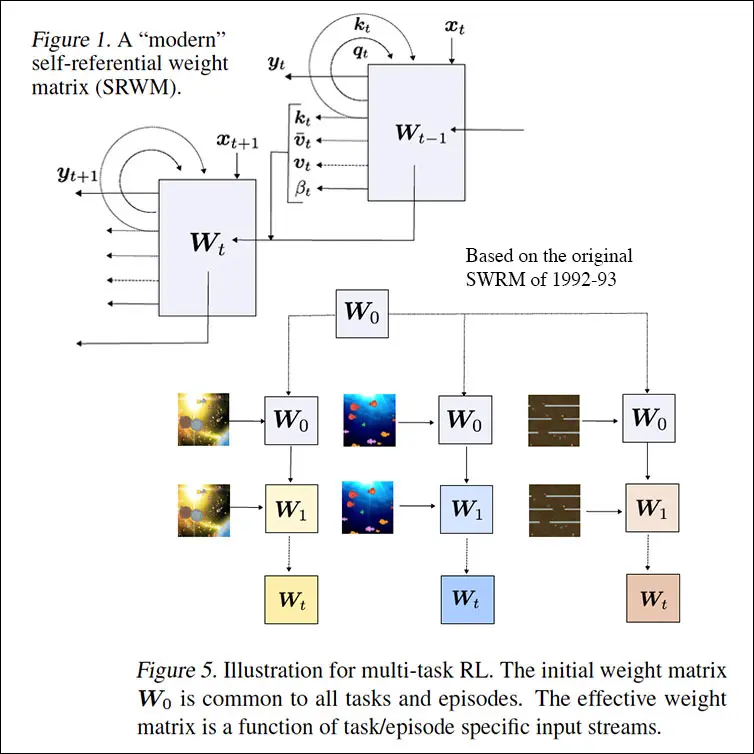
https://arxiv.org/abs/2202.05780
近年来,关于元学习和 RSI 的研究聚焦于受到 Gödel 启发的基于大语言模型(LLM)的方法上,例如,Sakana AI 开发的 Darwin-Gödel Machine,以及 Huxley-Gödel Machine 和 Red Queen Gödel Machine。另见我们于 2026 年发表的综述 [RSI26]。
如今的计算成本相比上个世纪已经大幅下降,越来越多的公司开始关注元学习和 RSI,例如 Sakana AI、Ricursive、Recursive Superintelligence、Anthropic、OpenAI、Inherent 等。
8、大语言模型的“上下文学习”是元学习的一种特殊形式
在一定程度上,近年来的大语言模型(LLM)能够从不断累积的用户交互记录中学习,而无需在测试阶段通过梯度下降改变底层预训练 Transformer 神经网络的权重。这种被称为上下文学习(In-Context Learning)和测试时训练(Test Time Training)的机制,可以被视为元学习的一种特殊形式。
它与 1991 年提出的非归一化线性 Transformer ,以及 2001 年提出的元学习 LSTM 具有相似之处。后者通过梯度下降学习了一个针对二次函数的学习算法,该算法的速度远快于梯度下降本身,而且在测试阶段无需执行额外的权重更新。
从更一般的意义上说,梯度下降可以用来学习一个运行在神经网络自身之上的学习算法。1992 年的研究 已经展示了这一点。许多元学习系统实际上是在学习如何编程和操纵快速权重,Transformer 也是如此,包括 1991 年提出的非归一化线性 Transformer 。
9、完整的 RSI 需要能够自我改进的硬件
以上关于 RSI 的讨论主要集中在能够自我改进的软件上。然而,正如我此前指出的 [DLH],如果要实现真正的人工智能,仅仅开展软件层面的研究是不够的,还必须将其与机器和机器人所处的物理世界结合起来。
如果不能掌握现实世界,就不可能实现超级人工智能(Artificial Super Intelligence,ASI)。
Gödel Machine 已经考虑到了这一点。最后,我想以我在 X 中发布的一段话结束本文。这段话建立在更早期的相关出版物之上:
几个世纪以来,人类一直在讨论物理自我复制机器(Self-Replicating Machines,SRMs)。17 世纪的 Descartes、19 世纪的 Eliot 和 Butler、20 世纪 20 年代的 Capek,以及自 20 世纪 40 年代以来的 von Neumann、Zuse、Penrose 等人,都曾对此进行过探讨。
然而,尽管能够自我复制并自我进化的软件几乎很容易实现(例如计算机病毒)。但长期以来,没有人知道如何在实践中构建通用的物理自我复制机器。
不过,如今似乎已经存在一种显而易见的路径:由人工智能控制的通用机器人,可以学习操作目前由人类操作的各种机器和工具。这些机器人也将能够建造、操作和维修生产更多同类机器人的设备。
这包括从地下开采原材料的机器、提炼材料的设备、将零件组装起来的机器、维修损坏的 3D 打印机和机器人以及机器人生产工厂等。换言之,它们能够完成目前所有需要由操作机器的人类来完成的物理工作。
从根本上说,这将形成一种机器文明:它能够在不依赖操作机器的人类的情况下实现自我复制,并进一步实现自我改进。
这就是能够自我改进的硬件,它不同于已经存在的、能够自我改进的元学习软件。
我将其称为终极形式的扩展(ultimate form of scaling)。
参考链接:
https://people.idsia.ch/~juergen/recursive-self-improvement.html
https://x.com/hardmaru/status/2100411291836018812