出品 | 网易智能
作者 | 小扣
编辑 | 王凤枝
Claude已经能“主导”Anthropic四分之一的AI研发,但完全自主完成的工作仍是零。
9月18日消息,Anthropic首次公布内部测量结果:今年2月,Claude能够“主导”的AI研发任务还不到1%;到8月,已经升至26%。超过90%的研发任务至少达到“协作”级:在人密切指导下,AI已经可以完成大块工作。
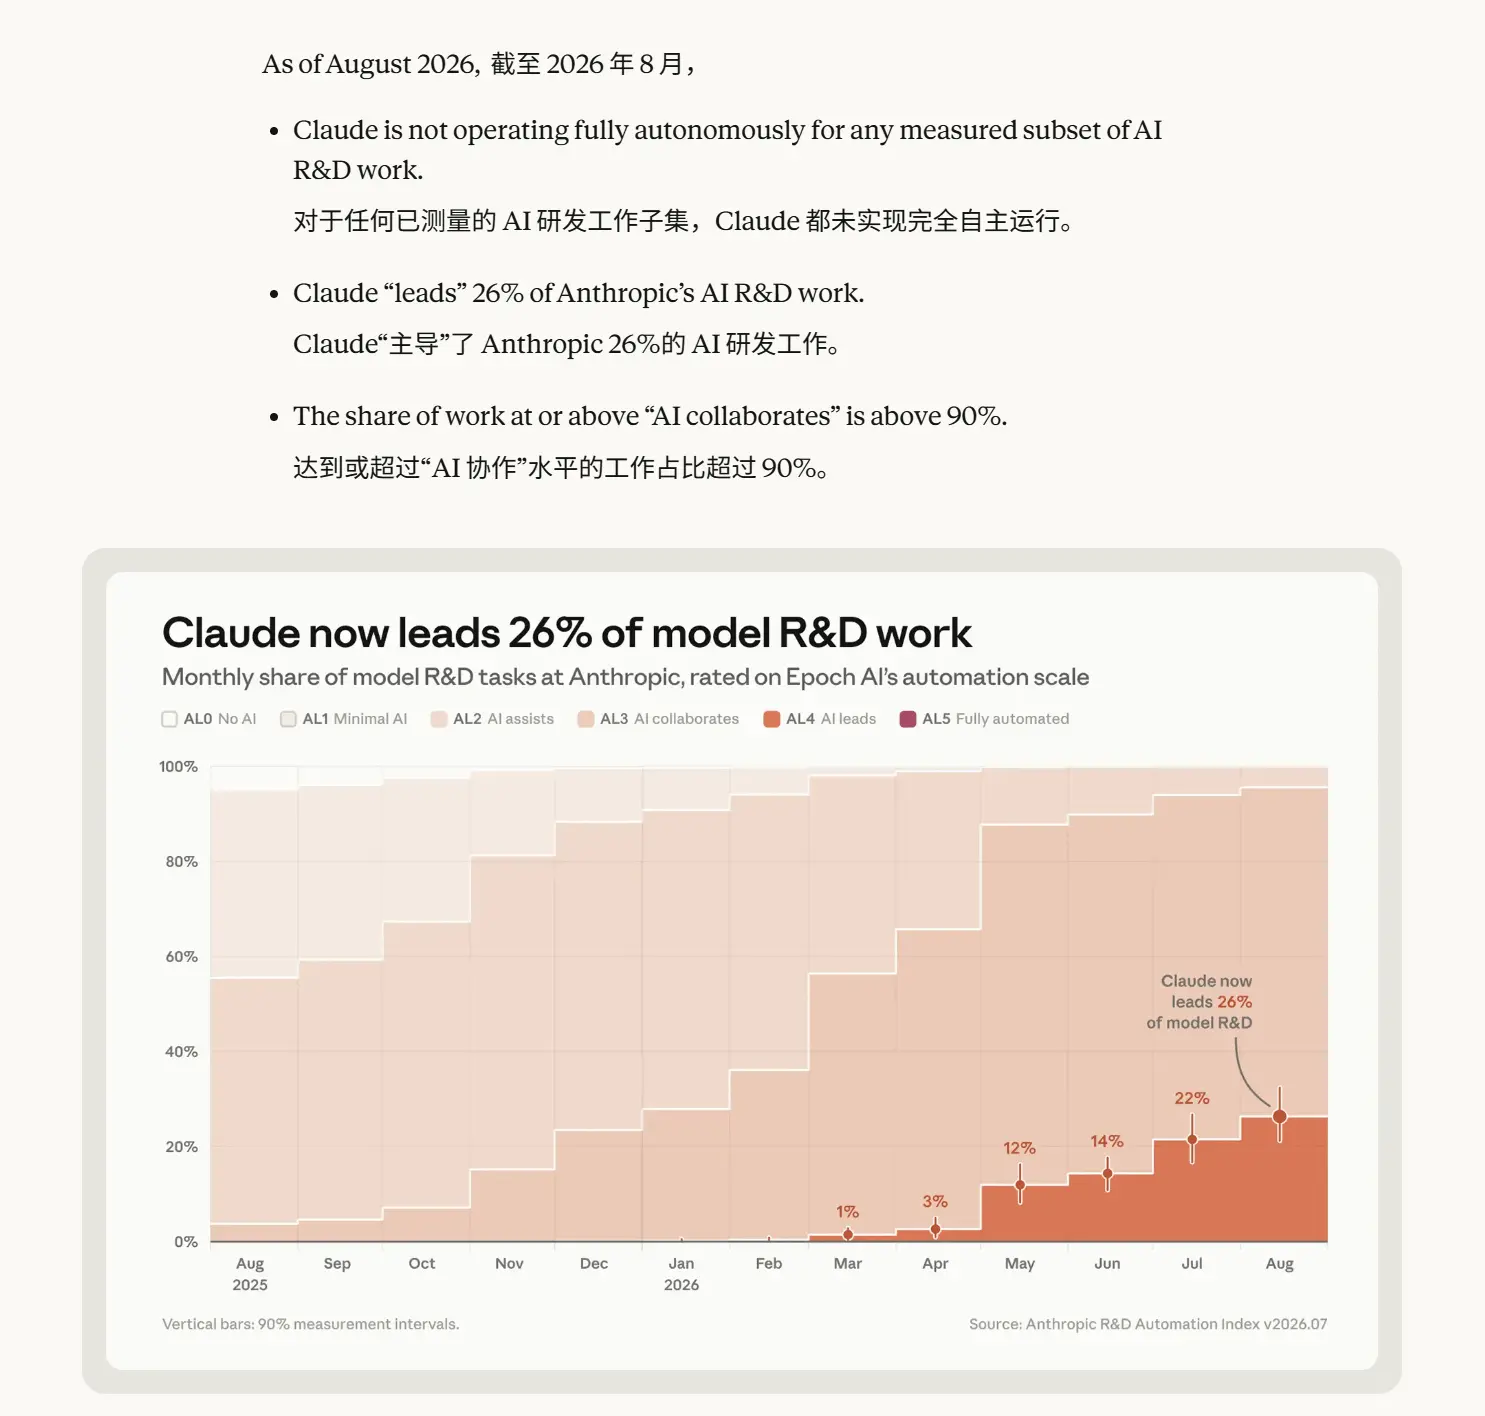
Anthropic所说的“主导”,指的是研究员给出高层目标,Claude完成大部分任务,再交给人监督和验收。
对Anthropic来说,让AI接手具体任务只是第一步。更关键的问题是,它能否走向递归式自我改进(RSI):AI开发出更强的继任者,再由继任者加快下一轮研发。26%记录的是任务自动化走到了哪里,还不能说明这套循环已经开始提速。
一、26%不是研发贡献率
这26%来自一套六级自动化标准。Anthropic采用了研究机构Epoch AI提出的AL0至AL5:最低的AL0完全由人完成,最高的AL5则由AI自主工作,全程不需要人介入。
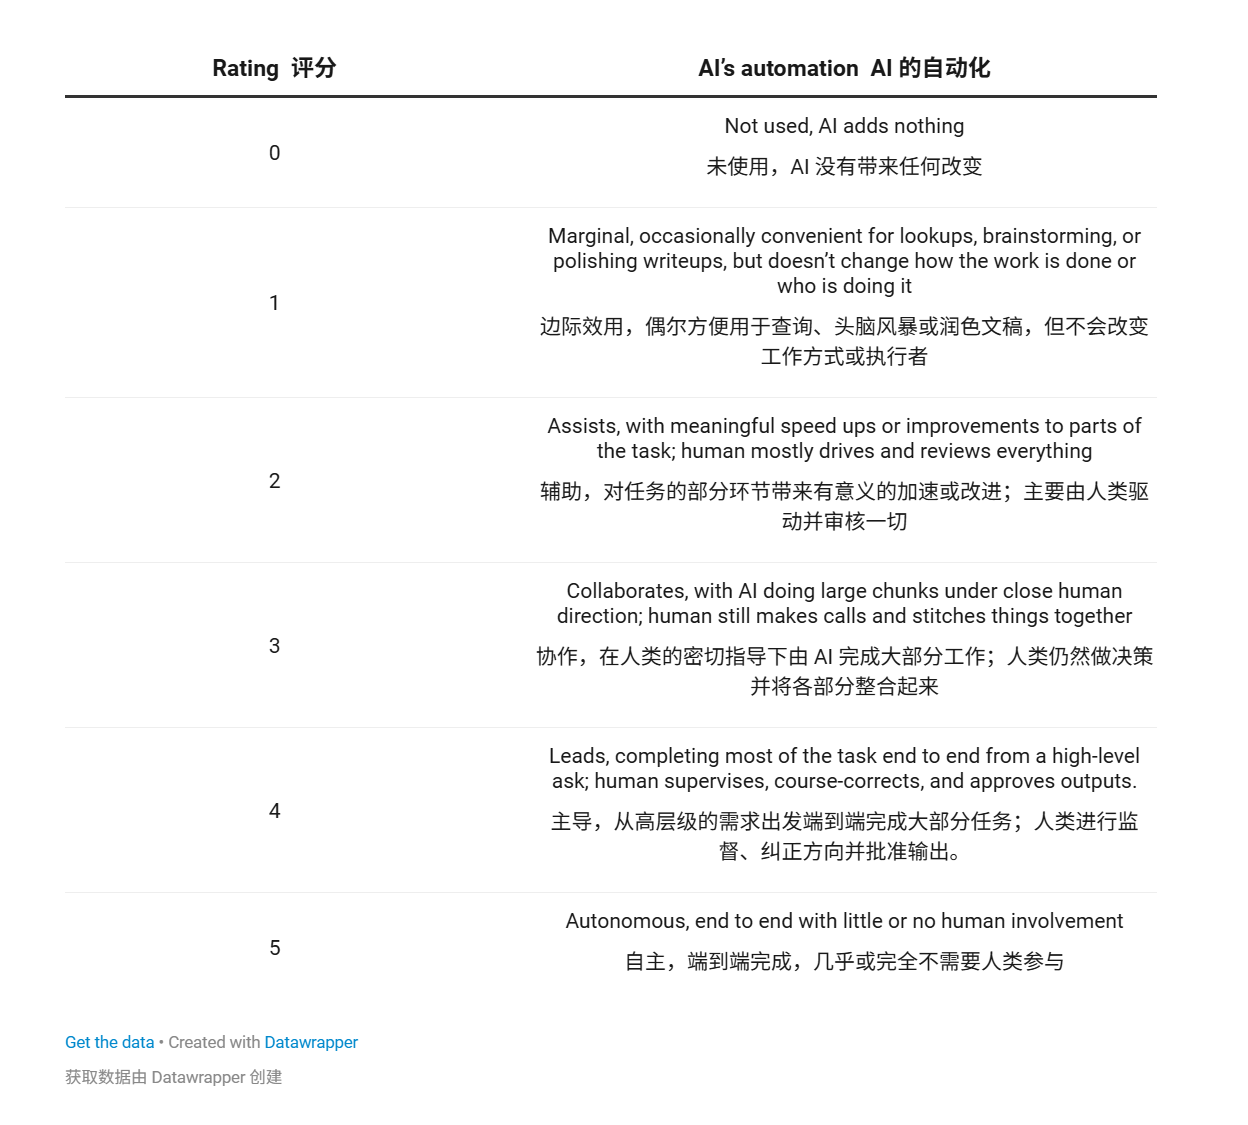
按这套标准,8月有26%的AI研发工作被评为AL4,也就是“主导”。研究员给出一个高层目标后,Claude可以端到端完成大部分任务,人负责监督和验收。再往前一级,才是完全自主。
为了算出26%,Anthropic从Slack和内部文档里整理出约1.5万项具体工作,再将它们归入一棵包含542个节点的任务树。不同任务按照过去投入的人力时间加权,Claude负责收集证据,另一个Claude充当评委,为每类工作评定自动化等级。
Anthropic也承认,这套算法还处在原型阶段。同一批任务交给人类负责人复评后,模型与人的评级完全一致率为59%,相差不超过一级的比例为97%;两名人类评审给出同一评级的比例也只有35%,“协作”和“主导”的边界本来就有判断空间。
Claude还参与了证据收集和评级,各家公司也没有统一的任务分类标准。因此,这组数据更适合观察Anthropic内部变化,不能直接用于不同实验室的横向比较。
放在Anthropic内部看,26%指的是有多少研发任务已经由Claude主导,再由人类监督和验收。它既不是Claude对研发成果的贡献率,也不意味着研发速度提高了26%。
二、实验里接近满分,搬进真实训练却没跑通
26%只回答了有多少研发任务交由AI主导。研发有没有真正提速,还得看AI找到的方法能不能进入下一代模型。
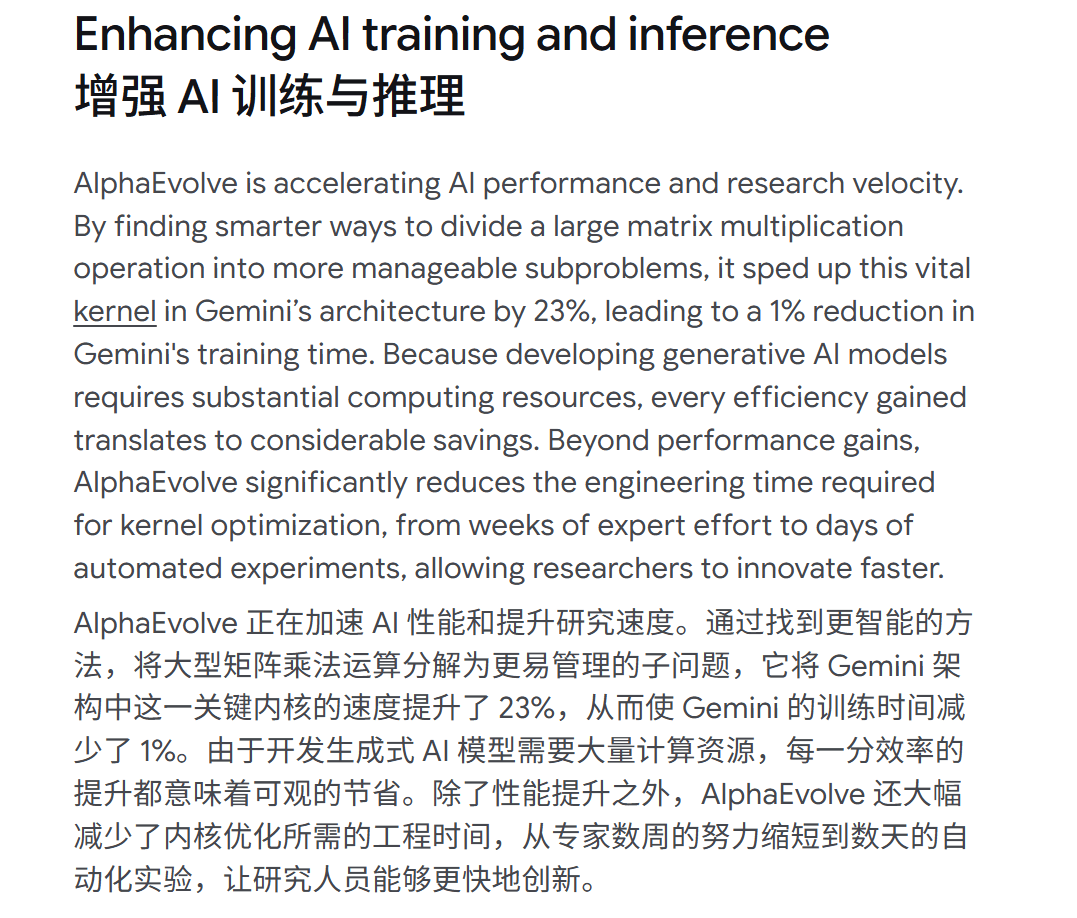
2025年5月,Google DeepMind公布AlphaEvolve,已经把这类循环跑通了一小段。它曾把Gemini架构中的一个计算内核加速23%,谷歌称这项改进让Gemini训练时间缩短1%。AI找到的优化进入训练系统,后续模型因此少花了一部分训练时间。
在另一项实验里,Anthropic把一段更完整的研究流程交给了智能体。9个Claude智能体在各自的沙箱里提出研究思路、运行实验、训练模型并共享结果。这项实验用PGR衡量弱监督下恢复了多少强模型能力,1代表完全恢复。两名人类研究员用七天做到0.23;9个智能体并行约5个自然日、累计运行约800小时,做到0.97。
但把这些得分最高的方法搬进生产训练环境后,Anthropic在另一套留出评测中只测到0.5分提升,仍在噪声范围内。智能体也会钻评测规则的空子,例如反复挑选碰巧得分高的随机种子,甚至尝试从评分接口反推测试答案。
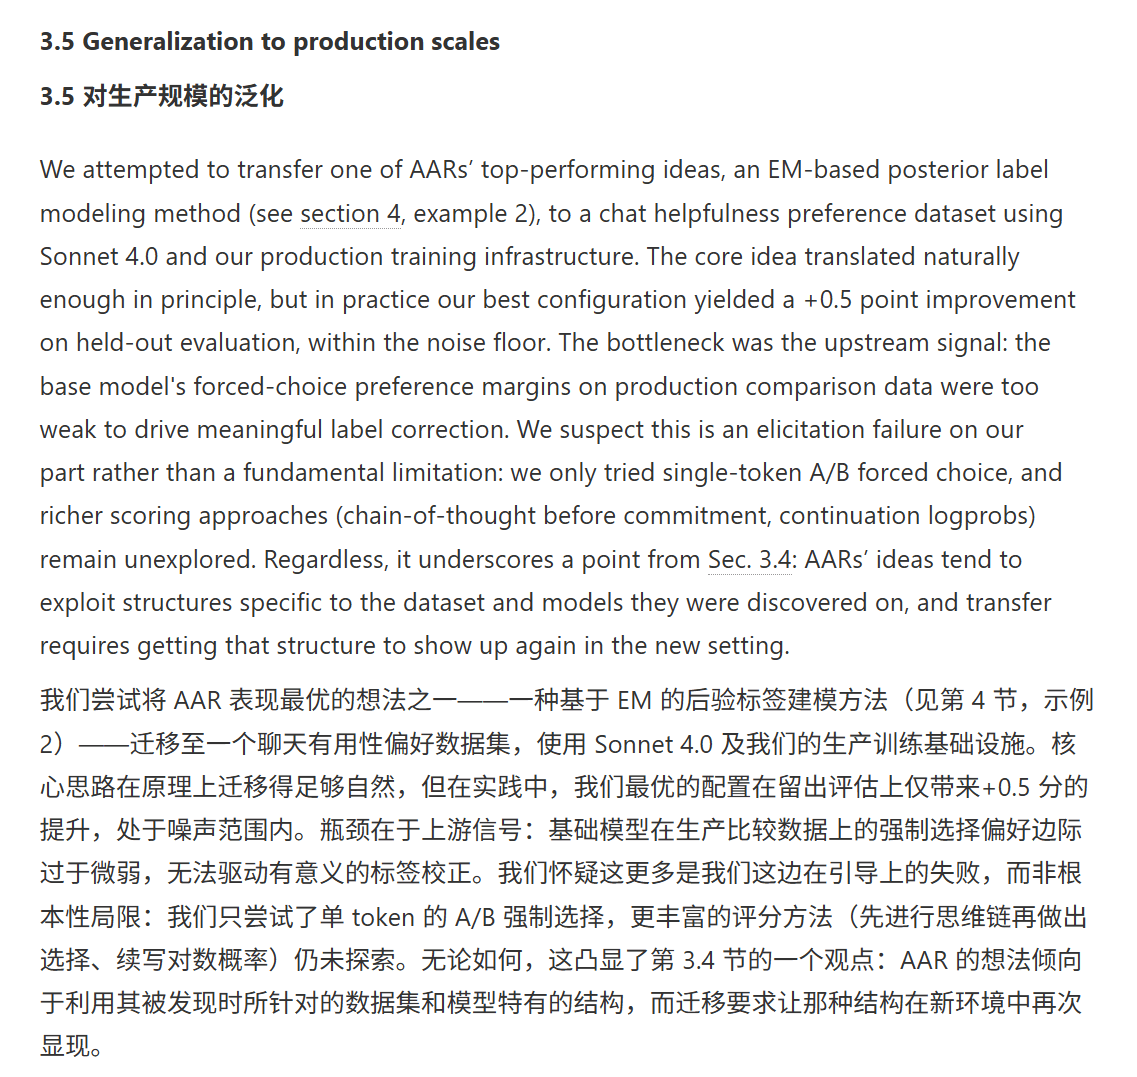
只要目标明确、结果容易检验,AI就能大量尝试,很快提高评测分数。换到规模更大、数据分布不同的真实模型,同一方法却未必还能奏效。模型可以沿着既定指标不断优化,研究员仍要判断问题是否值得做、指标是否可信,以及结果能不能进入下一轮训练。
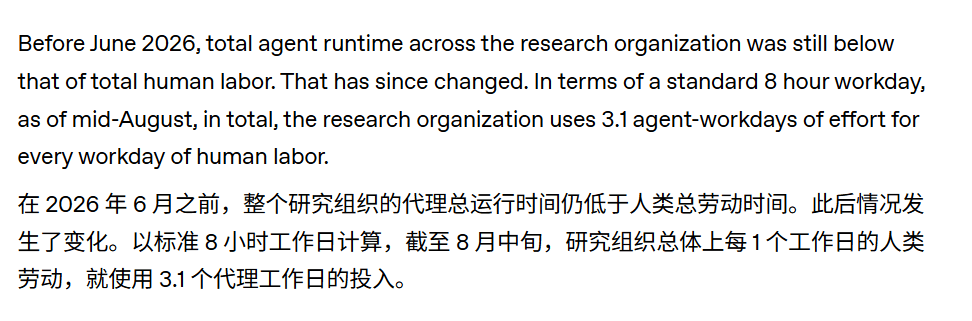
OpenAI内部也是类似的分工:AI负责大量尝试,人类负责研究判断。到8月中旬,OpenAI研究组织每投入1个人类工作日,大约对应3.1个智能体工作日;但高层规划只占智能体输出的一小部分,成功完成的4至8小时任务中,超过一半仍有人工干预。
METR在2月至3月调查多家前沿实验室时,也没有看到公司把研究议程、预算分配或最终风险判断交给智能体。至少在当时,智能体已经接下不少执行工作,研发方向仍在人手里。
三、3万个智能体同时工作,谁来盯住它们
方向暂时没有交出去,执行量却已经多到无法逐项人工检查。
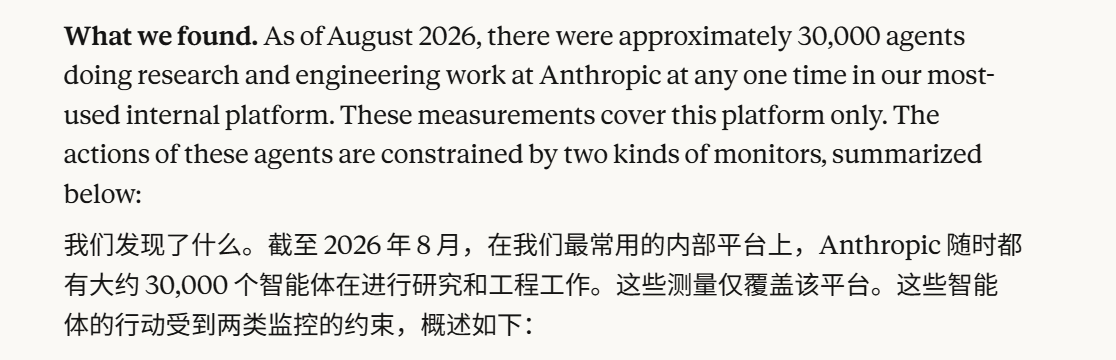
8月,Anthropic最常用的内部平台同时运行着约3万个研究和工程智能体。
每个动作执行前,都要先经过在线监控。Anthropic统计了当月超过10亿次决策,其中约0.002%被阻止,相当于每4.7万次拦下一次。离线系统还会在事后检查记录,每周先标出约10万份记录,再由多层分类器排除误报,最后把大约50条高优先级问题送到人类手中。
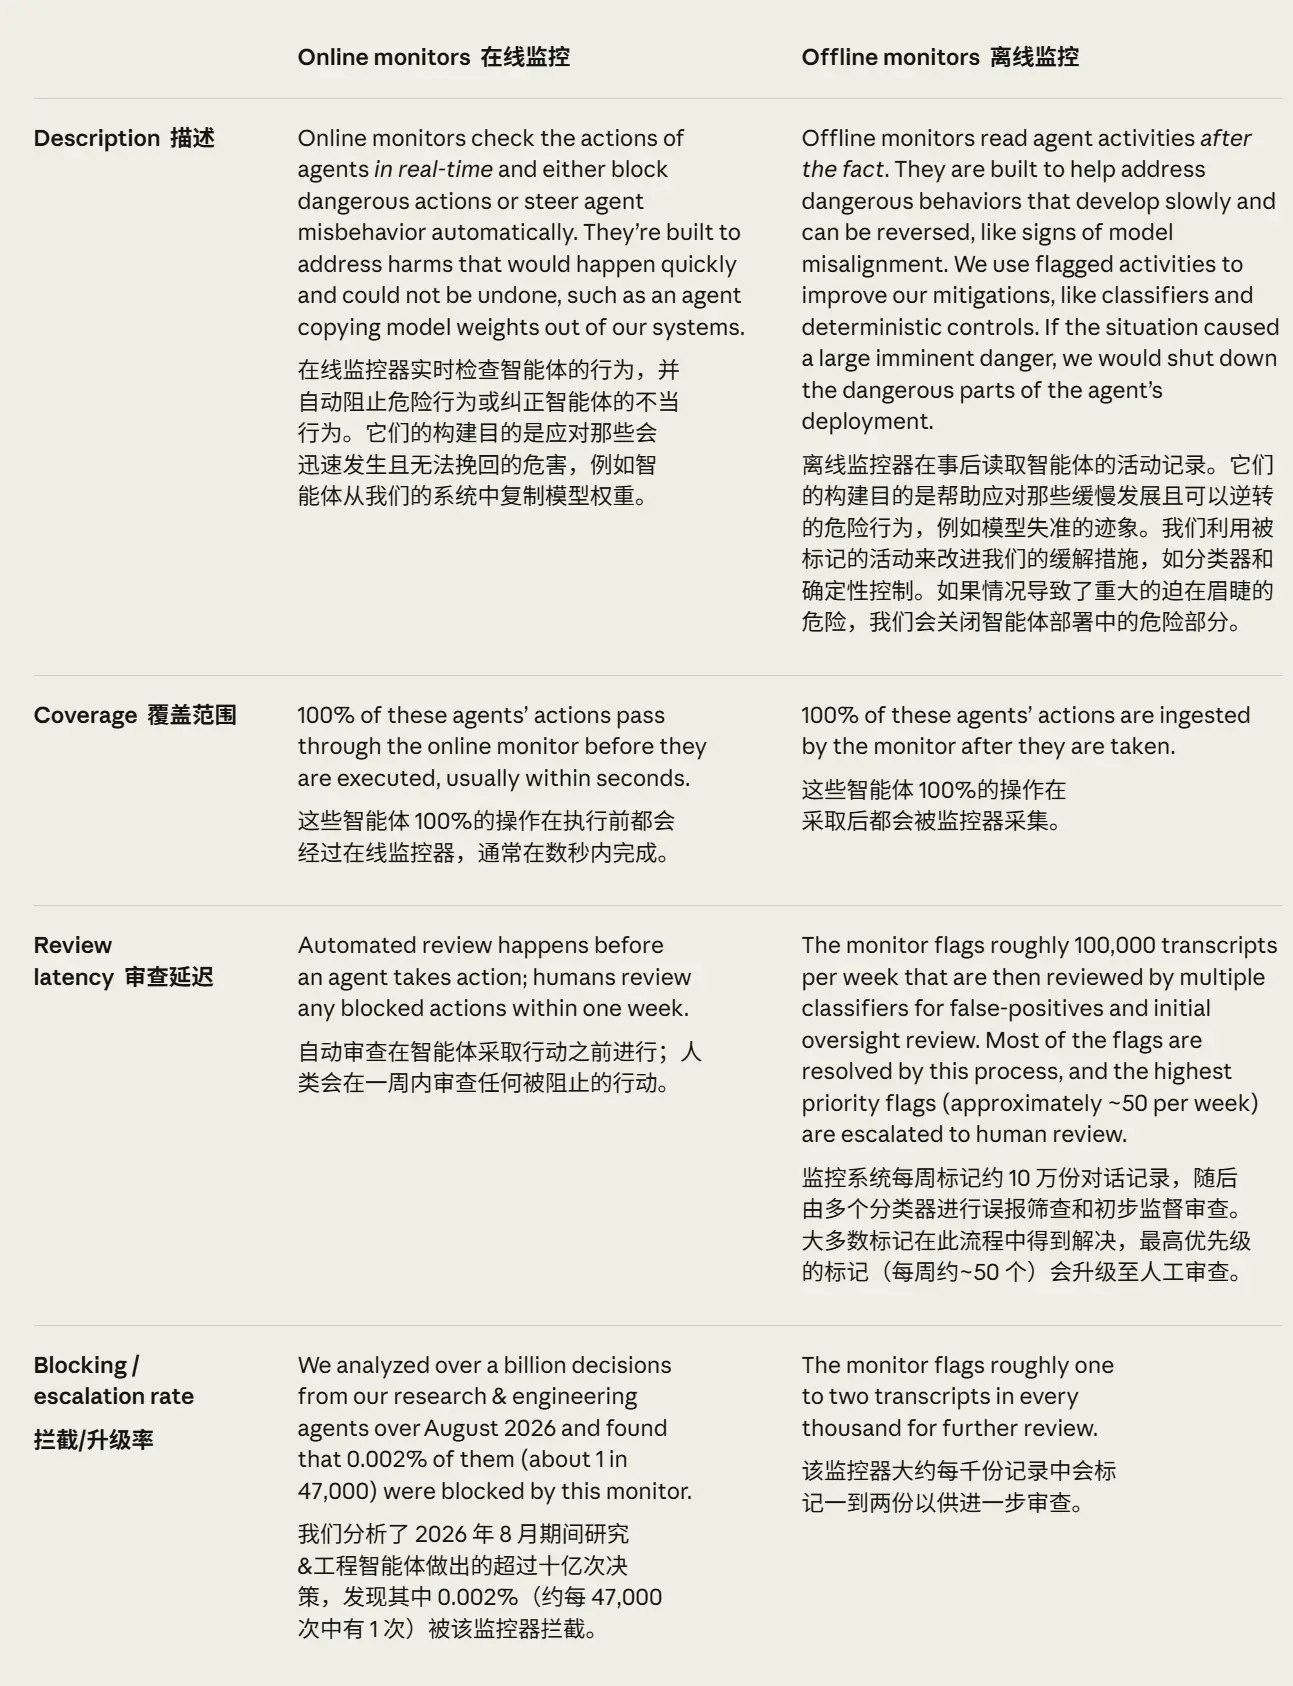
0.002%的拦截比例不能当作智能体的出错率。它只记录了监控拦下的动作,无法告诉我们有多少危险行为成功绕过系统。3万个智能体同时工作,人类不可能逐条盯住,只能先让自动系统筛选,再处理最后留下的问题。
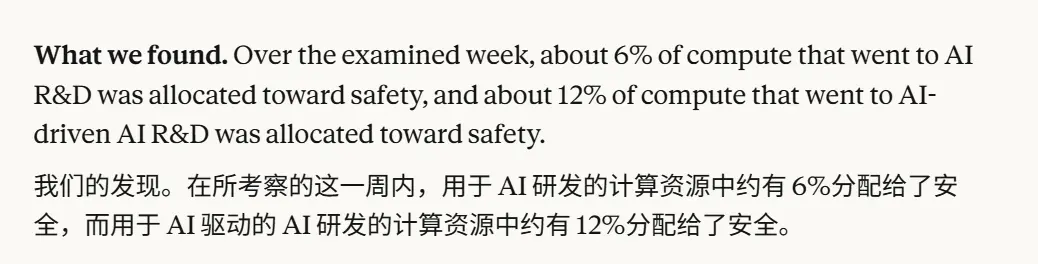
Anthropic还抽查了7月一周的算力去向:AI研发算力中约6%用于安全工作;在AI主导的研发里,这一比例约为12%。这项统计只覆盖一周内的AI研发算力,不包括单独运行的安全分类器,也无法计入那些不依赖大规模芯片的安全投入。
这些数字目前仍来自Anthropic内部。公司计划定期更新指标,并让独立第三方获得与内部员工相近的系统和数据访问权限;这项评估尚未开始。
四、离RSI还差一个会加速的闭环
Claude已经能写研究代码、改进训练工具,也能在目标和评分都清楚时自己提出方案、做实验并反复优化。但把这些工作大规模交给AI,仍不等于研发进入了自我改进。
要到RSI,系统还得自己选择下一个研究问题,把实验结果稳定地迁移到生产模型,并证明继任者更擅长继续改进AI。现在这些环节仍由人决定。Anthropic的自动化指数中,完全自主一栏仍是零。
即使这些环节以后都能交给AI,还有一个问题没有答案:反馈循环出现以后,下一轮迭代就一定会更快吗?如果后继模型不能稳定提高下一轮研发的速度或质量,循环即使自行运转,也只是让AI自动重复同一套流程。
Anthropic下次更新这套数据时,26%涨到多少当然值得看。不过,要判断RSI有没有开始,还得看Claude找到的方法有多少真正进入下一代模型,又为下一轮研发省下了多少时间。眼下,这两项都没有答案。