鹭羽 发自 凹非寺
量子位 | 公众号QbitAI
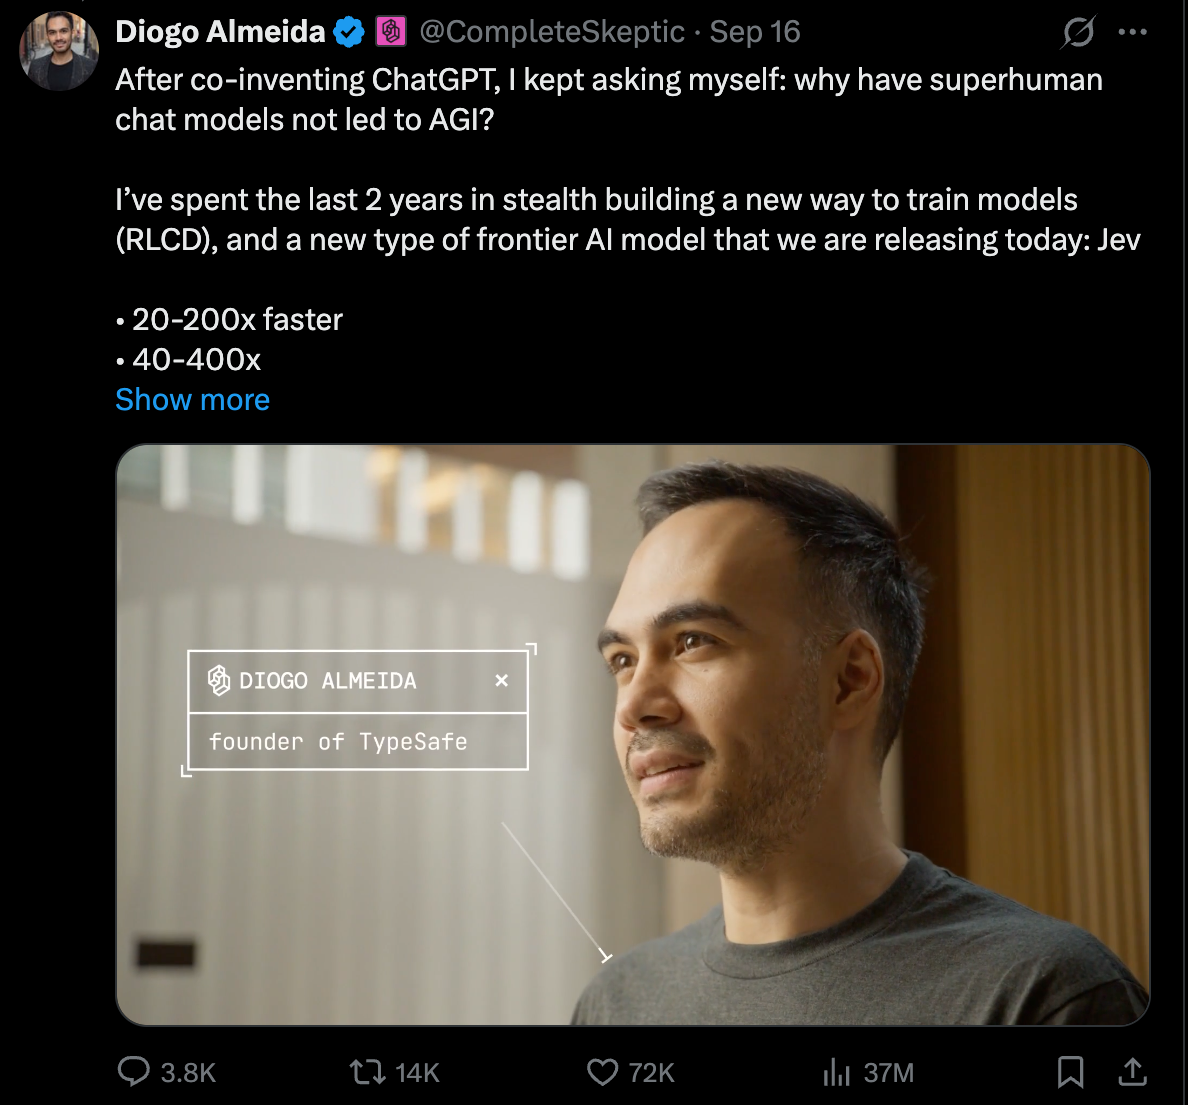
有意思!这两天,有个新模型在开发者内部火得一塌糊涂:
Jev。
原贴3700多万浏览量,、Hacker News全是相关讨论。。。
火的方式也挺抽象的,这玩意儿聊天不会、代码不写,yes or no它选择or。
简单中译中一下,就是把传统LLM的生成功能给砍了。
只专心干一件事:下判断,然后把选项和对应的概率丢回给你,还不是瞎编。
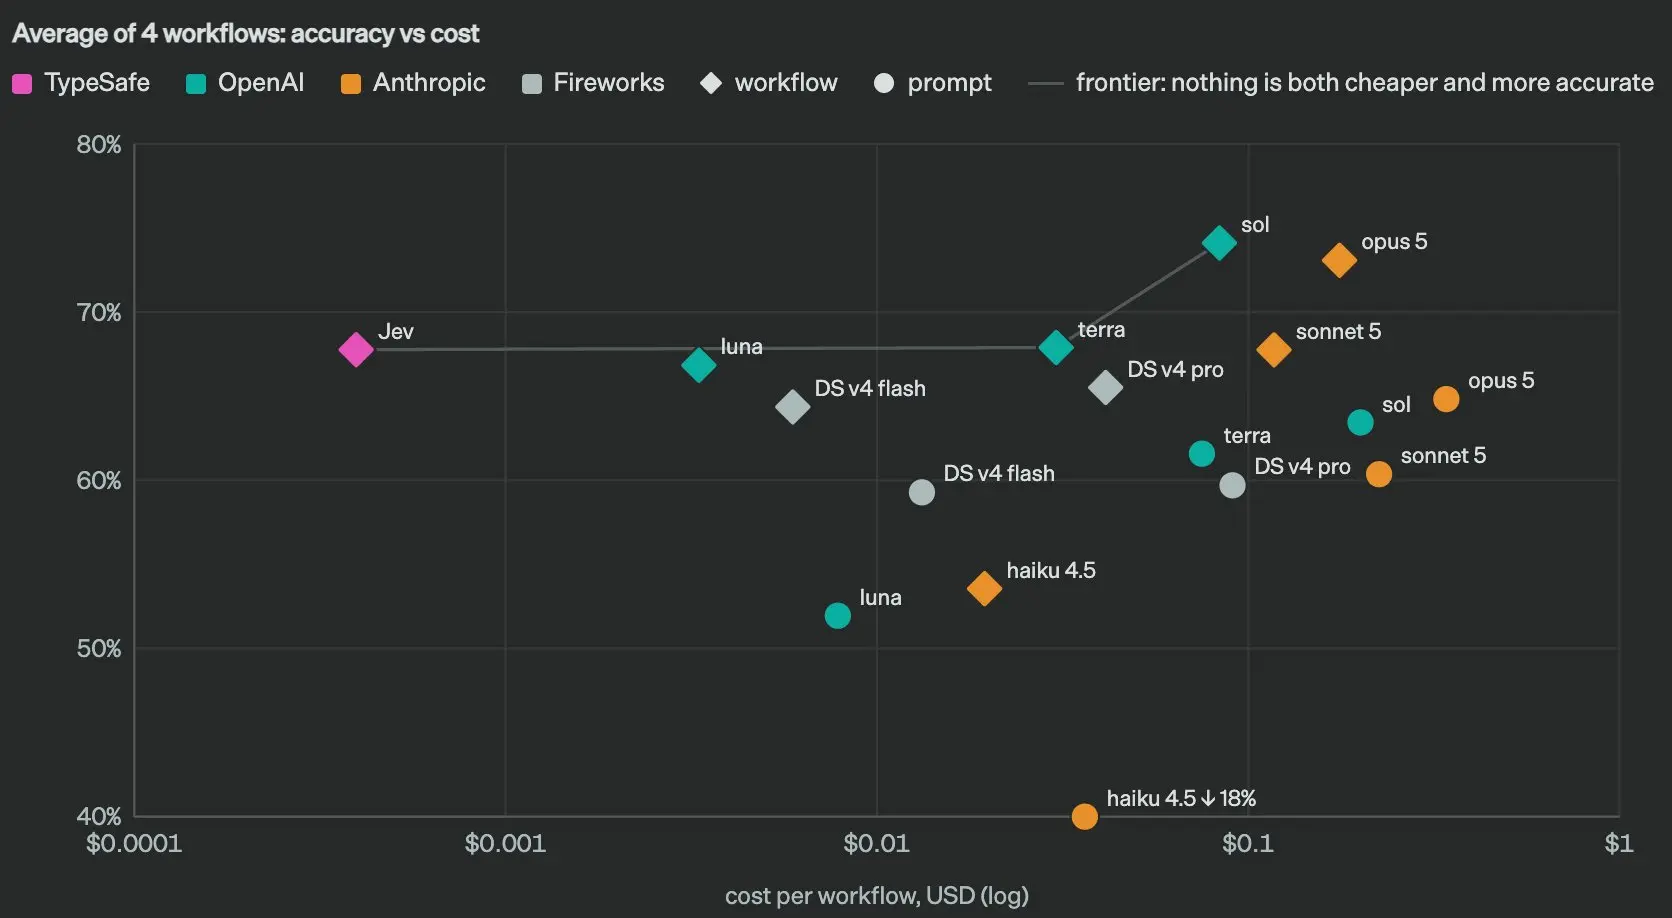
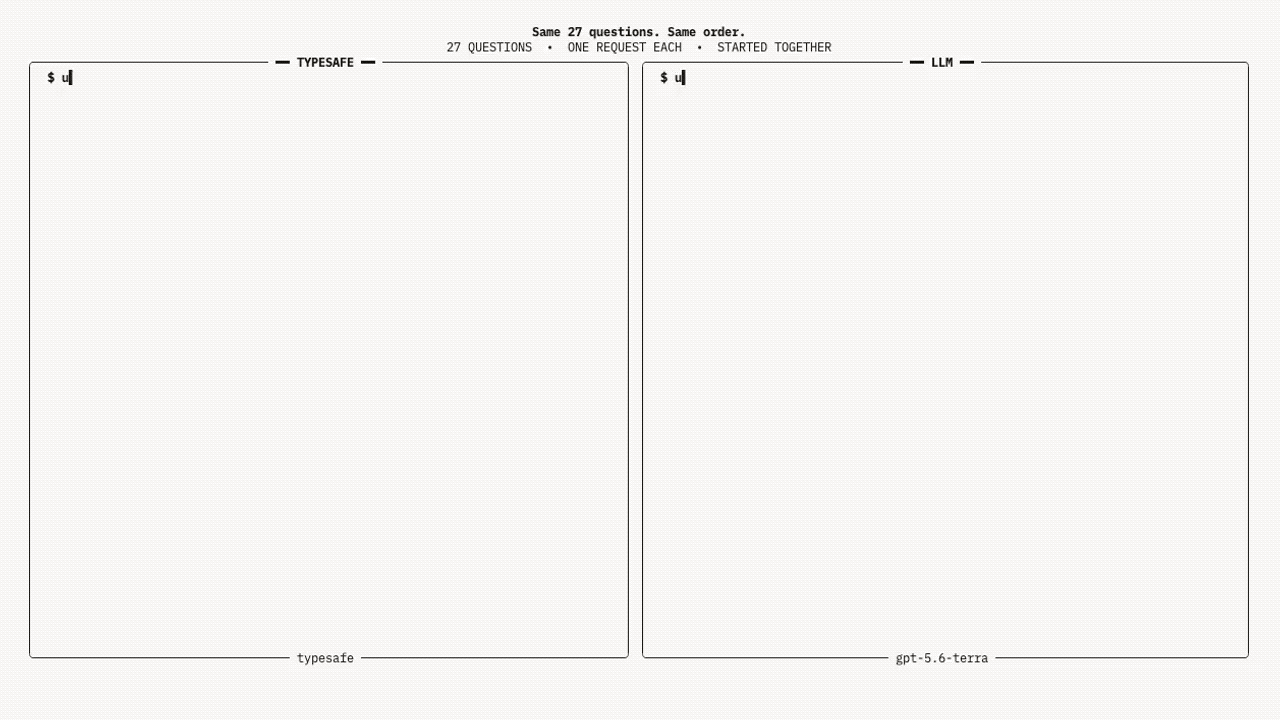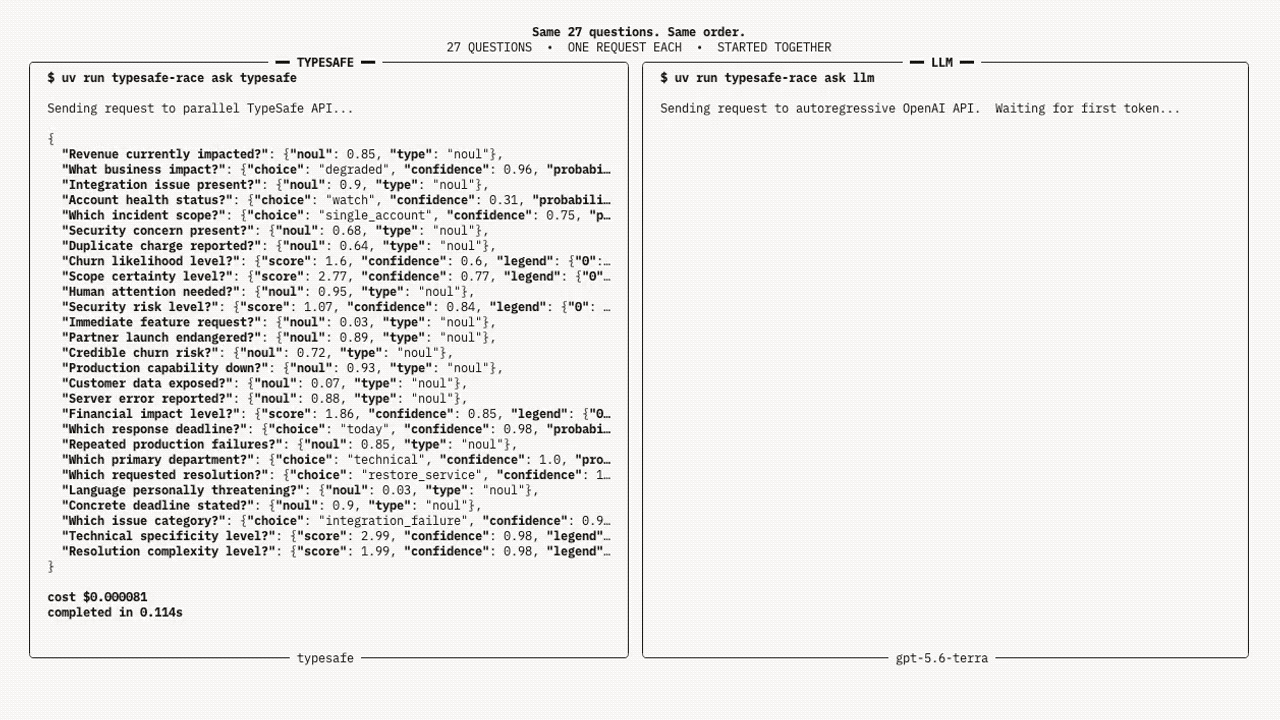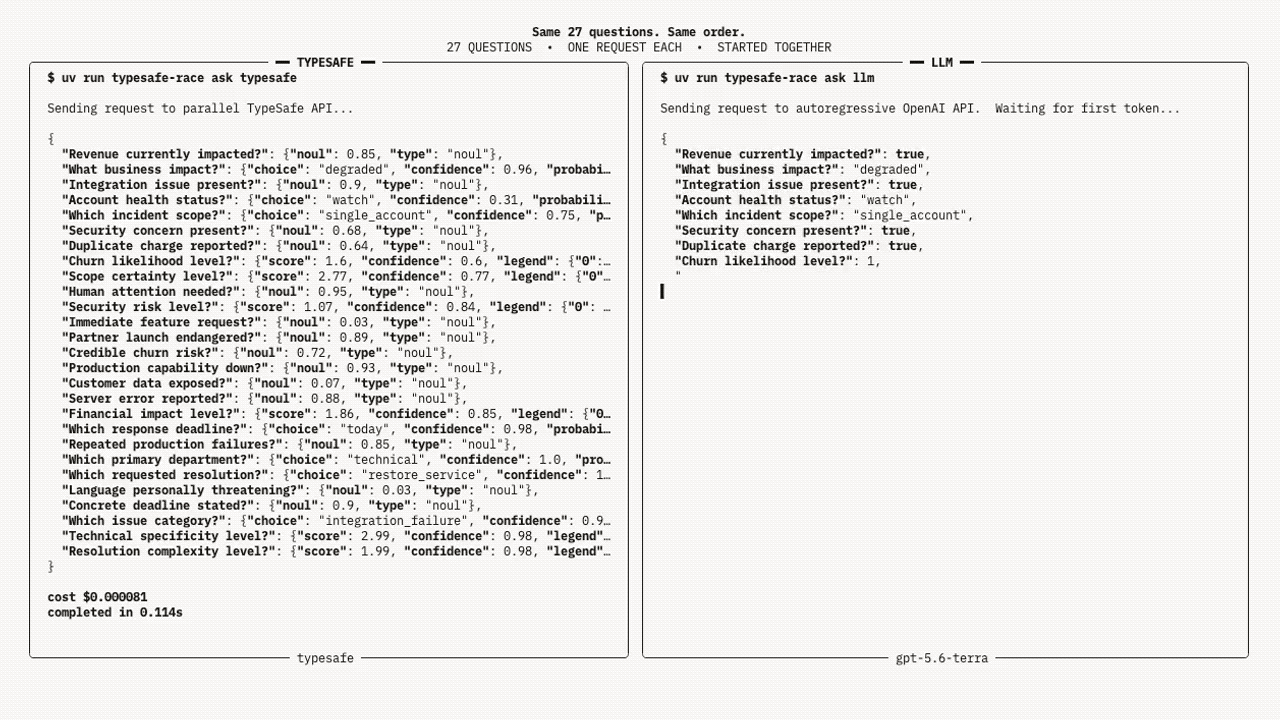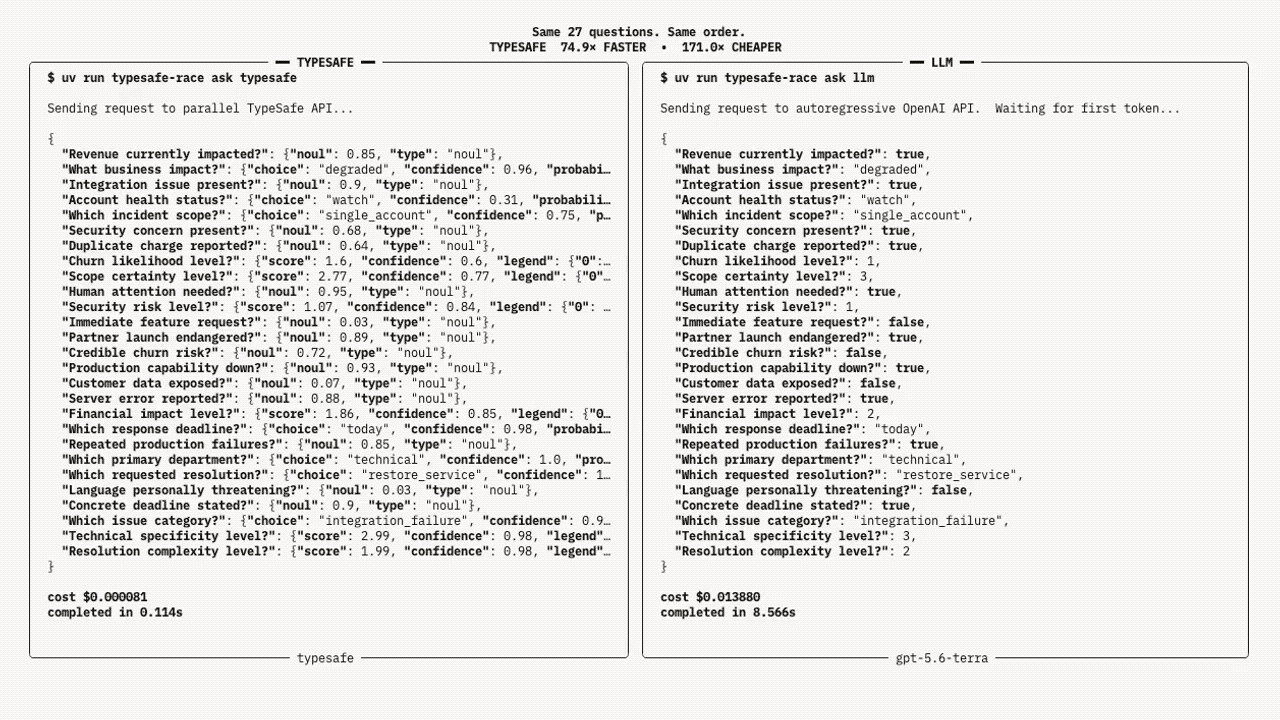
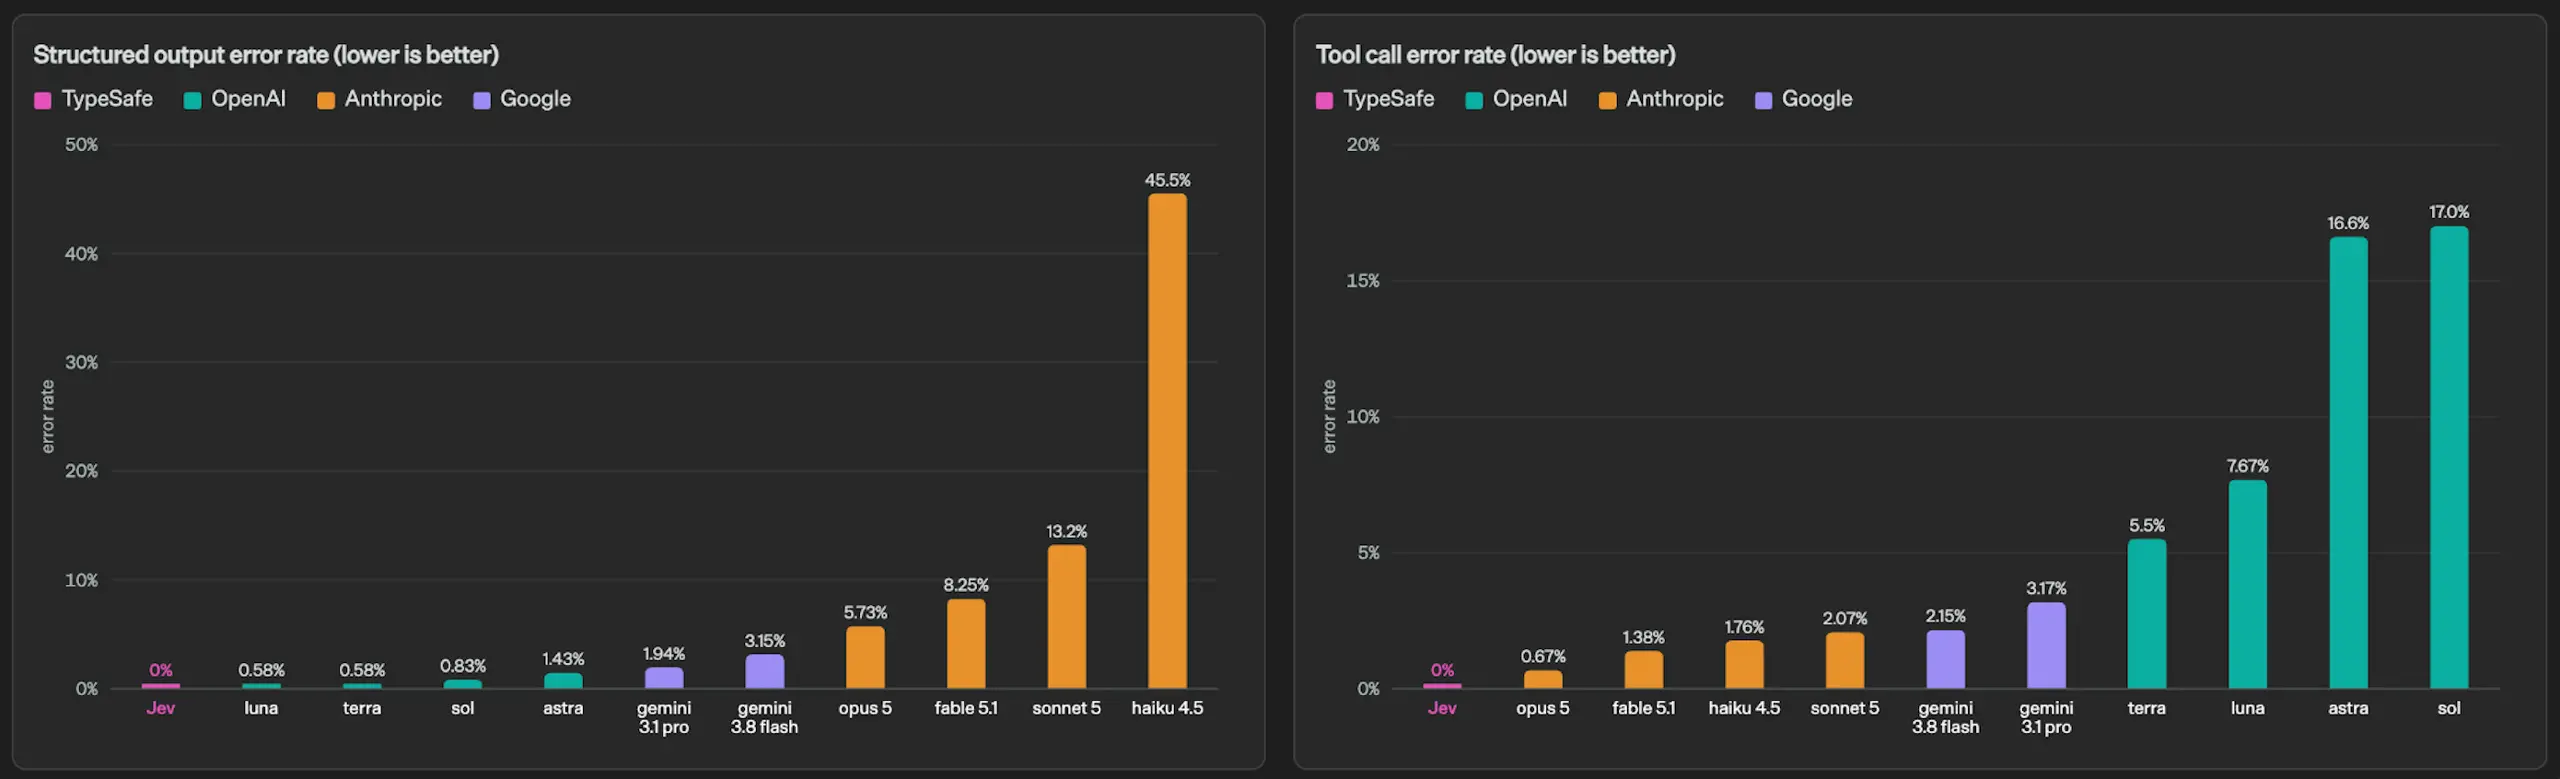
成绩那可是相当能打,速度最快193.6倍、价格最便宜444.6倍。
而且......因为新架构实在太便宜,不好计量,输出token永久免费,输入每百万Token也只需0.042美元。
只能说各家的Flash模型哭晕在厕所。
更有节目效果的,是做这个的老哥——OpenAI前研究员Diogo Almeida,曾参与RLHF、InstructGPT等核心研究。
亲手教了AI小半辈子「好好说话」,临了临了直接喊AI「闭嘴」了。
这也是他出走创办的新公司TypeSafe AI首度公开亮相。
System One Model
官方介绍,Jev是它们的第一个System One Model。
何意味?丹尼尔·卡尼曼有个快慢系统的概念,系统1主打高速直觉式决策,系统2则偏向慢速长文本推理。
很明显,当前的LLM更多沿着2发展,Jev返璞归真探索1。
Jev这个名字也是出自Jevons悖论,单任务成本暴跌,但整体AI使用量预计会爆发式增加。
Jev提供三种基本能力:Choice、Score和Noul。
- Choice:从候选项里做选择;
- Score:按标准打分;
- Noul:给出某个判断成立的概率。
再直白一点,你可以把Jev理解成一个带概率的“语义逻辑门”:
它接收非结构化的状态和一组限定回答类型的问题,然后输出决策结果和评分,再交给代码接着跑。
说到这儿,可能有朋友要问了,传统生成式模型不也能做分类吗?
当然能,但区别在于,答案是如何产出的。
传统生成式模型通常还是逐token写答案,哪怕最后只需要输出一个“A”,也会花费大量token在解释答案上。
反观Jev直接输出判断结果,同一份输入里的多个独立问题还能并行处理,省掉了把答案逐字「写出来」的过程。
这样舍掉文本生成后,速度和费用就很可观了。
官方公布的端到端响应时间低至70~500毫秒,相比前沿模型能快20~200倍,价格便宜40~400倍。
当然光有答案还不够,要真正融入工业流程中,还有个至关重要的问题:模型到底有多大把握?
Jev提出了一个全新的训练方法——用于校准决策的强化学习 (RLCD,Reinforcement Learning for Calibrated Decisions)。
对照来看,RLHF根据人类反馈奖励人们更偏好的回答,RLVR根据可验证的结果给予奖励。
RLCD则把优化重点放在决策及其概率上,希望模型判断得准,也能准确表达不确定性。
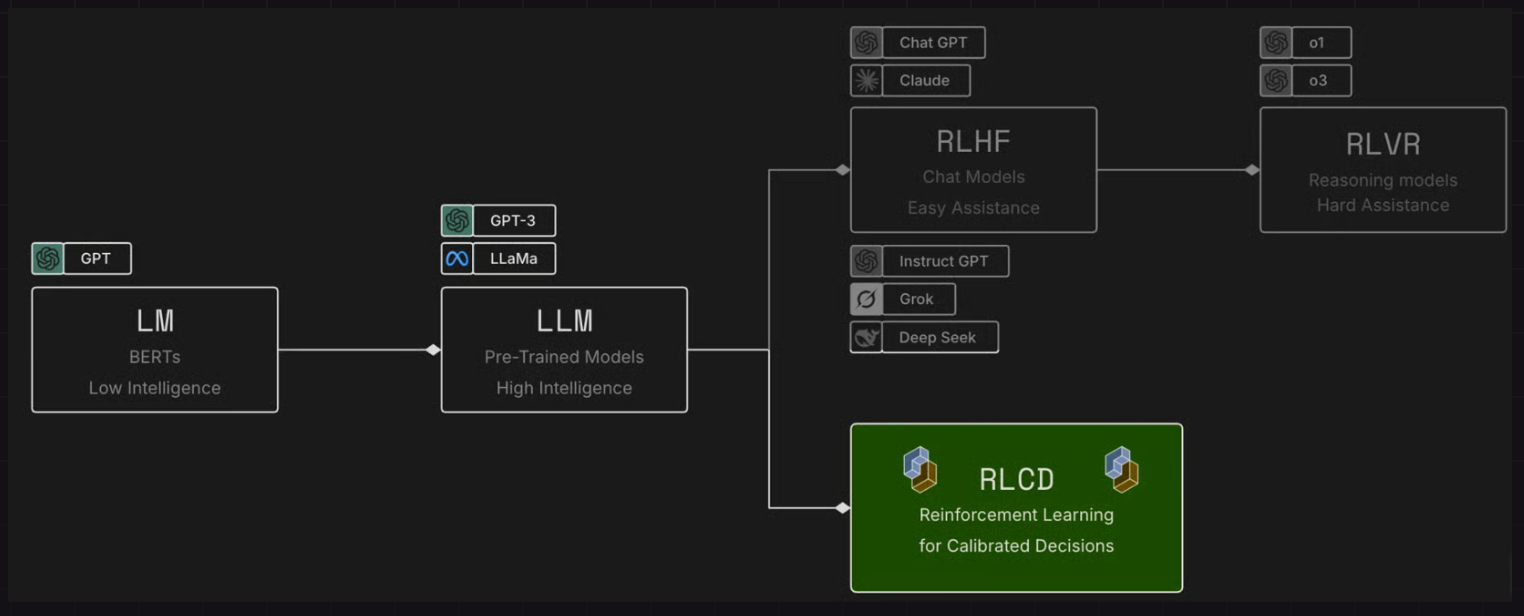
所谓「校准决策」,可以理解成让模型输出的概率值,匹配真实发生的频率。
比如被模型标为0.2概率的结果,真实发生这件事的比例就约等于20%,标为1则代表这件事几乎一定会发生。
如果没有这一步,模型输出的置信度数字就缺乏实际参考价值。
另一个值得细说的是幻觉。
官方描述Jev是“零幻觉”,其实是有些夸大的。
Jev保证的是模式匹配,比如你给它A、B、C三个选项,它的确不会自作主张,编出一个D输出,但正确答案明明是A,它照样可能选成B。
所以这里的“零幻觉”得打个折扣,类型正确而事实不一定正确。
Jev用法焚诀
在Jev有限的判断任务里,各路开发者也找到了一些实用打开方式。
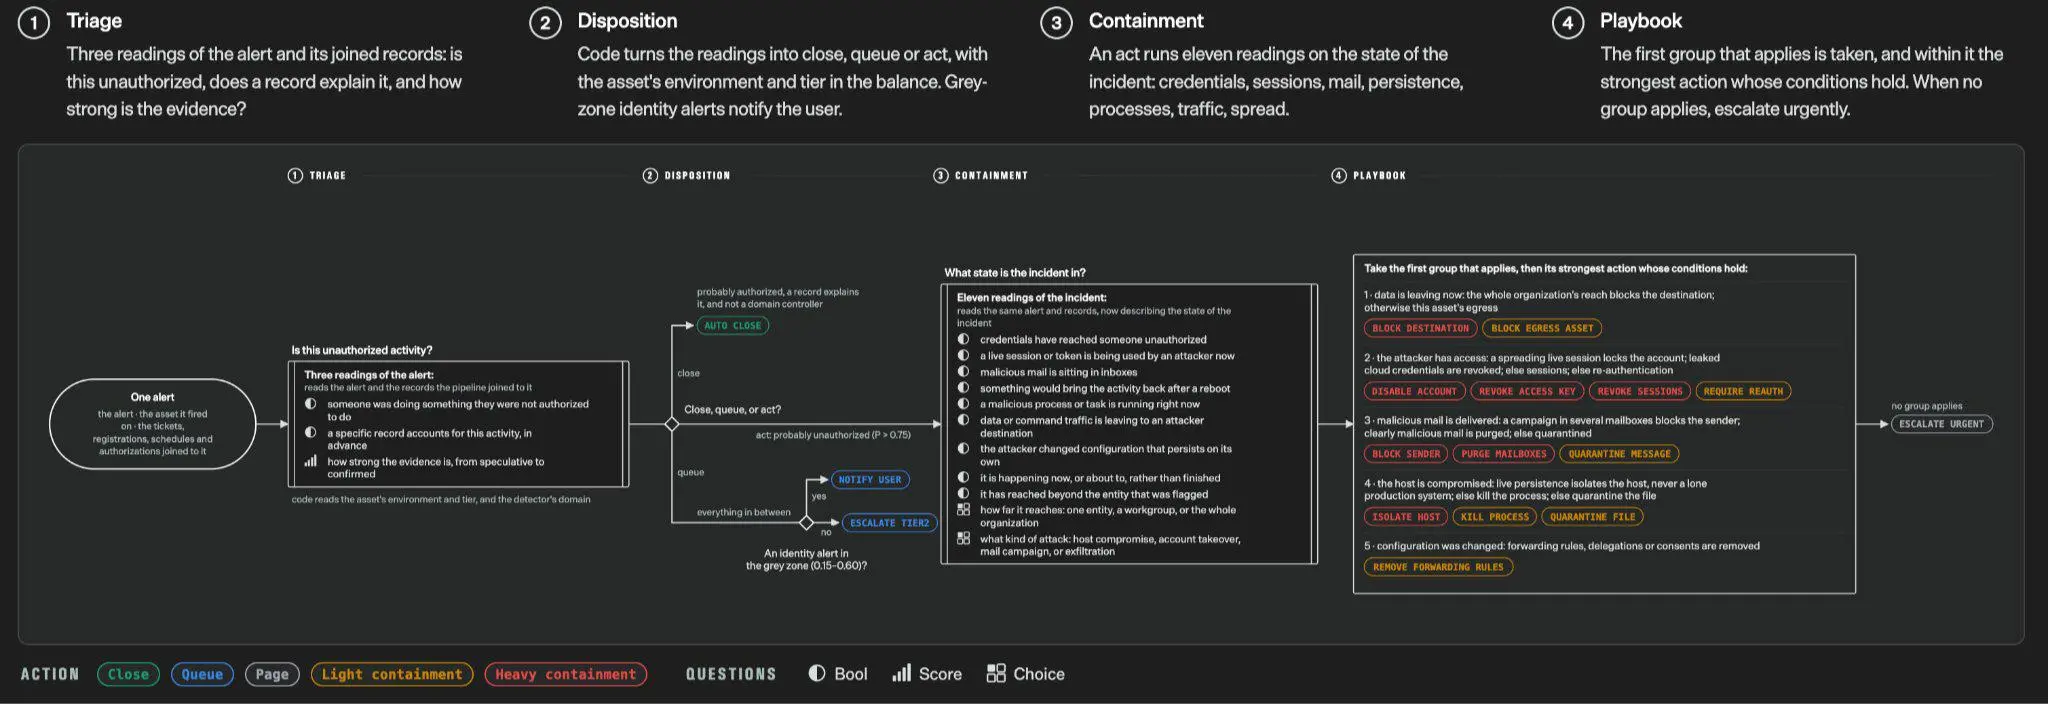
一类是接管软件里的高频判断。
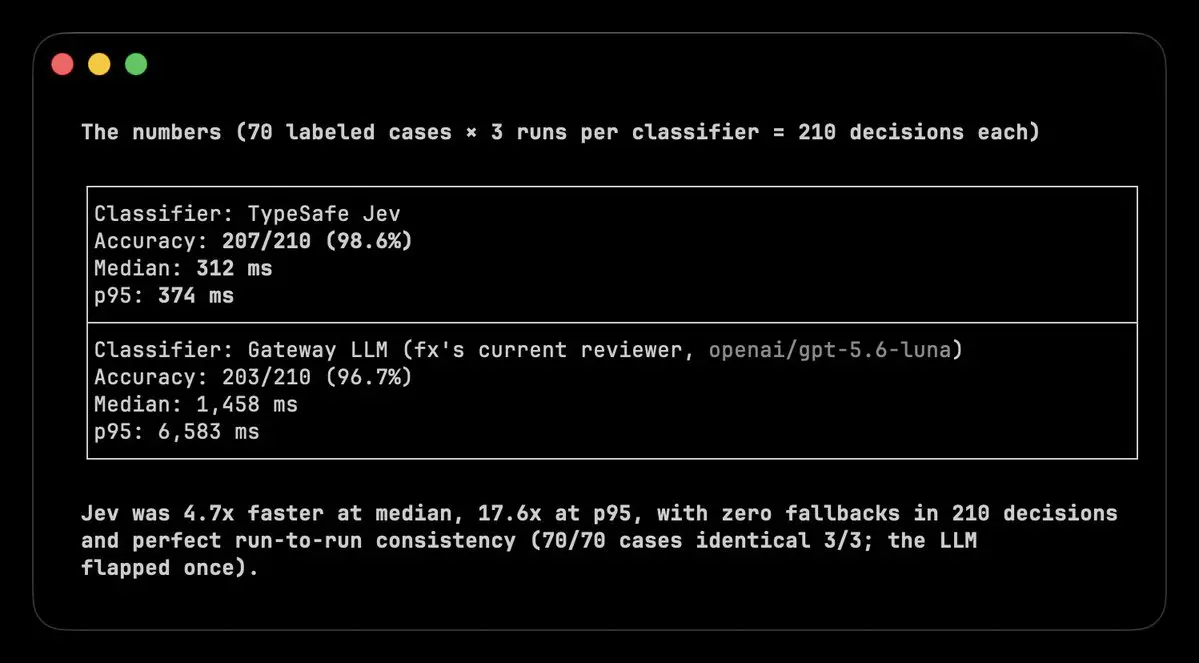
Vercel工程师Pranit在实际业务中,对fx自动模式的安全分类器进行了测试,Jev相较原本选择的GPT-5.6 Luna要快5~18倍,准确性也更高。
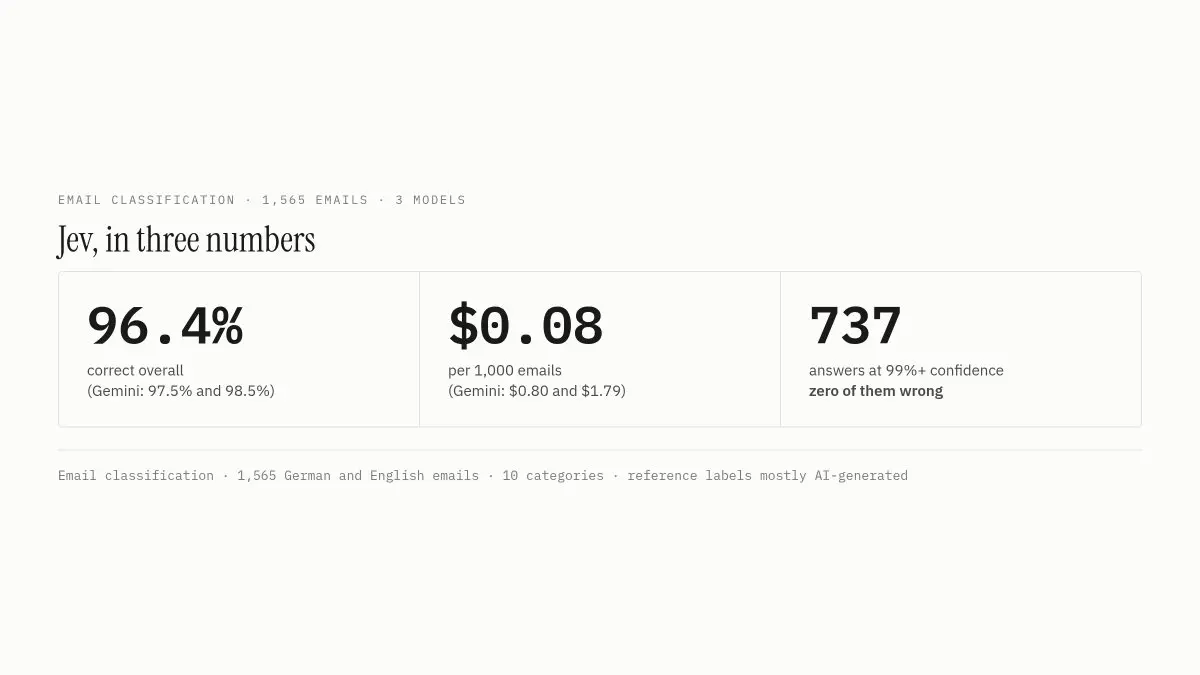
Bryo AI技术总监Nikhil Mudholkar则对Jev和Gemini同时进行商业邮件分类测试。
测试结果中,Gemini的准确率要略胜一筹,但价格是Jev的10~20倍。
从性价比来看,Jev更适合自动化工作流程。
另一类是给LLM当验收员,可以对LLM的不当行为进行检查,例如有用户部署Jev来追踪LLM Agent并防止模型越狱。
开发者Elvis Saravia就把Jev接进自己的Agent框架,并构建了自定义验证器,可以在Agent宣称任务完成后再检查一遍。
这样验证成本足够低,且目标结果可信度高,也可以视作系统1和系统2的巧妙结合。
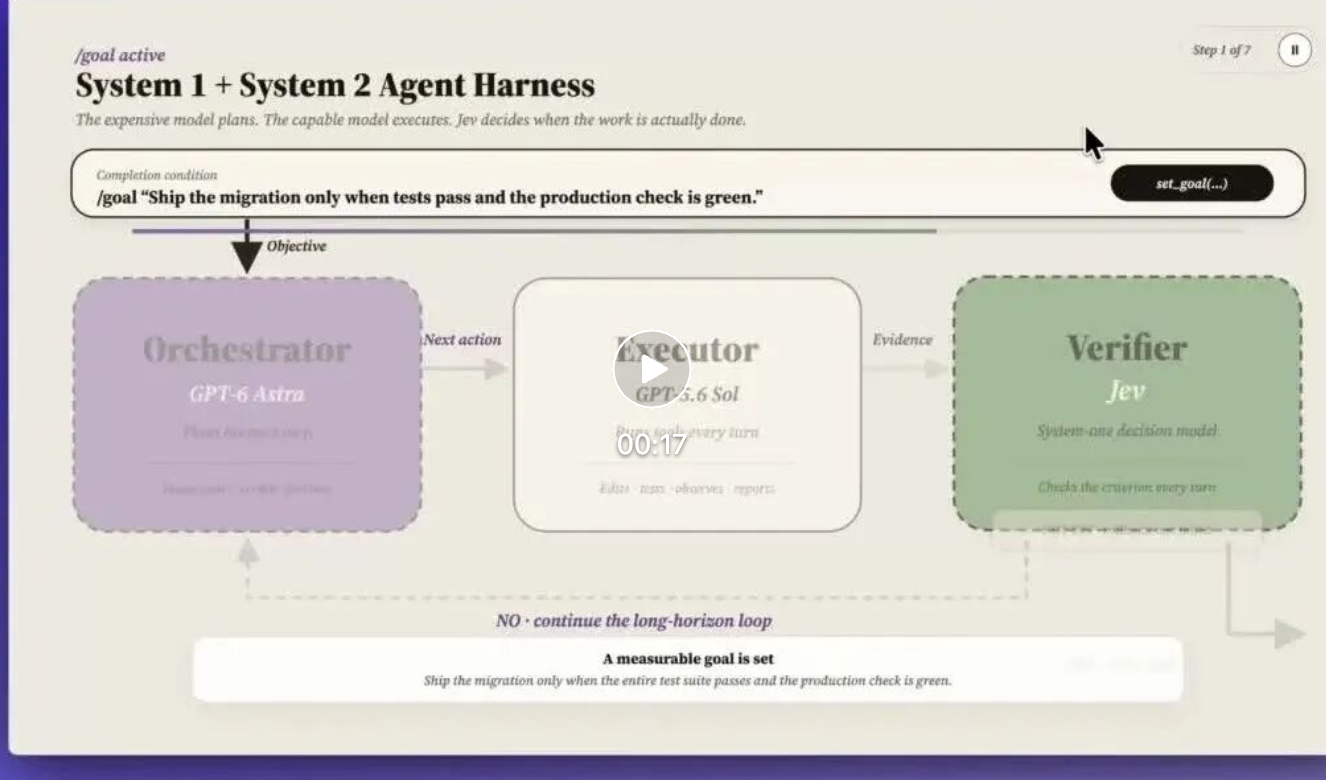
同样的思路还可以用于模型路由:
先让Jev判断请求难度,简单任务交给快模型,难题再请昂贵的推理模型出马。
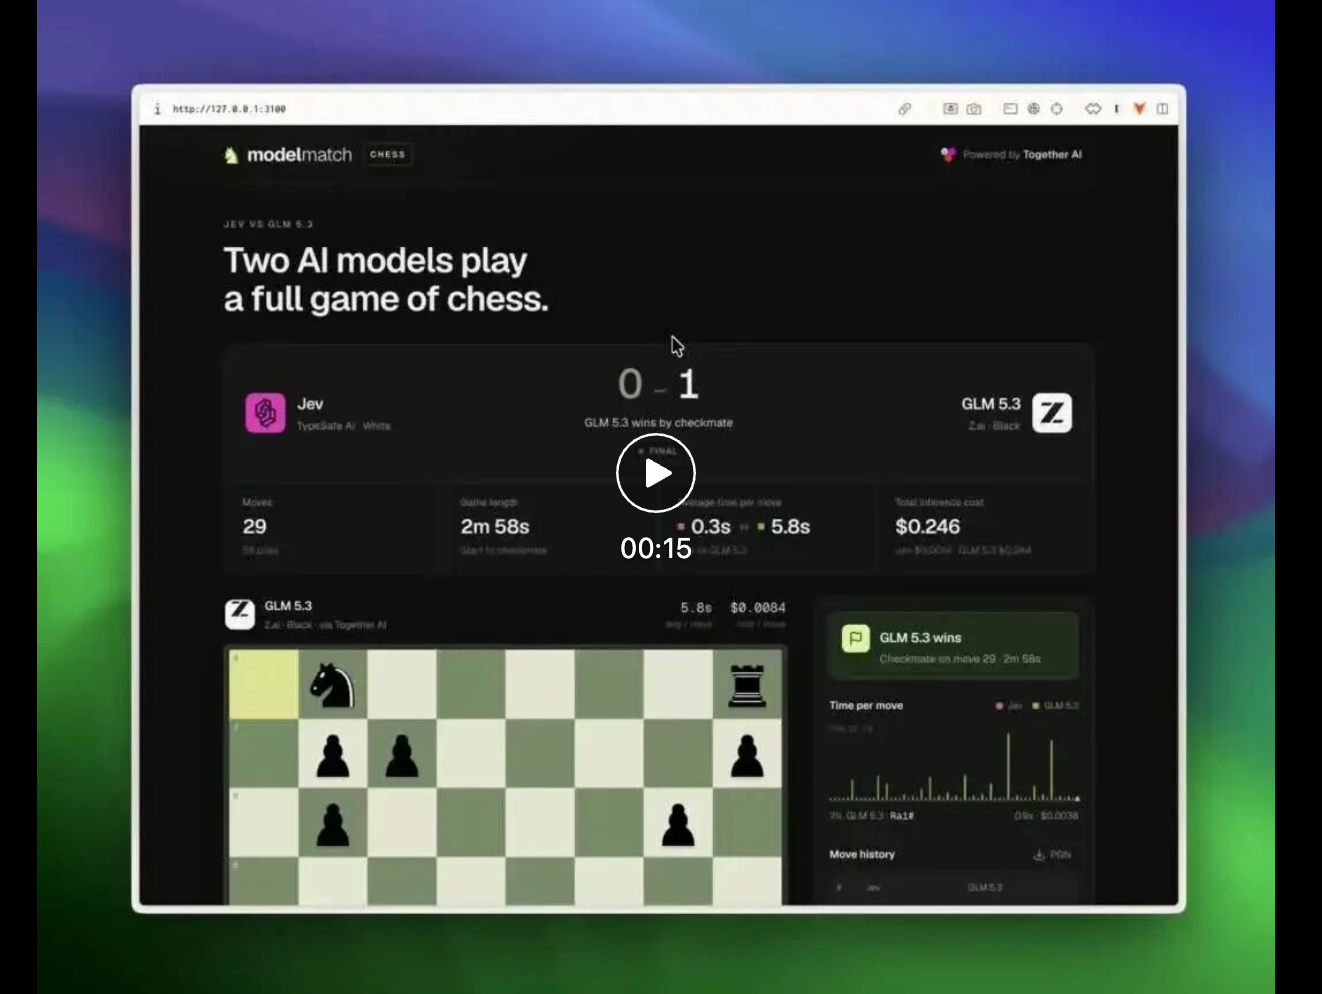
比如开发者Hassan的下棋测试(Jev VS GLM 5.3)就挺有意思:
Jev每步约0.3秒、不到0.0001美元,GLM 5.3每步约5.8秒、约0.008美元,最终却由GLM 5.3在29步内将死对手。
下得快,未必想得深。
Hassan也因此更看好多模型混搭:让Jev负责快速、明确的判断,让LLM处理需要深入推理的难题。
开源也跟上了
不止如此,随着Jev把快速决策这条路线带火后,开源版也来了——Nimble。
Jev目前还只能通过API访问,但Nimble已经可以装进本地。
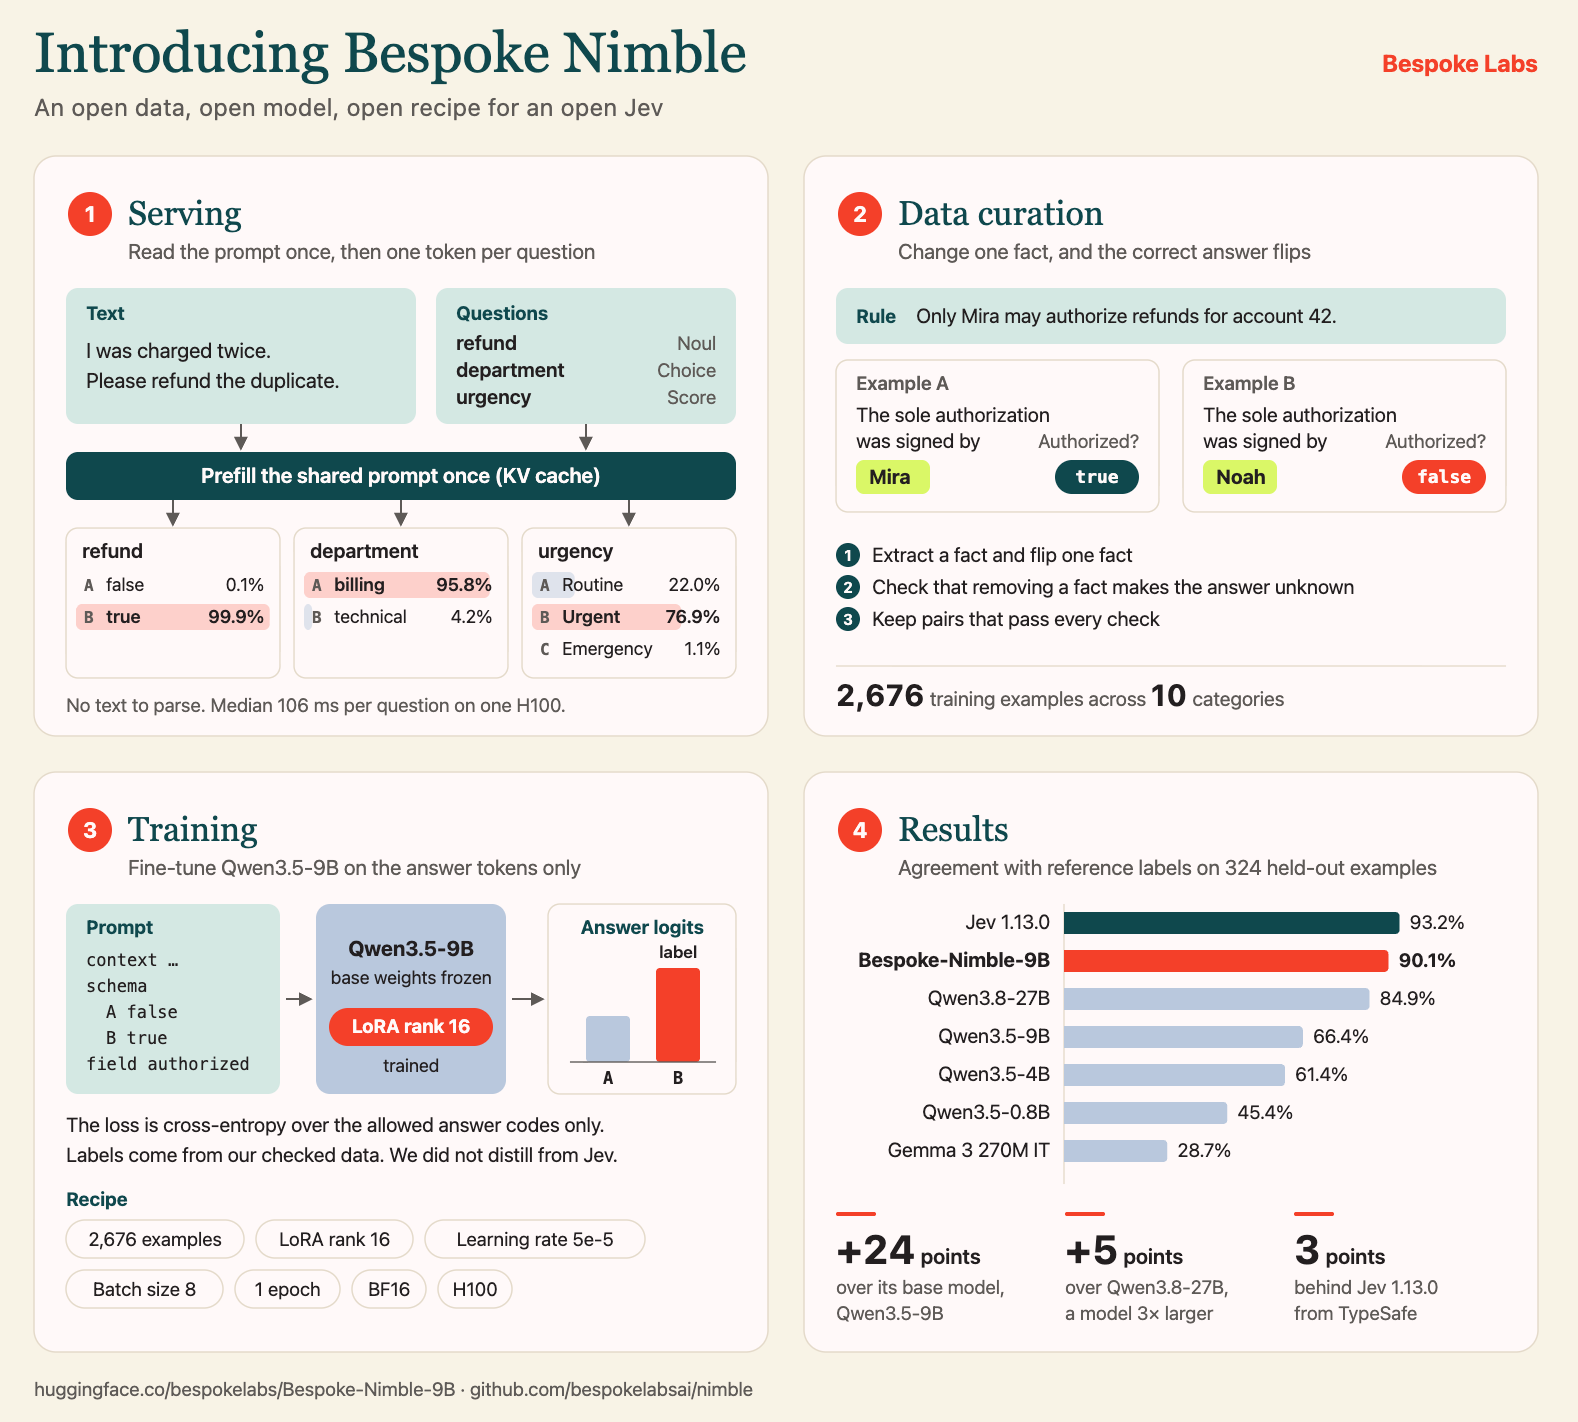
Nimble在思路上和Jev是一脉相承,基于Qwen3.5-9B做LoRA微调,模型适配器已经以Apache 2.0许可发布,可配合基础模型使用。
除了模型,训练数据和方法也一并开源了。
训练思路有点像让AI“找不同”:构造两份几乎一模一样的材料,只改一个关键事实,答案正确与否随之翻转。
想答对,模型必须抓住真正影响判断的核心信息。
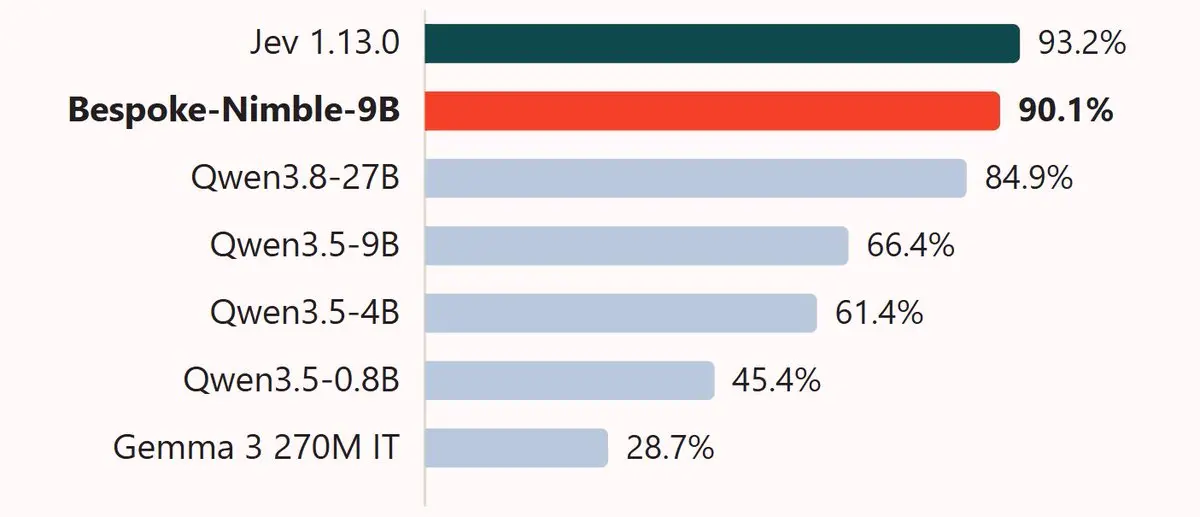
最终的效果中,Nimble会比Jev稍逊,但比基座模型要强一些。
基础Qwen3.5-9B与参考标签的一致率是66.36%,Nimble提升到90.12%,Jev为93.21%。
换句话说,AI也未必非得靠嘴吃饭。
只要判断做得靠谱,哪怕全程不开口,活也照样干得好。
参考链接:
[1]https://x.com/CompleteSkeptic/status/2099925682726002904
[2]https://github.com/bespokelabsai/nimble
[3]https://docs.typesafe.ai/introduction
[4]https://mp.weixin.qq.com/s/ND4whrG99frwJ58-fQ0TgQ
[5]https://techcrunch.com/2026/09/18/a-new-kind-of-ai-model-from-a-chatgpt-inventor-is-thrilling-developers/