谷歌的哑巴模型Jev突然爆火,
它不聊天,不写代码,不写文案,也不解释,你问它什么,它一个字都不生成。它只做一件事——判断。
发布没几天,从Hacker News,再到中文技术社区,几乎所有人都在讨论它。但大家讨论的不是它有多聪明,而是它有多反常。
诚然,一个不会说话的模型能火,这事本身就已经够反常的了。
大家最先讨论的,是它的落地场景。一个不会说话的模型能放在哪里?答案是微信。
微信要回消息、要管群、要盯风控,怎么看都该交给一个“会说话”的大模型。
怎么想怎么不合理的事情,却就这么合理地发生了。
不过具体是什么情况,还是得先从Jev本身开始说起。
01
Jev到底是个什么东西
TypeSafe AI在2026年9月16日发布了Jev。
这是一家旧金山的公司,创始人是GPT-4论文共同作者,前OpenAI研究人员迪奥戈·阿尔梅达(Diogo Almeida)。公司隐身研发了两年,出来时带着DCVC领投的4000万美元种子轮。
Jev给自己贴的标签叫系统一模型(System One Model)。
这个名字来自卡尼曼的《思考,快与慢》。其中,系统一指的是那种不过脑子的直觉判断,系统二是慢下来一步步推理。
TypeSafe的说法是,这几年所有人都在造系统二,会思考、会写长文、会解释。可软件里真正需要的判断,大多数是系统一。
Jev和ChatGPT、Claude的区别在于,Jev只会答选择题,其他模型会写作文。
Jev的用法是这样的,你给它一段状态,比如一封邮件、一行日志、一条工单、一段程序状态,然后再给它几个事先定好类型的问题,它一次性把答案全部返回,每个答案附一个概率,外加一个“我有几成把握”的置信度。
它只会答三种题。
Choice:从最多255个选项里选一个。
Score:在一个2到10级的刻度上给分。
Noul:给出一个0到1的是/否概率。
三种题可以混在同一个请求里,而且是并行算的。官方说,问一个问题还是问四个问题,延迟几乎一样。
Jev的特点是快和便宜。
普通大模型是一个字一个字往外写,写多久取决于要写多长。Jev不写字,答案的范围事先就定死了,算一遍每个选项的概率就完事。
根据Jev的官方数字,端到端响应70到500毫秒,输入每百万token收0.042美元,输出免费。它上线Vercel的AI Gateway后,24小时内被接近13%的Vercel付费团队都用上了Jev,是Vercel平台采用速度最快的新模型。
它不能聊天、不能写代码、不能写文案、不能看图、也不能解释理由。你问它“为什么不选这个”,它不回答,它只给数。
Jev还有个特点,幻觉率为0%。
这指的是它绝不会给出你选项之外的答案,绝不会拼错字段。但它完全可以选错一个选项。这一点,TypeSafe的CEO迪奥戈自己也承认过。
Jev这个名字来自杰文斯悖论。
蒸汽机效率提高、每吨煤更便宜,煤炭的总消耗反而涨了,因为便宜的动力被用到了更多地方。
以前用不起AI,是因为调一次大模型又贵又慢,为了一个芝麻大的小判断去调一次,不划算。现在Jev把单次判断压到了万分之一美元
它的训练方法叫RLCD,Reinforcement Learning for Calibrated Decisions。RLHF追求“人类爱看”,RLVR追求“程序能验证对错”,RLCD追求“概率要诚实”。
如果RLCD说有70%的把握,那就是在数学验证上有70%的概率是对的。
02
Jev成了微信的插件
Jev爆火后,社区拿它用的最多的,便是作为微信的插件了。
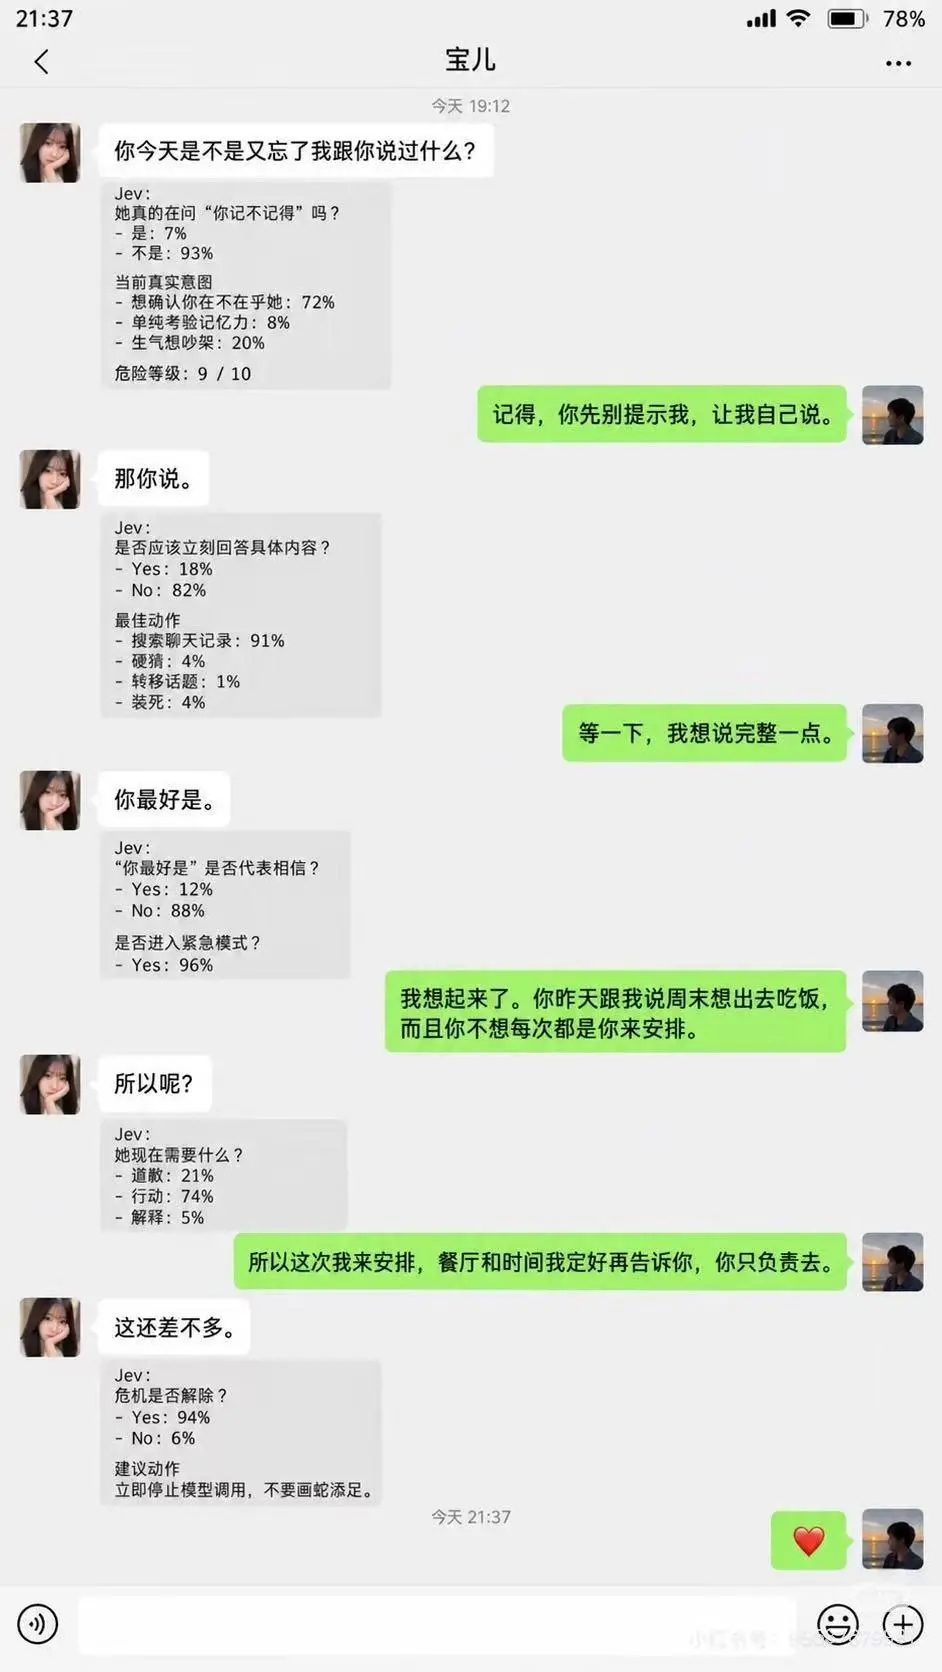
微信最难的地方就在于,如何精准触达对方的想法。比如经典的“你看着办”。那到底是该怎么办?是小改一下?是放着不管?还是大刀阔斧?
于是Jev的作用就体现出来了。
这条消息要不要回?
要不要 @ 对方?
这条是不是广告?
要不要把人踢出群?
这条要不要转人工?
这个人是不是想退款?
这段话有没有违规?
每一件,都是“从有限选项里挑一个”,而且要在几百毫秒内出结果。而这正好是Jev的形状。
那为什么不用大模型?
三个原因。
第一,慢。大模型回一条要3到30秒。微信群里的消息是滚动的,你30秒后回复,对方可能不耐烦了。Jev 70到500毫秒,够你在消息还没滚出屏幕之前接上。
第二,贵。
微信机器人通常跑在便宜的常开服务器或轻量服务器上,一次判断的成本必须低到可以忽略。用大模型逐条判断,几十万条消息就是一笔真金白银。Jev输入0.042美元每百万token、输出免费,把单条判断压到万分之一美元的量级。
第三,也是微信插件最怕的,它不能说错话。
一个自由生成的大模型塞进聊天框,随时可能冒出一句不该说的话,轻则社死,重则触发风控、直接封号。Jev根本不生成文本,它只从你给的选项里挑,从结构上就“说不出格”。
微信插件的老大难,是“自动回复”和“转人工”之间那条线。
全自动,内容控制不了;全转人工,人扛不住。Jev给每个判断配一个校准过的置信度,于是这条线变成了一道阈值,把握高就自动过,把握低就转给人,或者转给更贵的大模型。
这套“高把握自动、低把握升级”的分流,本来就是微信客服和社群运营一直想要的结构。
还有一个隐藏点,关键词命中就回复,包含“广告”就踢人,被@了就应答。这些都是关键词匹配,对方换个说法,不使用这个关键词,那么自动回复就会失效。
Jev把“关键词匹配”升级成了“语义判断”。同样是回不回、踢不踢,但判断依据并非关键词,而是用户的意图。
安装起来也是非常简单,对Codex说一句“npx skills add typesafe-ai/skills”,或者在Claude Code里加个插件市场就行。通过OpenRouter能立刻调用。
网上已经有了许多成熟的产品,比如wechat-jev-hud,它就是跑在一个Windows上的微信HUD,通过截屏、定位聊天区域,来识别文字气泡,把Jev接在OCR和叠加层中间做实时判断。
随后就会呈现出图片中的效果,对方的这条消息,有多少的概率是在说怎样的事情。

03
从生成到判断
Jev火得这么快,是因为它踩中了一个大的问题:Agent为什么还是又慢、又贵、又脆。
过去两年的AI叙事,是更长的上下文、更聪明的推理、更漂亮的回答。
可当你真把一个模型塞进每天要跑几十万次的系统里,你会发现,其中绝大多数调用,根本不需要它“说话”,只需要它“判断”。
比如一条客服工单归哪个部门,一次工具调用有没有风险,一段AI的输出有没有跑偏,下一步该点页面上哪个按钮。
这些问题从来都只有一个正确答案,而且答案的选项也早就写在自己的代码里。让一个会写作文的模型先写一段话,再由程序把它翻译回一个判断,绕了整整一大圈。
Jev想省掉的,就是这一圈。
所以社区很多人评价Jev,说它像给软件装了一句“语义if语句”。如果(if)对方出现了哪种意图,那就回应它对应的答案。
其效果也是立竿见影,通过Browser Use把Jev用在浏览器Agent里,一次请求同时选“做什么”和“点哪个元素”,订一张机票的时间能从9.5秒缩到7秒。
以及在长程任务中,把Jev做成路由中间件,让它替Agent挑该用哪个模型,也能节省很多时间。
不过“Jev取代大模型”是个伪命题。正确的做法应该是,大模型帮你想清楚判断规则,Jev在生产环境里高频、低价地执行。
它真正值钱的地方,其实在于校准。把看似模棱两可,没有标准答案的问题给量化,一眼便知道答案应该选什么。
微信插件的例子其实已经说明,它最先落地的地方,不会是那些“需要创造力”的场景,反而是那些高频、低成本、不出错的场景。
判断越频繁、越琐碎、越怕错,它就越合适。
一个猜想,当判断这件事本身变得便宜,那不如干脆就别让模型说话,只让它做判断。判断层会像数据库、像缓存一样,变成一层默认的基础设施,藏在每个应用的最底层。
微信插件只是一个开始。
但Jev的中文适配能力较差。官方文档明确标注 CJK(中日韩)准确率偏低。英文短文本表现相对稳定。
同时,Jev也没有推理能力。
Browser Use创始人实测的长程浏览器交互,Jev最终测试结果为1/20,落后于具备推理能力的GPT-5.6 Luna(17/20)。
浏览器操作涉及状态空间搜索与路径回溯,Jev不具备多步状态推演能力。
社区网友表示,Jev无法应付真实复杂的非沙盒网页。面对真实网页中未清洗的DOM、异步加载与突发弹窗,Jev缺乏应对能力。
本文来自微信公众号“字母AI”,作者:苗正,编辑:王靖,36氪经授权发布。