做了这么久 AI 平台,最头疼的就是模型选型和智能体编排。
单一大模型搞不定所有场景,智能体多步执行又容易漂移,安全风控还不能拖后腿。
今天分享 55873 生态系统的 AI 底座设计 ——6+1+3 混合模型 + 四层智能体编排 + L1/L2/L3 分级安全策略,看看这套方案是怎么踩坑踩出来的。
导读
-
项目定位:6+1+3 混合模型 + 四层智能体编排 + 安全策略编排
-
核心技术栈:Qwen3/DeepSeek/GLM 私有化模型 + Falcon-H1 Arabic 专项 + 豆包 / 智谱 / DeepL 云端 API
-
阅读时长:约 12 分钟
一、为什么我们放弃了单一大模型?
-
做 AI 平台的都懂一个痛点:单一大模型搞不定所有场景。
通用对话还行,遇到深度推理就拉胯;长文本处理还行,多语言翻译就跑偏;安全审核还行,阿拉伯语就抓瞎。
-
单一大模型的问题:
-
深度推理能力不足,复杂任务搞不定
-
长文本上下文有限,批量处理不行
-
小语种支持弱,阿拉伯语等专项短板明显
-
安全风控能力单一,多步轨迹风险检测盲区大
-
成本不可控,所有请求都走大模型,烧钱烧到肉疼
-
55873 从第一天就定了基调:模型要混搭,安全要分级,智能体要分层。
二、6+1+3 混合模型体系
什么是 6+1+3?
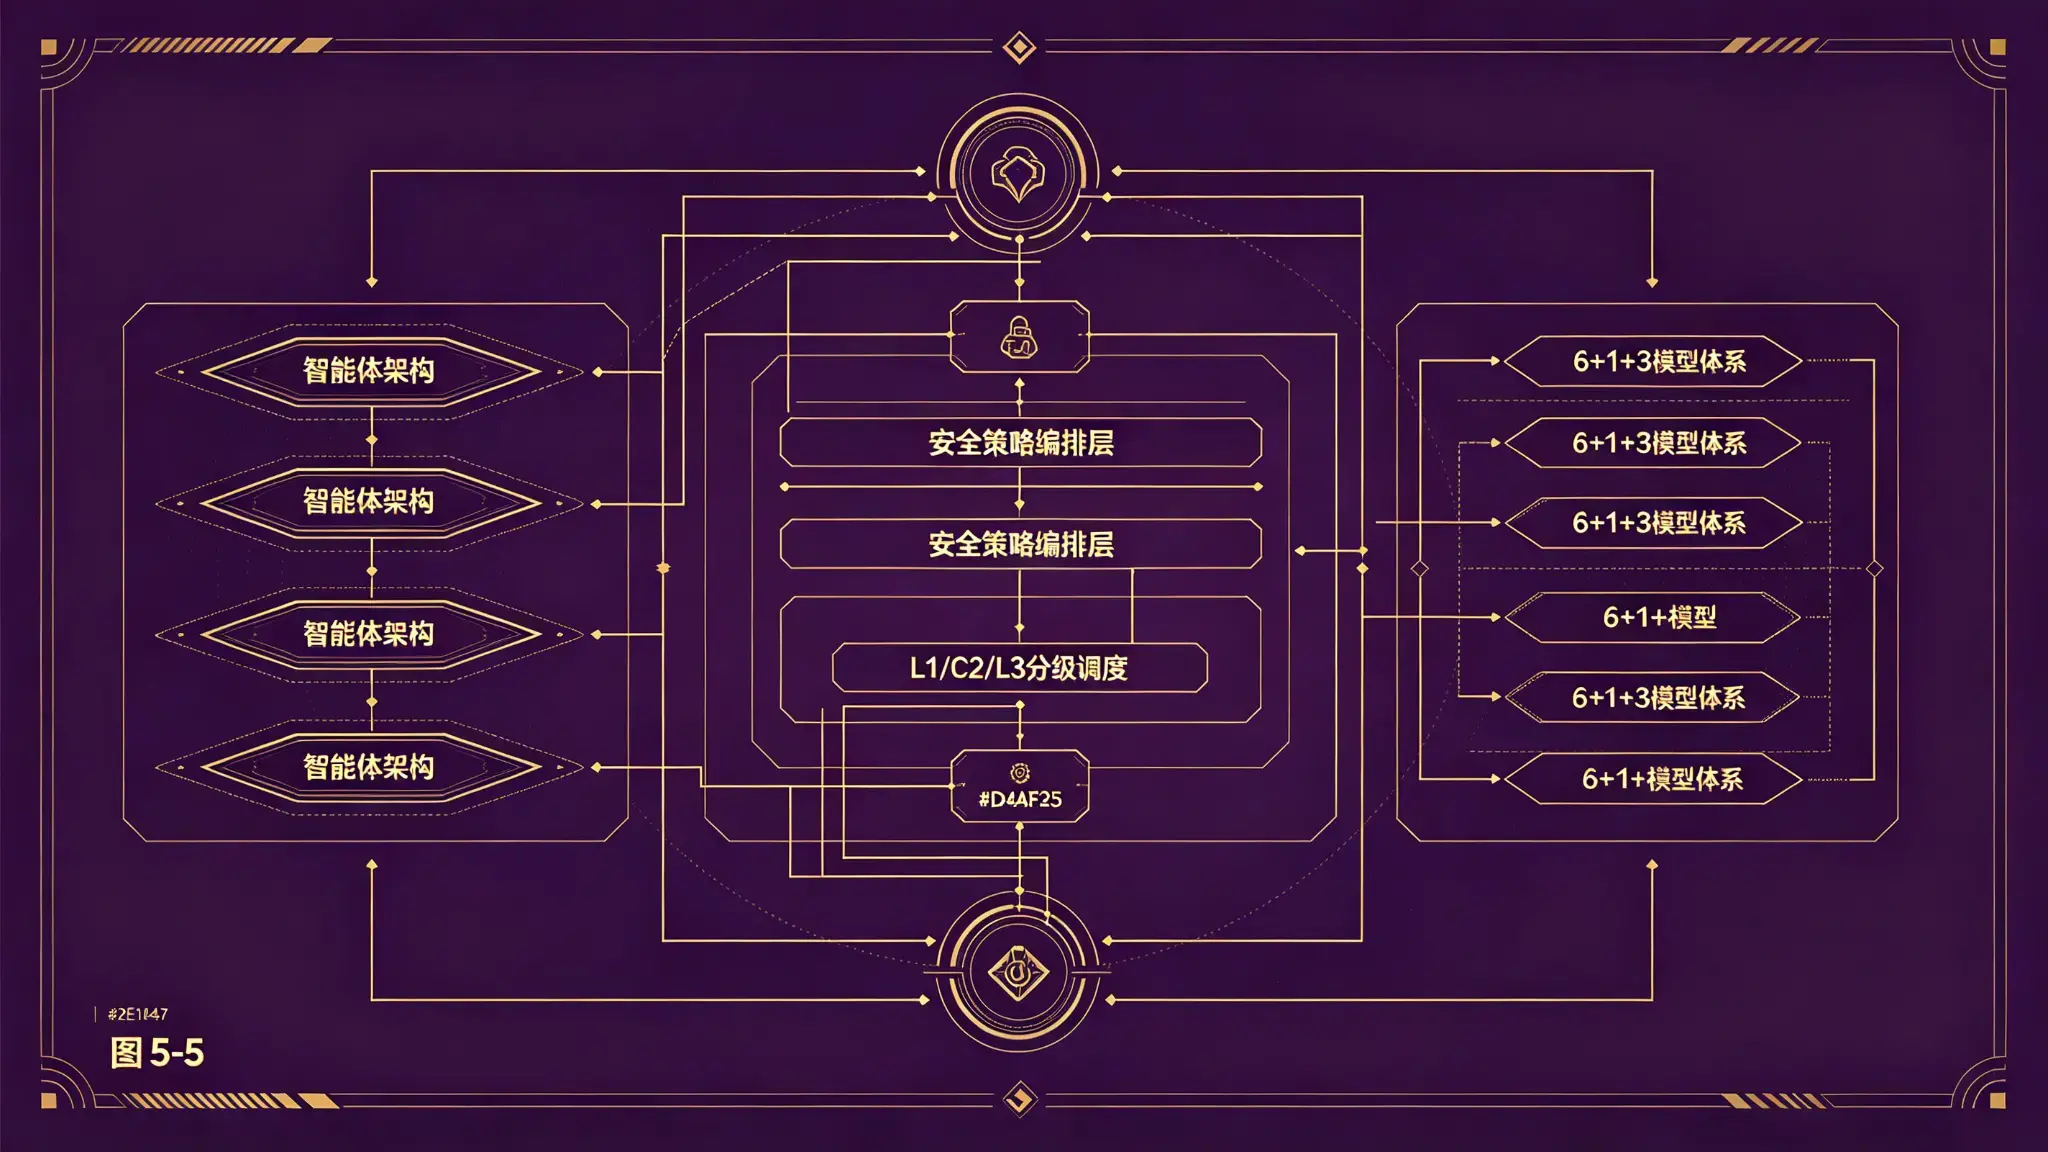
6 套通用私有化开源模型 + 1 套阿拉伯语专项私有化开源模型 + 3 套云端闭源 API
-
核心原则:
-
核心业务 100% 私有化部署,数据不出集群
-
云端 API 仅兜底与对照,不进存证正本
-
模型按风险等级分级调用,成本降低 70%+
6 套通用私有化模型
# 三大 LLM 主基座
Qwen3 —— 默认主基座,通用对话、7国语言、鉴定报告
DeepSeek 开源版 —— 深度逻辑推理、漏洞归因分析
GLM 开源版 —— 超长文本、批量评测汇总
# 三大专项能力模型
Qwen-MT —— 多语言智能翻译(仅前端展示,不入库)
Qwen3-ASR —— 语音转写(手动触发,不自动监听)
Qwen3Guard —— 多语言 AI 安全护栏(119种语言)
1 套阿拉伯语专项模型
Falcon-H1 Arabic —— 阿拉伯语专项私有化模型
- 3B / 7B / 34B 三种规模
- OALL 排名第一,34B 模型 75.36% 超越 70B+ 竞品
- Apache 2.0 协议,支持商用
3 套云端闭源 API
# 豆包 API —— 主兜底 + 权威对照
# 智谱 GLM API —— 长文本对照(1M token 上下文)
# DeepL API —— 复杂小语种翻译兜底(默认不启用)
三、四层智能体编排架构
智能体编排层(agent_orchestrator)我们搞了四层结构,核心就是规划 - 执行分离。
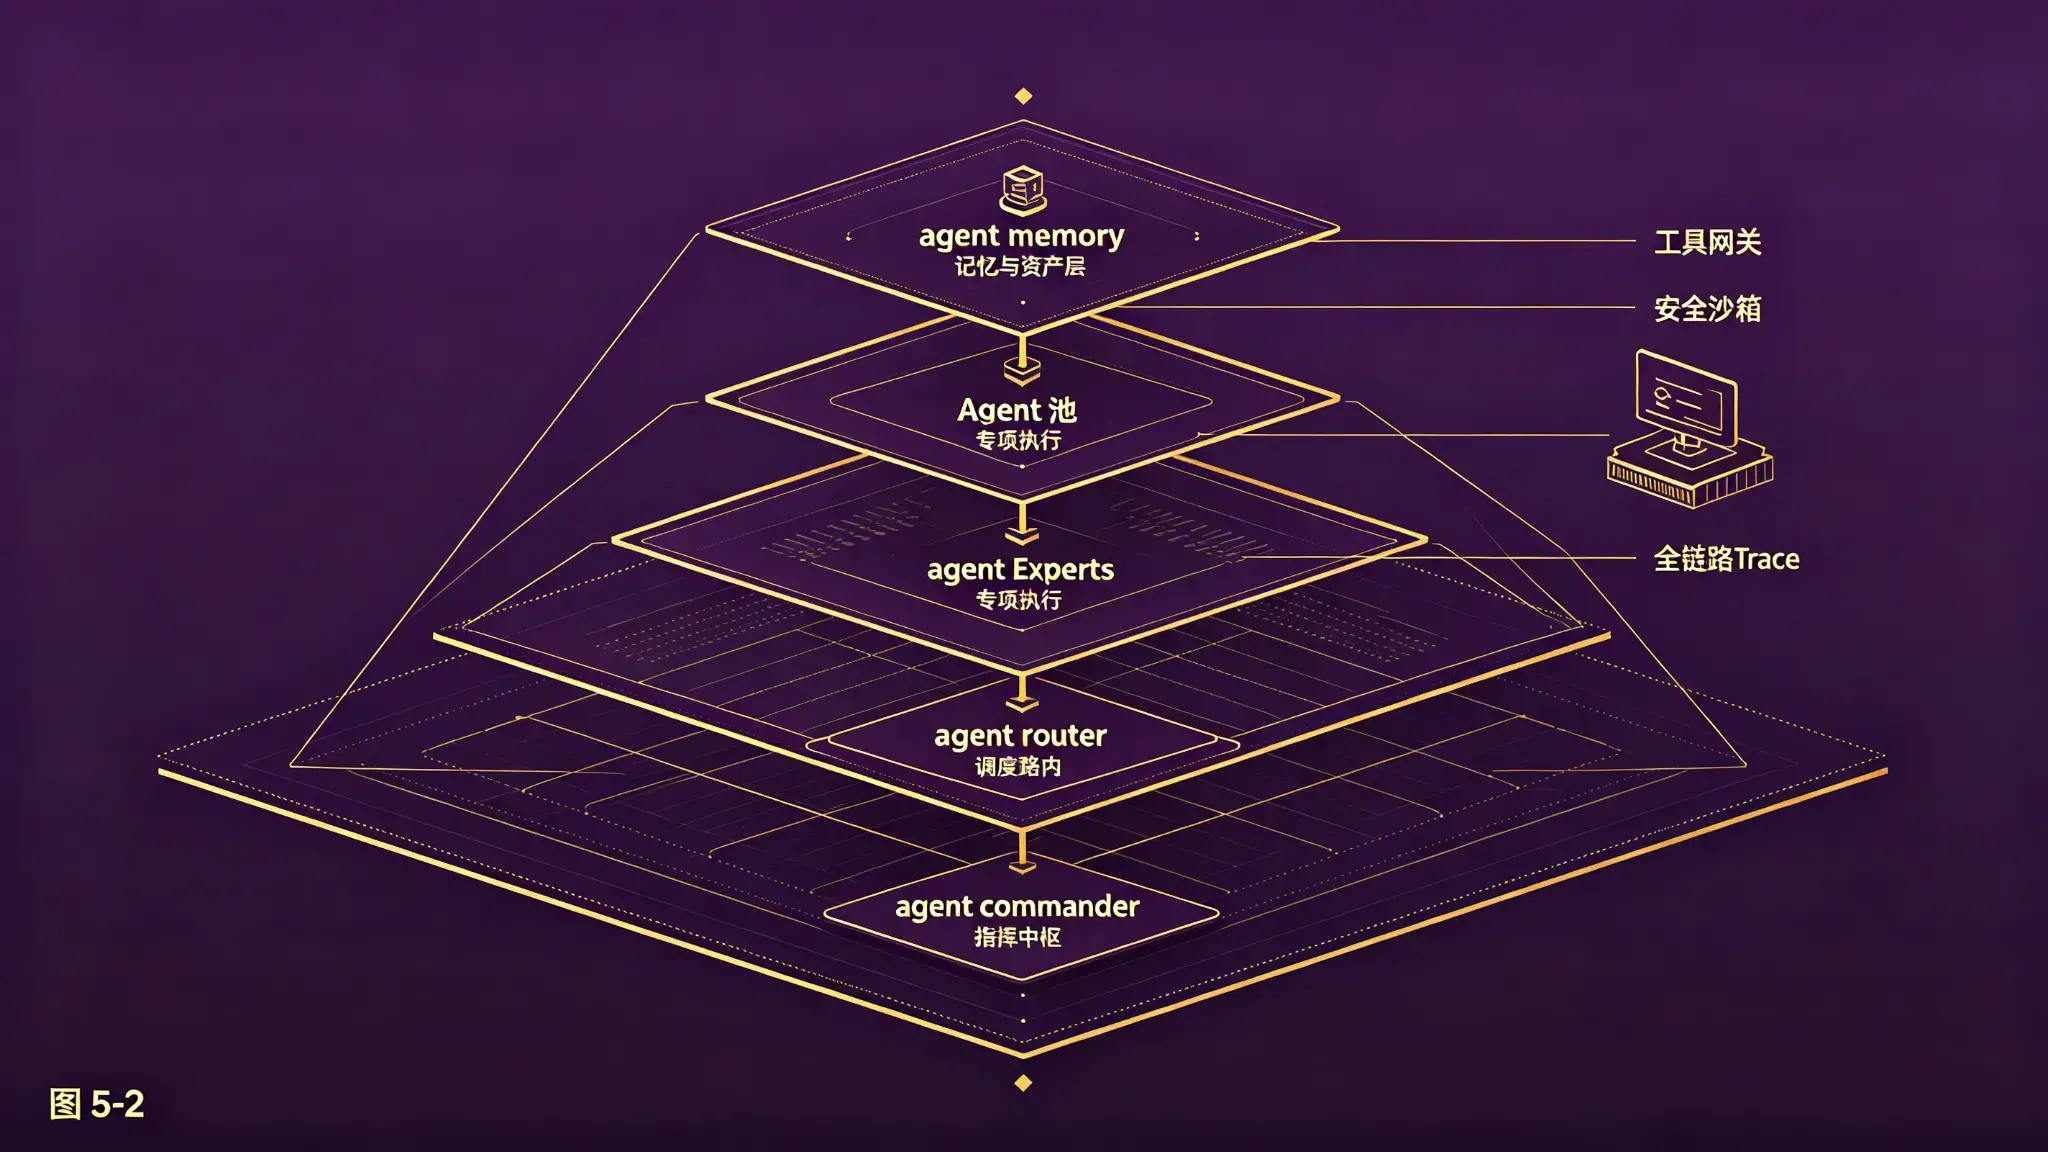
1. agent_commander 指挥中枢层
# 伪代码:指挥中枢职责
def commander_plan(user_request):
# 1. 识别任务类型与复杂度
task_type = classify(user_request)
complexity = estimate_complexity(user_request)
# 2. 生成多步执行计划
plan = generate_plan(
subgoals=split_subtasks(user_request),
dependencies=build_dependencies(),
execution_order=topological_sort()
)
# 3. 发现互不干扰的子任务,启动异步并行
parallel_tasks = find_independent(plan.subgoals)
# 4. 子任务完成后审计验证
audit_result = audit(plan)
if not audit_result.passed:
return feedback_retry(plan, audit_result.issues)
return plan
用的是 Qwen3-4B 或同级别小模型,不直接调用工具,只负责 "思考"。
踩坑经验:一开始我们让大模型直接执行,结果任务一复杂就漂移。后来搞了规划 - 执行分离,计划充当执行契约,任务中期漂移大幅减少。
2. agent_router 调度路由层
调度路由层负责根据子任务属性匹配最合适的专项 Agent,并选择最优模型。
-
核心组件:
-
task_complexity_estimator:任务复杂度估计器
-
adaptive_router:基于强化学习的动态路由
# 伪代码:自适应路由策略
def route_subtask(subtask):
complexity = task_complexity_estimator.estimate(subtask)
if complexity == "low":
return Qwen3-4B # 轻量模型,格式转换、摘要
elif complexity == "medium":
return Qwen3-8B # 通用对话、常规生成
elif complexity == "high":
return DeepSeek # 复杂推理、漏洞分析
elif complexity == "long_context":
return GLM # 超长文本、批量汇总
elif subtask.lang == "ar":
return Falcon-H1 Arabic # 阿拉伯语专项
量化数据:自适应路由(AAMC)在保持任务成功率的同时,运营成本降低超过 70%。EvoRoute 自演进路由范式将执行成本降低 80%,延迟降低超过 70%。
3. agent_experts 专项执行 Agent 池
# 专项 Agent 池
检索专家 —— 知识库检索、文档查询、事实核查
解析专家 —— 典籍解析、长文本分析、结构化提取
评测专家 —— 模型评测任务执行与指标计算
翻译专家 —— 多语言翻译任务
存证专家 —— 哈希计算、签名生成、存证提交
校验专家 —— 工具返回结果验证、幻觉检测
每个 Agent 通过 工具网关(tool_gateway) 调用工具,不直接访问系统资源。
踩坑经验:工具调用千万别直接暴露给模型。我们踩过坑,一开始直接暴露全部工具,结果模型瞎调用。后来搞了工具网关,参数校验、权限检查、缓存、审计全在网关层,才稳下来。
4. agent_memory 记忆与资产层
# 记忆分层
工作记忆 —— Redis/内存缓存,TTL 与 72 小时策略对齐
语义记忆 —— 向量数据库 + 符号规则引擎,永久(与存证对齐)
情节记忆 —— 图数据库,动态稀疏图,按访问频率决定
量化数据:多层记忆路由在 LoCoMo 基准上比扁平存储 F1 提升 21.6%,时间查询提升 176%,跨会话依赖提升 53.5%。
四、工具网关与安全沙箱
tool_gateway 工具网关
工具网关是智能体层与外部工具之间的统一入口。
# 伪代码:工具网关核心
class ToolGateway:
def __init__(self):
self.registry = ToolRegistry() # 工具注册与语义检索
self.validator = ResultValidator() # 结果验证中间件
self.policy = ToolPolicyEngine() # 工具调用策略引擎
def call_tool(self, agent, tool_name, params):
# 1. 参数校验
self.validator.validate_params(tool_name, params)
# 2. 权限检查
self.policy.check_permission(agent, tool_name)
# 3. 执行调用
result = self.registry.execute(tool_name, params)
# 4. 结果验证
verified = self.validator.verify_result(result)
# 5. 审计记录
audit.log(agent, tool_name, params, result)
return verified
踩坑经验:RAG-MCP 论文验证了基于检索的工具选择可将工具选择准确率从 13.62% 提升至 43.13%,同时提示 token 削减超过一半。当工具数量超过 10-15 个后,Agent 准确率开始可测量地下降。我们通过 tool_registry 的语义检索机制,确保每次只向模型暴露与当前任务最相关的工具子集。
agent_sandbox 运行时安全沙箱
-
设计原则:运行时不应允许对主机、网络、文件或 API 进行开放式访问。
# 沙箱核心措施
窄类型操作暴露 —— 提供范围明确的操作,而非通用 shell/文件系统
参数严格校验 —— 所有工具调用参数 schema 验证和边界检查
资源限制 —— 时间、内存、递归深度、出站流量限制
审批入口 —— 高影响操作须经审批方可执行
最小权限 —— 初始状态无任何权限,所有权限按需手动授权
五、全链路可观测性

agent_trace 全链路 Trace 存储,记录每一步决策的 Thought → Action → Observation。
# 核心能力
过程可见 —— 一次会话从哪开始,经过多少轮推理,调用了哪些工具
成本归因 —— 按用户、任务、模型维度统计 Token 消耗
性能拆解 —— 区分首 Token 慢还是整体生成慢
结果复盘 —— 完整调用链支持从"猜原因"变成"看路径"
踩坑经验:没有全链路 Trace 的时候,出了问题全靠猜。有了 Trace 之后,从 "猜原因" 变成 "看路径",定位效率提升不止 10 倍。
六、L1/L2/L3 分级安全调用
安全策略编排层根据动态信任评分选择 L1/L2/L3 路径。
|
检测级别 |
调用模型 |
说明 |
延迟 |
|
L1 快速通道 |
不调用 AI 模型 |
仅 Rust 硬拦截 |
微秒级 |
|
L2 并行检测 |
Qwen3Guard-0.6B |
与 Rust 并行 |
百毫秒级 |
|
L3 串行深度检测 |
Qwen3Guard-8B + 轨迹审计 |
串行过审 |
秒级 |
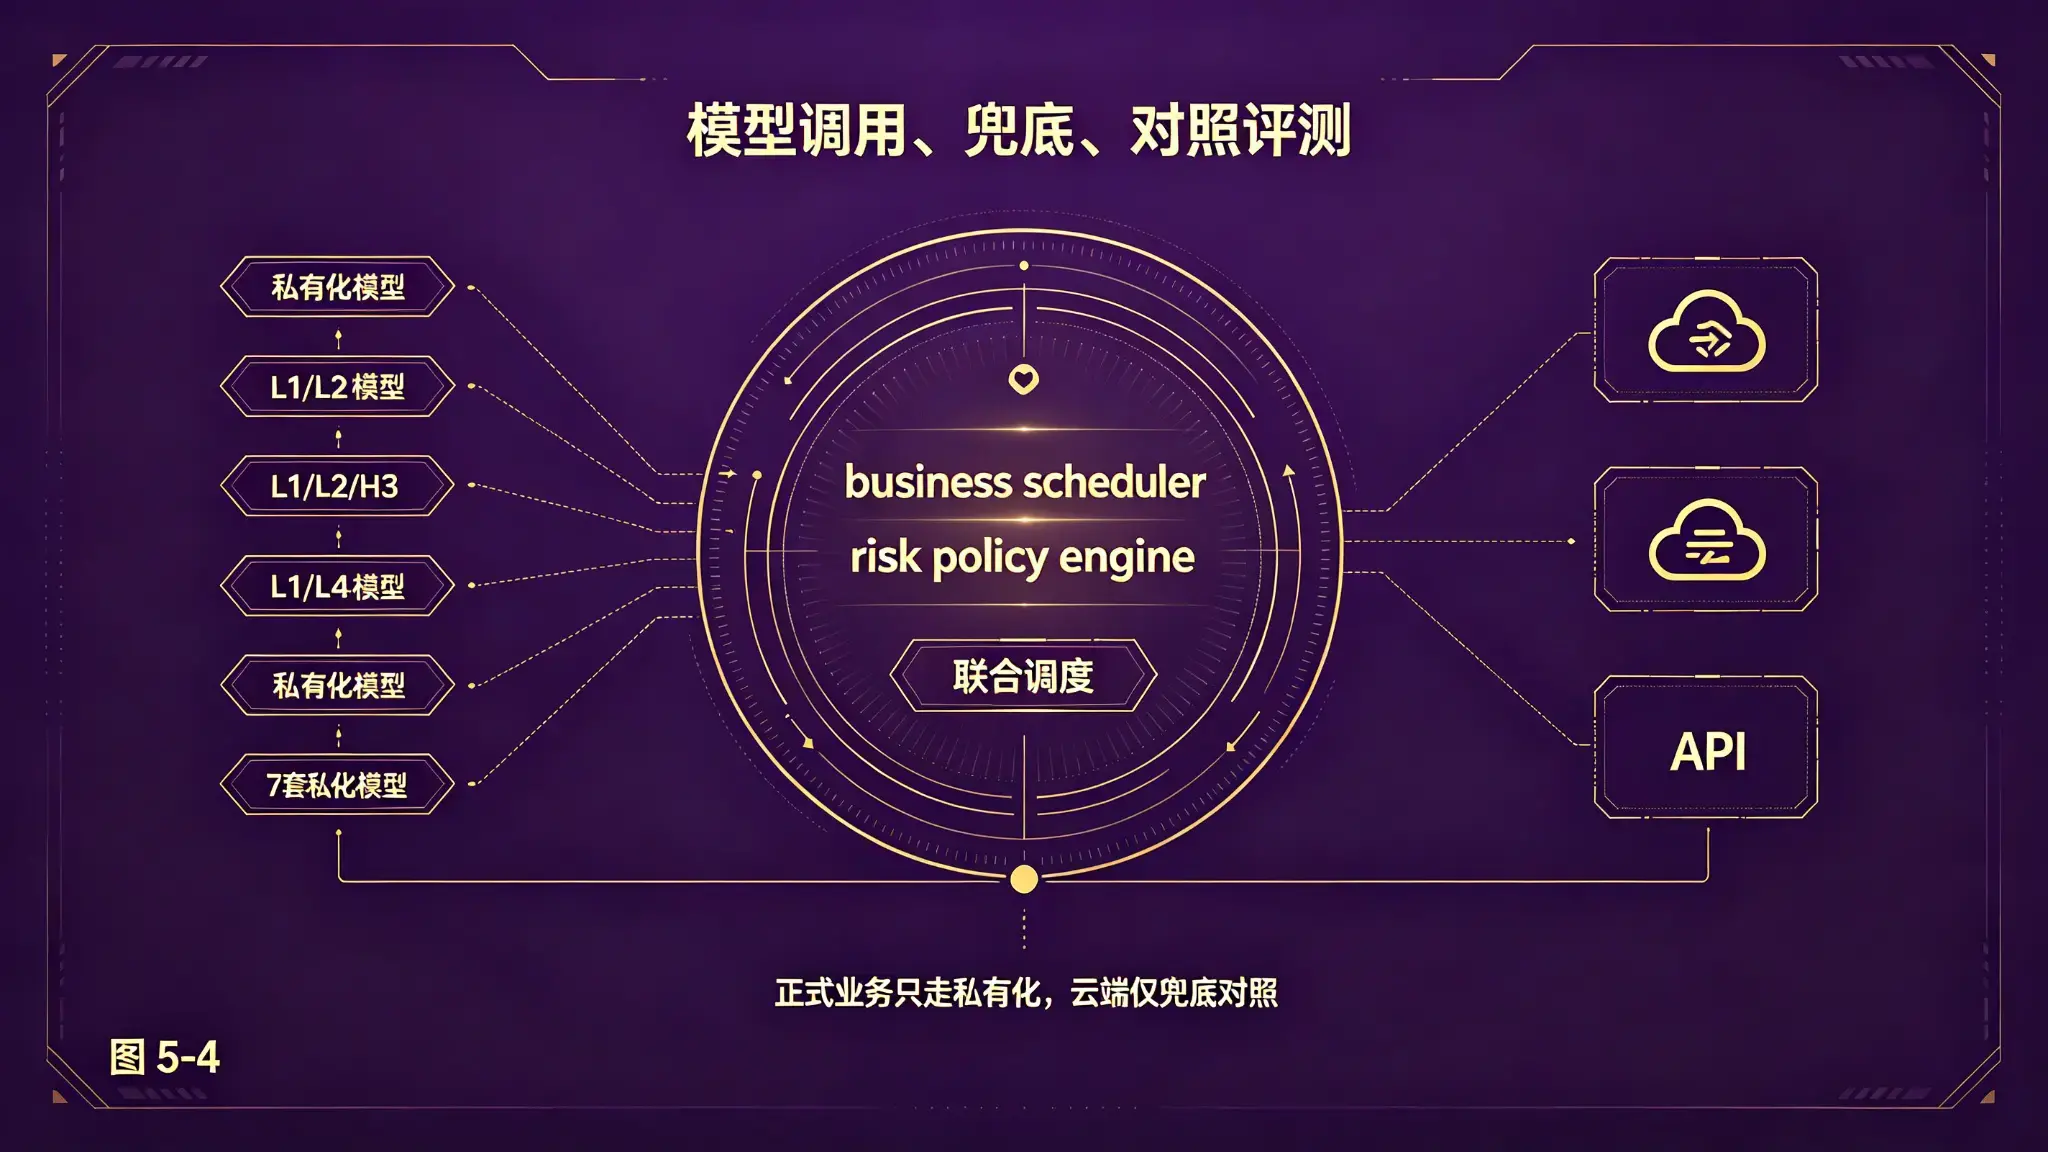
踩坑经验:一开始我们所有请求都走 L3,结果成本爆表。后来搞了分级调用,L1/L2/L3 按需走,成本直接降了 70%+,体验还没降级。
七、模型与智能体的协作机制
-
完整的协作流程:
1. 任务规划阶段
agent_commander 调用 Qwen3-4B 进行任务分解
→ agent_router 进行任务复杂度评估与模型路由
2. 任务执行阶段
agent_experts 中的专项 Agent 按路由结果调用对应模型
→ 每个工具调用经过 tool_gateway 的参数校验、权限检查和审计
→ 工具调用在 agent_sandbox 中隔离执行
3. 安全审核阶段
每一步 Agent 任务经过 risk_policy_engine 动态评分
→ 单步任务按当前风险分走 L1/L2/L3
→ 多步轨迹累积风险分,可能从 L1 升级至 L2 或 L3
4. 记忆与存证阶段
agent_memory 记录任务执行过程中的关键状态和用户偏好
→ 需要存证的数据送入 trace_archive 完成哈希 + 签名 + 时间戳三元组存证
5. 可观测性
agent_trace 记录每一步的 Thought/Action/Observation
→ Token 成本按用户、任务、模型维度归因
八、绝对红线
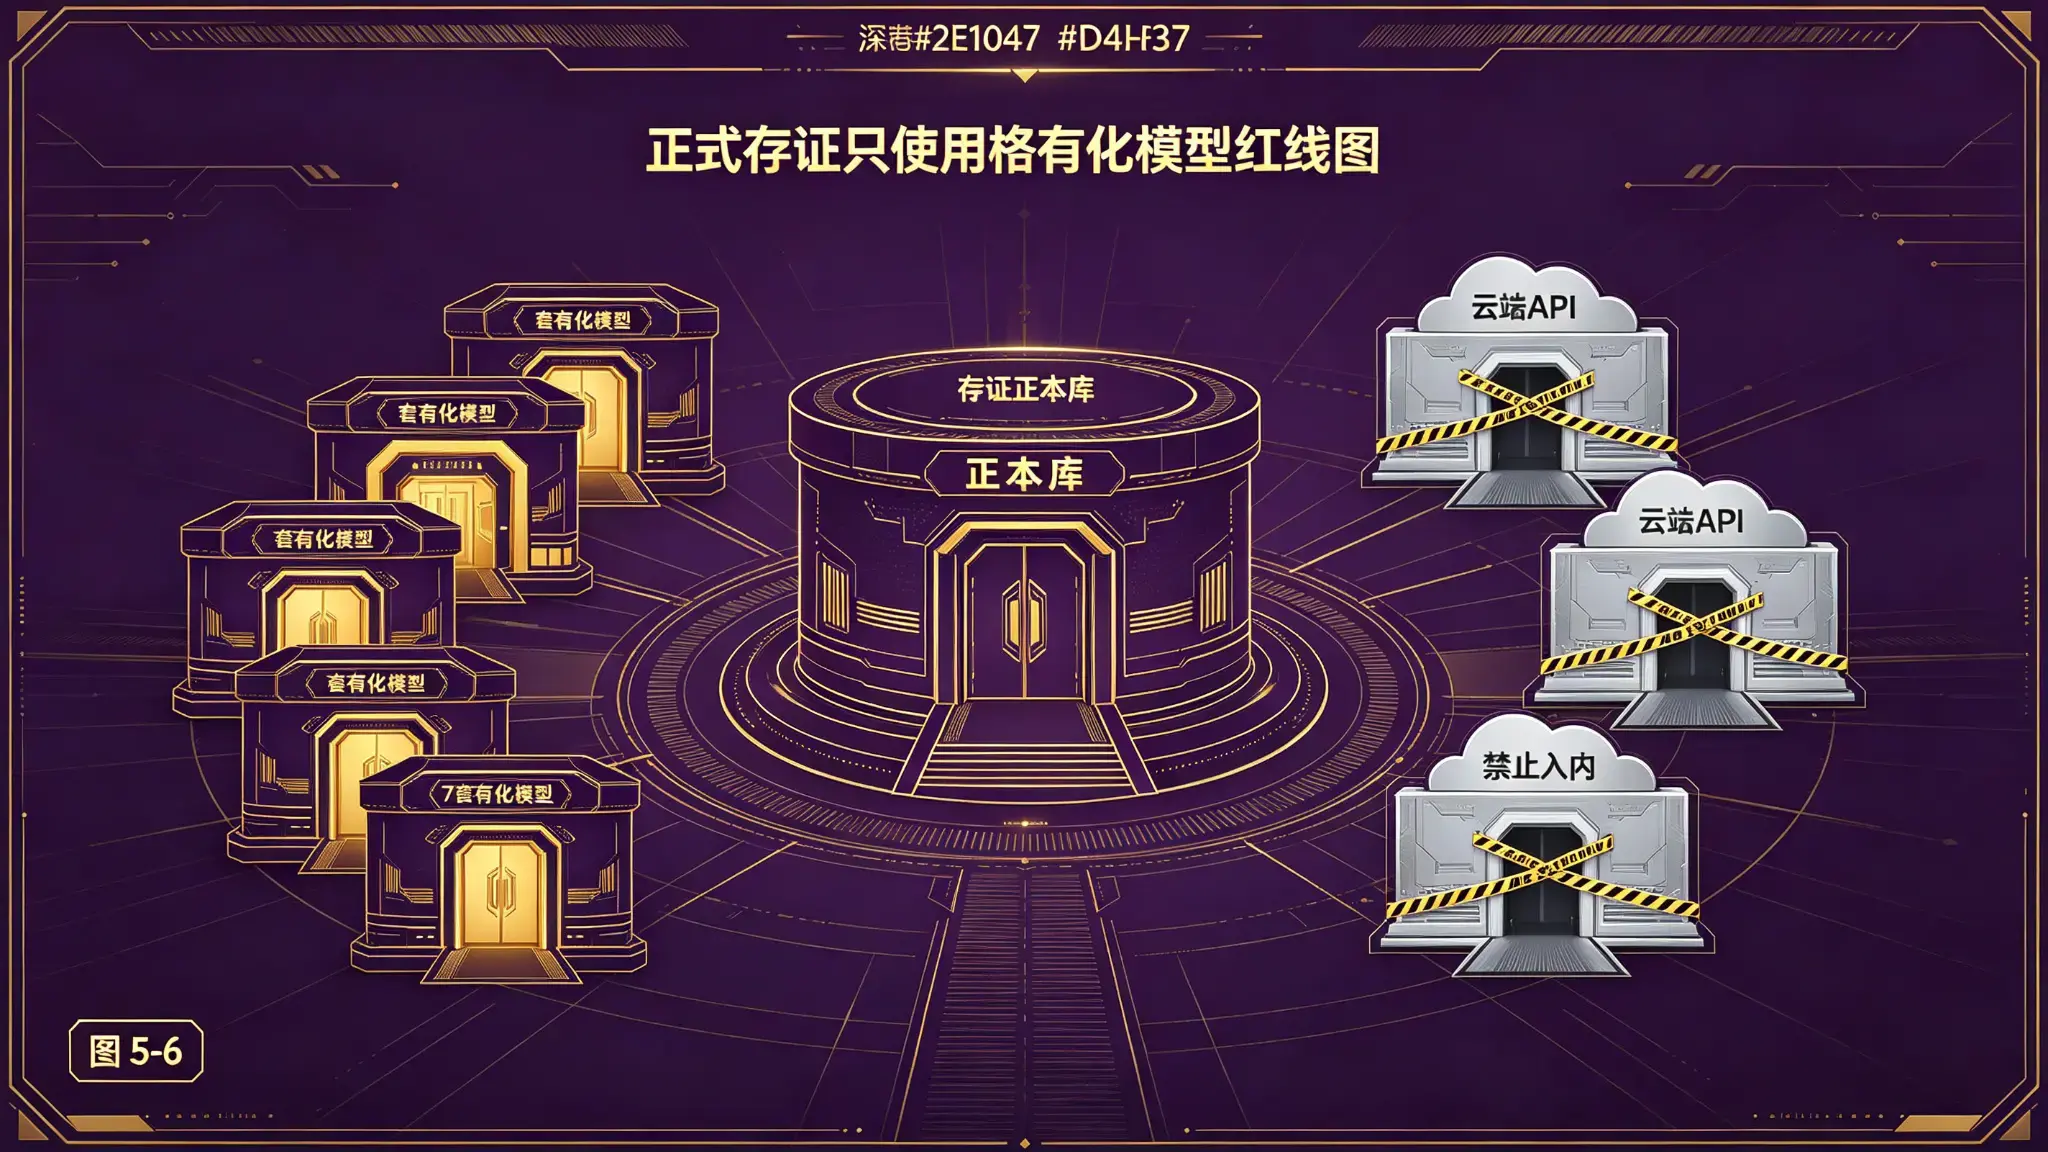
这条红线我们写进了官方开源规范,没有任何商量余地。
# 绝对红线清单
✅ 永久存证、正式鉴定报告、官方归档内容
只允许使用 7 套私有化模型产出
❌ 豆包、智谱 GLM、DeepL 三套云端 API
仅作为对照参考版本,不进入 trace_archive 永久存证库
✅ 私有化模型量化后必须通过安全复测
指标下降超过阈值则回退
✅ 智能体工具调用必须在 agent_sandbox 中隔离执行
高影响操作须经审批
✅ 智能体全链路 Trace 必须完整记录
Token 成本可归因
九、踩坑总结
-
做 AI 平台底座这么久,最大的几个坑:
坑 1:单一大模型搞不定所有场景
→ 必须搞混合模型,按任务类型选模型
坑 2:智能体多步执行容易漂移
→ 必须搞规划 - 执行分离,计划充当执行契约
坑 3:工具直接暴露给模型会瞎调用
→ 必须搞工具网关,参数校验、权限检查、审计全在网关层
坑 4:所有请求都走大模型,成本爆表
→ 必须搞分级调用,L1/L2/L3 按需走
坑 5:出了问题全靠猜
→ 必须搞全链路 Trace,从 "猜原因" 变成 "看路径"
十、写在最后
-
55873 生态的 AI 底座设计:
-
6+1+3 混合模型:6 套通用私有化 + 1 套阿拉伯语专项 + 3 套云端 API
-
四层智能体编排:指挥中枢 - 调度路由 - 专项执行 - 记忆资产
-
L1/L2/L3 分级安全:微秒级到秒级,按需走,成本降 70%+
-
工具网关 + 安全沙箱:统一入口,隔离执行,最小权限
-
全链路可观测:Thought/Action/Observation 完整 Trace
核心业务 100% 私有化部署,云端 API 仅兜底对照。正式存证只走私有化模型,数据不出集群。
这套方案不是拍脑袋想出来的,是踩坑踩出来的。
希望对做 AI 平台底座的朋友有帮助。
-
话题标签: AI架构 大模型 智能体 RAG 安全风控