
AI 写代码的能力经常能让开发者「双手离开键盘」,但对于设计师而言,AI 生成的图片距离能交稿总是差了好几步。
在图像设计的工作流中,人物需要抠图、素材需要改字、各种商品的摆放要时不时调整,但包装上的字、瓶身的形状不能跟着变。如果需求不停调整,还得继续修改局部,让整张图保持协调。
这些细节决定了 AI 生图能否进入真正的创作流程。对设计师、电商运营和内容创作者来说,如今图像模型的瓶颈,在于每一次提出的修改指令能否准确完成。
本周日,阿里千问正式开源图片生成模型 Qwen-Image-2.1,以小模型的体量解决了大部分生产力难题:它实现了文生图与图像编辑一体化,原生支持透明图生成,最高可以接收 10 张参考图,还进一步强化了局部编辑、人像与商品保真。
它成为了千问图像系列当前最平衡、性价比最高开源生图模型。公开评测结果显示,Qwen-Image-2.1 取得开源模型第一,得分甚至超过了 Nano Banana 2.0。要知道,这个模型的视觉生成部分参数量仅为 7B。
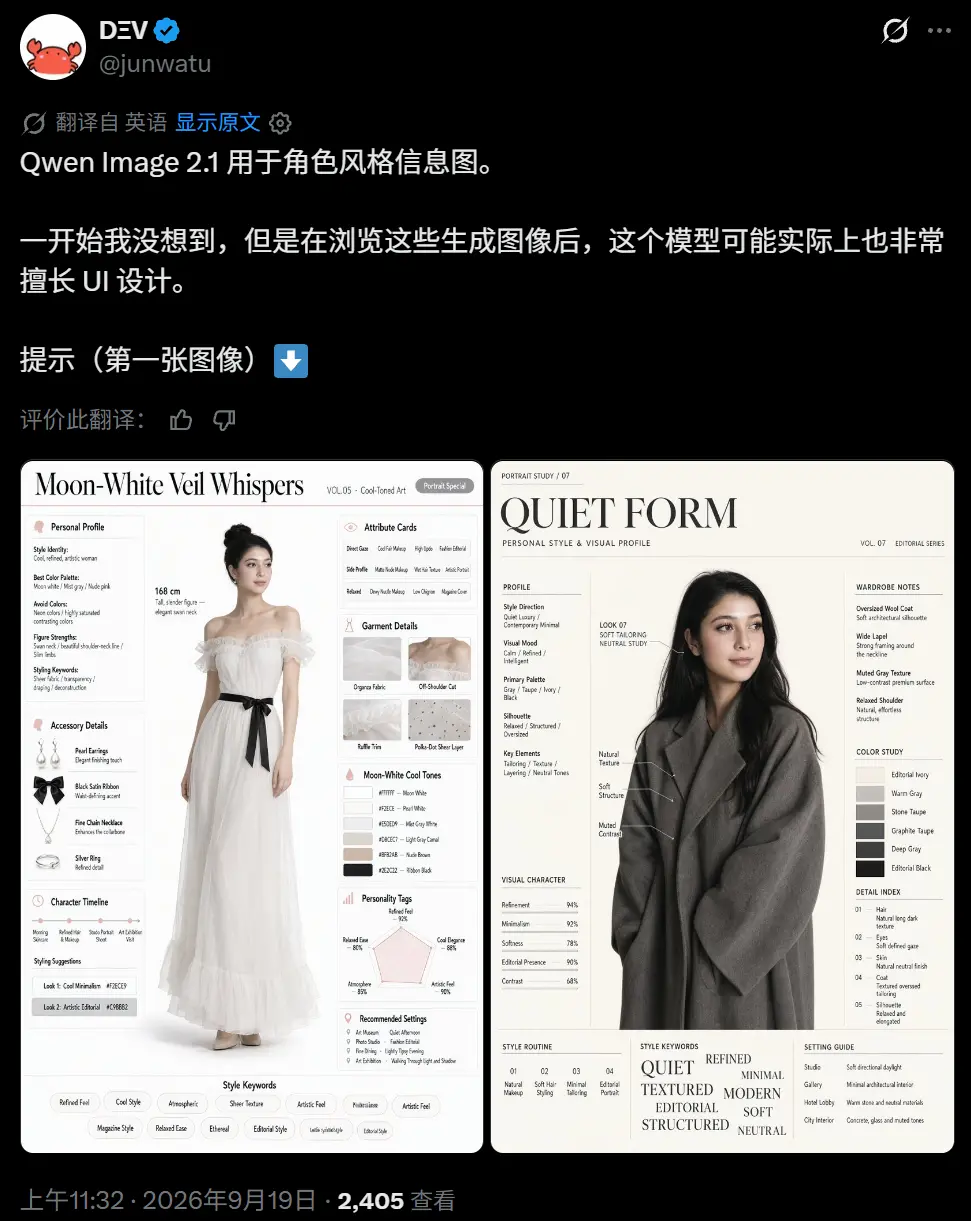
在 X 等平台上,已经有提前获得体验资格的用户放出了生成结果,大家一阵好评。有包含大量文字内容的效果图:
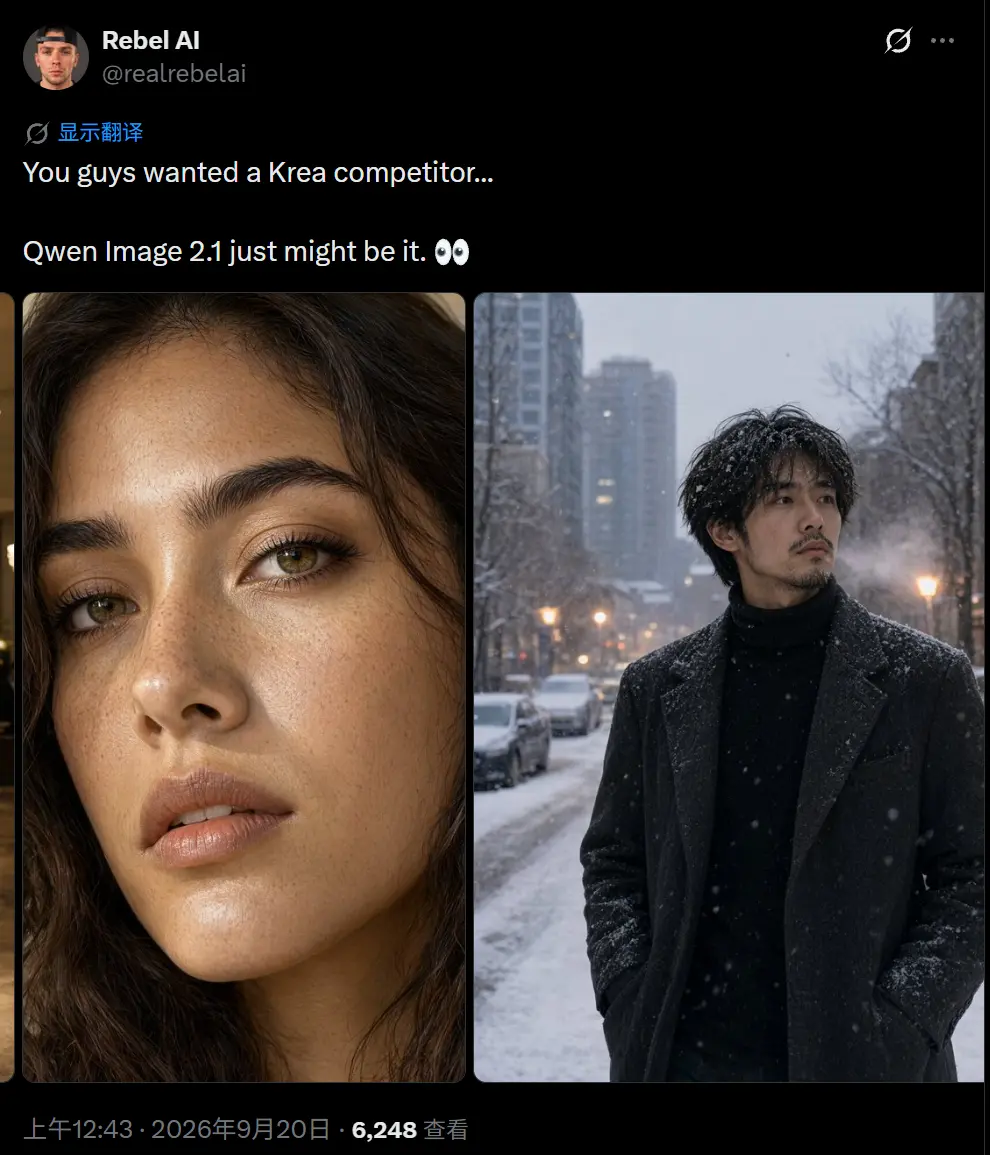
生成出真实照片质感图片的:
也有尝试各种不同滤镜、打光风格的:

人们认为 Qwen-Image-2.1 在指令遵循、抽卡成功率以及实际效果上都令人印象深刻。基于新模型的能力,我们已经可以串起素材生成、组合与修改的工作流,用 AI 来解决很多复杂的修图问题。
能力与效率
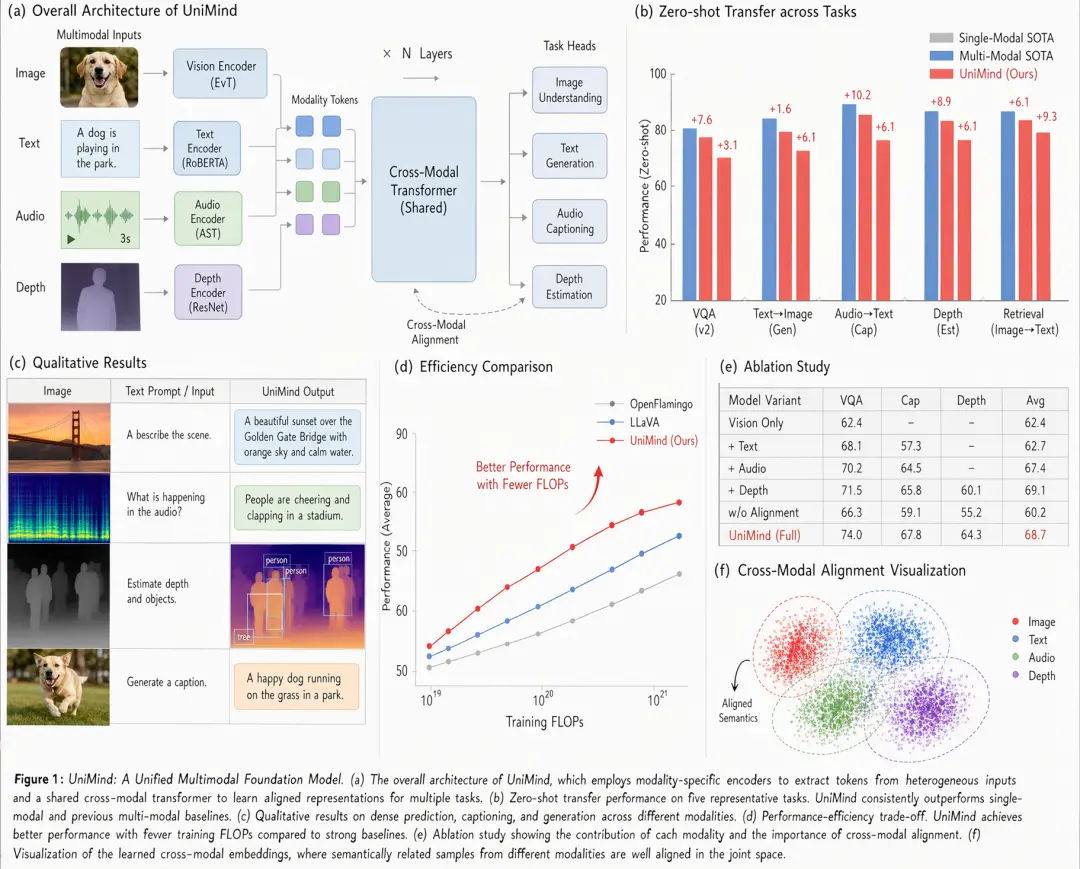
据介绍,Qwen-Image-2.1 的视觉生成部分采用 20 层 Single-Stream DiT,参数量为 7B,原生支持 2K。该模型在评测基准中实现了超越体量的水平:Qwen-Image-2.1 的总分为 60.28。相比之下,Nano Banana 2.0 为 59.82,GPT Image 1.5 为 59.65。它已经能够与多款闭源图像模型同场竞争。
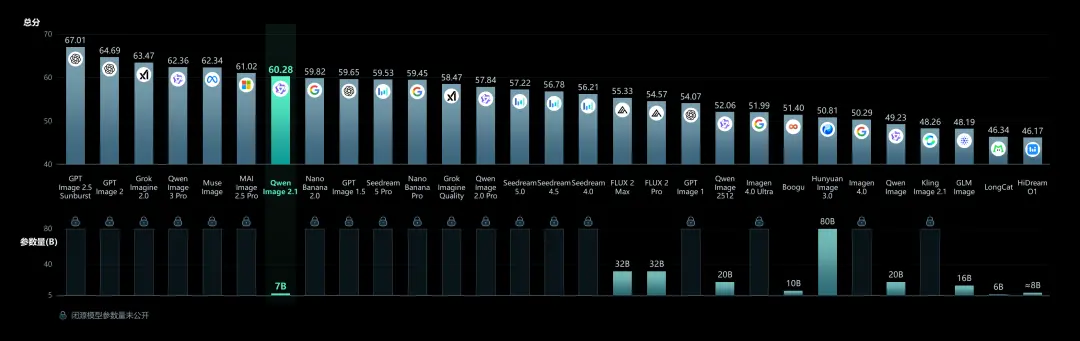
Qwen-Image-Bench 评测图表。
视觉生成部分仅有 7B 参数,也让这样的能力水平更值得关注:其在较小的生成模块中同时容纳了生图、透明素材生成与多图编辑能力(生成和编辑统一管线),为开发者部署和定制图像工具提供了更轻量的起点。
性能不错的同时,Qwen-Image-2.1 还对模型的推理过程进行了优化,核心思路是减少不必要的重复计算。
在一次图像编辑中,输入的参考图和编辑指令不会随着每一步生成而改变。因此,新模型使用混合粒度注意力结构,文本部分(系统前缀、编辑指令)遵循传统 Token 级因果掩码,逐词进行严格的序列计算以保证语义逻辑理解的连贯性,图像生成部分则采用 Chunk 级掩码,并通过 KV Cache 的机制在首步计算后缓存这些静态上下文,供后续生成步骤复用。
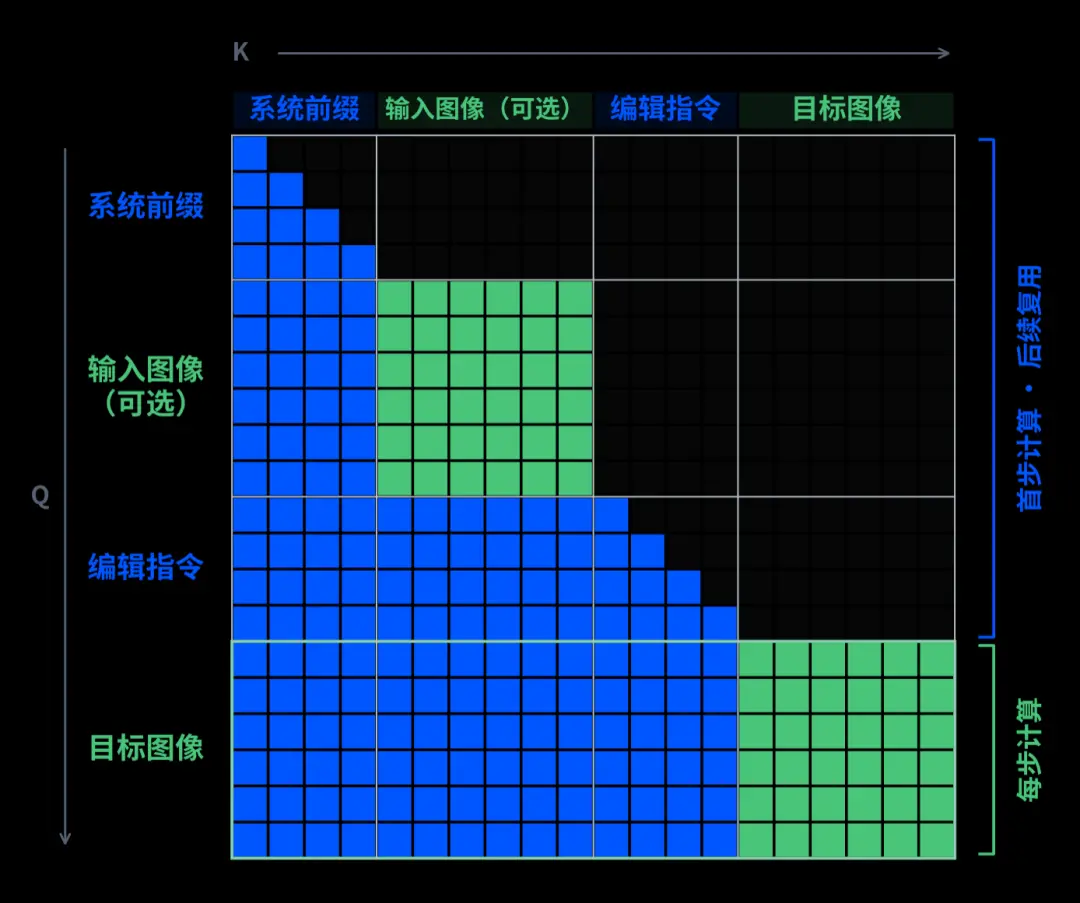
这意味着 AI 现在会先处理好参考材料,在逐步生成目标图片时重复利用已有结果,这种优化在多图片输入时效果更为明显,有助于提升推理效率、降低显存开销。
因为现在 Qwen-Image-2.1 最多支持 10 张参考图了,这项优化就显得至关重要。输入内容越丰富,如何处理参考信息、控制重复计算就越值得关注。至于具体能节省多少时间和显存,还需要结合硬件、精度、分辨率与输入数量来判断。
直接生成可用透明素材
要说新版本 Qwen-Image 最贴近设计需求的能力,那就是透明图生成了。
常规的图片素材通常带有完整背景。要把其中的主体用到海报、商品详情页或另一张图片里,往往需要先抠图,处理轮廓、缝隙和边缘。透明图片则包含额外的透明度信息,能让背景从主体周围或部分区域透出来,方便后续叠放和组合。
Qwen-Image-2.1 原生支持透明图生成,可以依据提示词自动决定生成的是普通图片还是透明图,用户在描述素材时就能提出透明背景的要求。目前展示的样例包括节庆插画、人物素材、装饰元素,以及由多个对象构成的复杂组合,对应的都是设计工作里常见的素材需求。我们也尝试了一下:
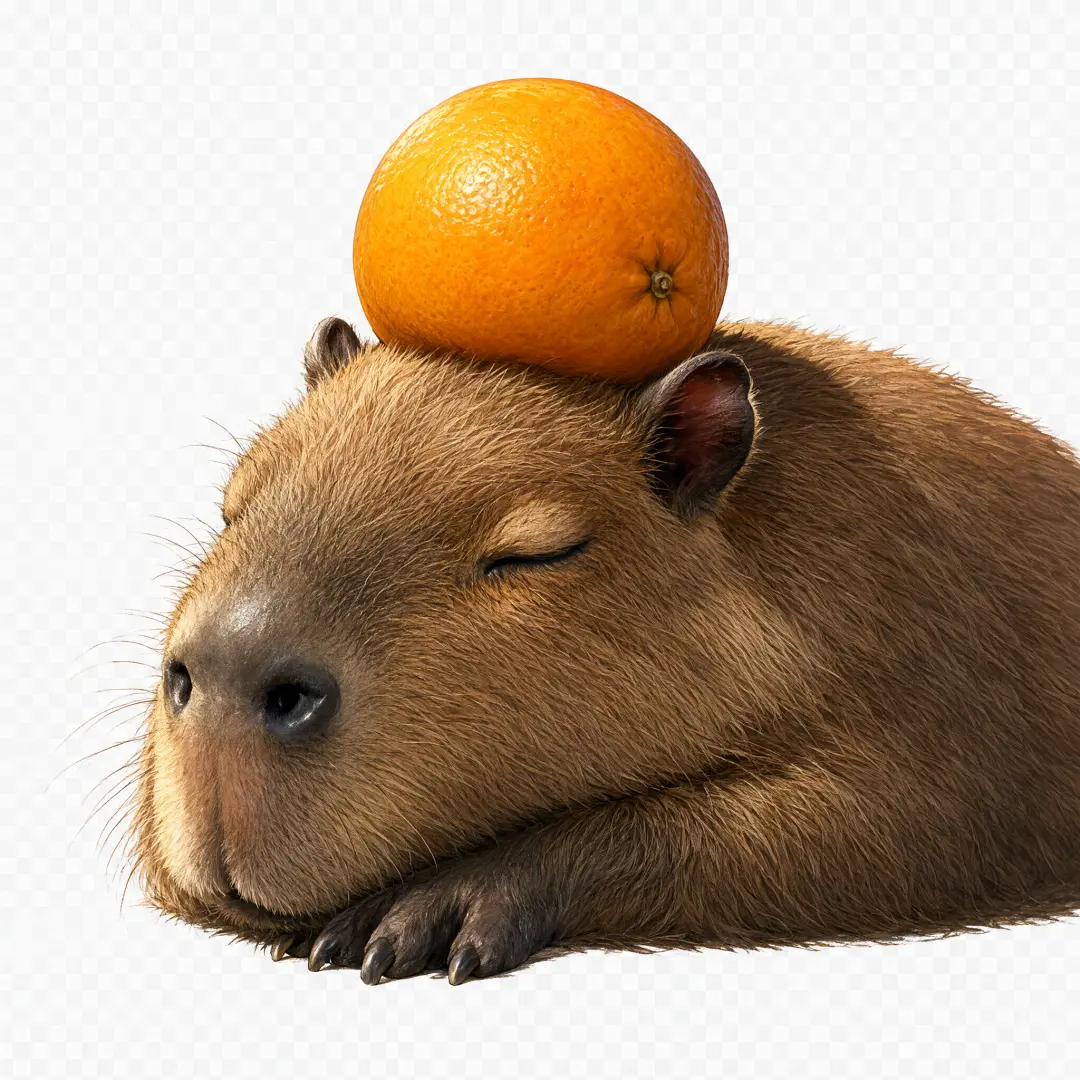
对于创作者来说这是个好消息,现在我们可以得到直接可用的素材了,工作直接少了几道工序。
当然,这些透明素材生成之后也能继续修改。比如同一个插画人物可以调整表情,图片中的文字可以修改内容。编辑对象既可以是人物的视觉细节,也可以是素材中的文字。
这与设计时的真实修改需求很接近:活动名称换了,图案仍然需要保留;表情要更轻松一些,人物仍然要能被识别为同一个角色。生成与编辑被放进同一模型后,这些后续要求也有了统一的处理入口。
当然,Qwen-Image-2.1 支持对已有照片进行处理。
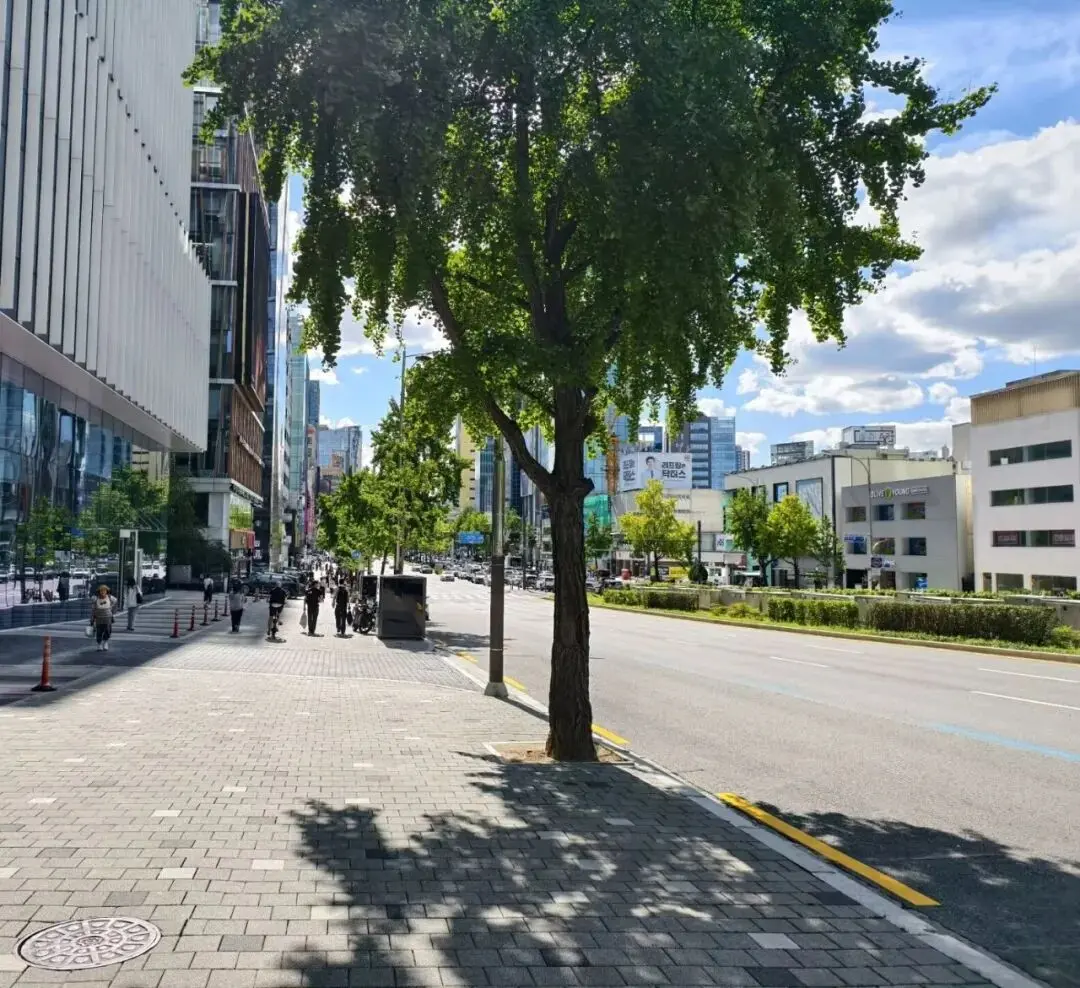
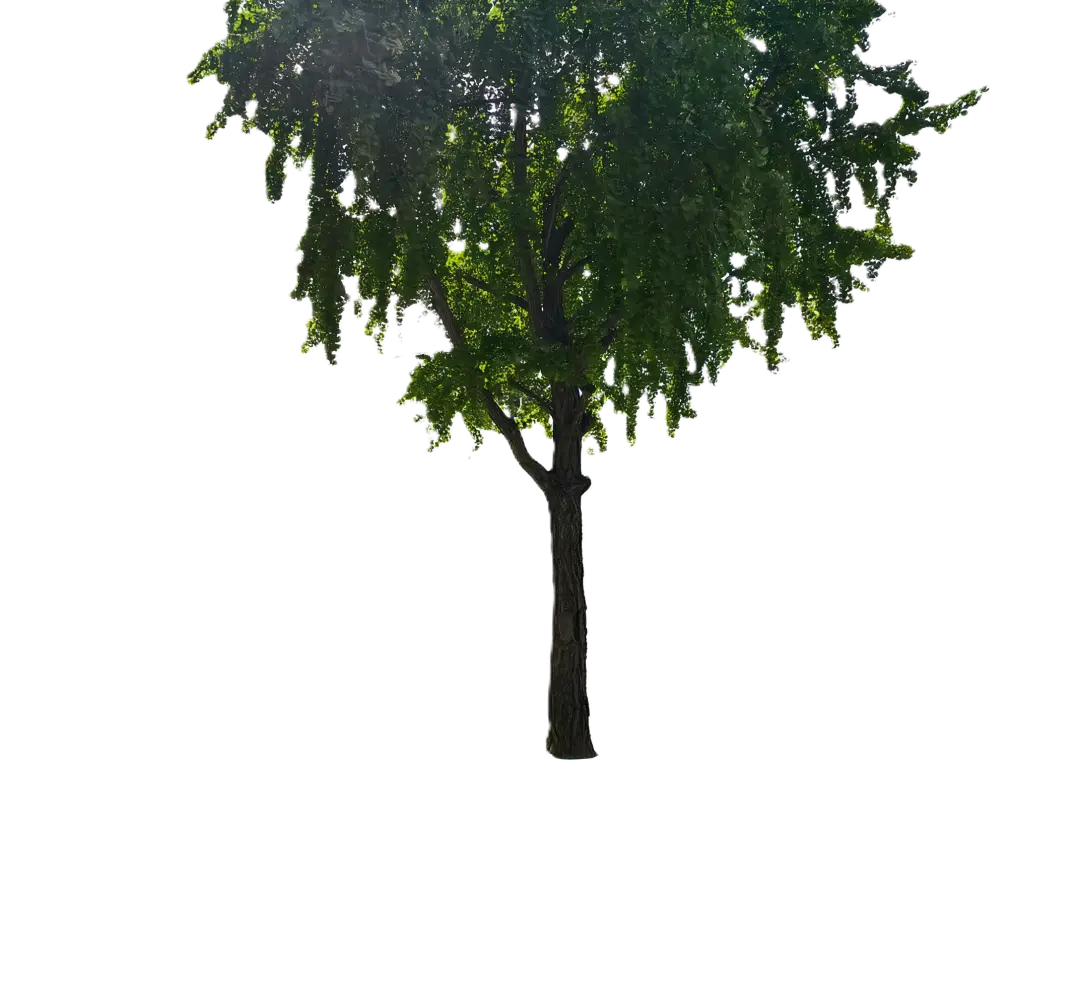
官方给出了从真实照片中提取所需内容、得到 RGBA 透明图的案例。其中的 A 代表透明度通道,用来描述图片各处的透明程度。
可见,这项能力既服务于从零开始生成,也覆盖了已有图片的再利用。创作者可以先提供照片,再要求模型提取其中需要的主体,作为后续设计的素材。
Qwen-Image 系列此前曾推出独立的 Qwen-Image-Layered,探索透明图相关能力。此次 Qwen-Image-2.1 则将原生透明图生成与编辑整合进通用图像模型,进一步提升了便利性。
多图编辑需要的准确,开源 AI 模型也有了
当一张图的需求来自多个对象,编辑任务会进一步复杂化。
例如,如果想把指定的衣服、鞋子、包包和帽子穿戴到同一位模特身上,每一张参考图都有不同作用,模型就需要区分人物与商品,将它们放到合理的位置,并尽可能保留各自的特征。
Qwen-Image-2.1 最高支持 10 张参考图输入。我们试了试,让奥特曼和达里奥坐下来谈谈。使用了 7 张图片:两个人对峙的照片(改个表情)、背景房间、单人沙发、咖啡杯(倒上咖啡)、落地灯、电壁炉、矮桌,最终生成一张完整的效果图。
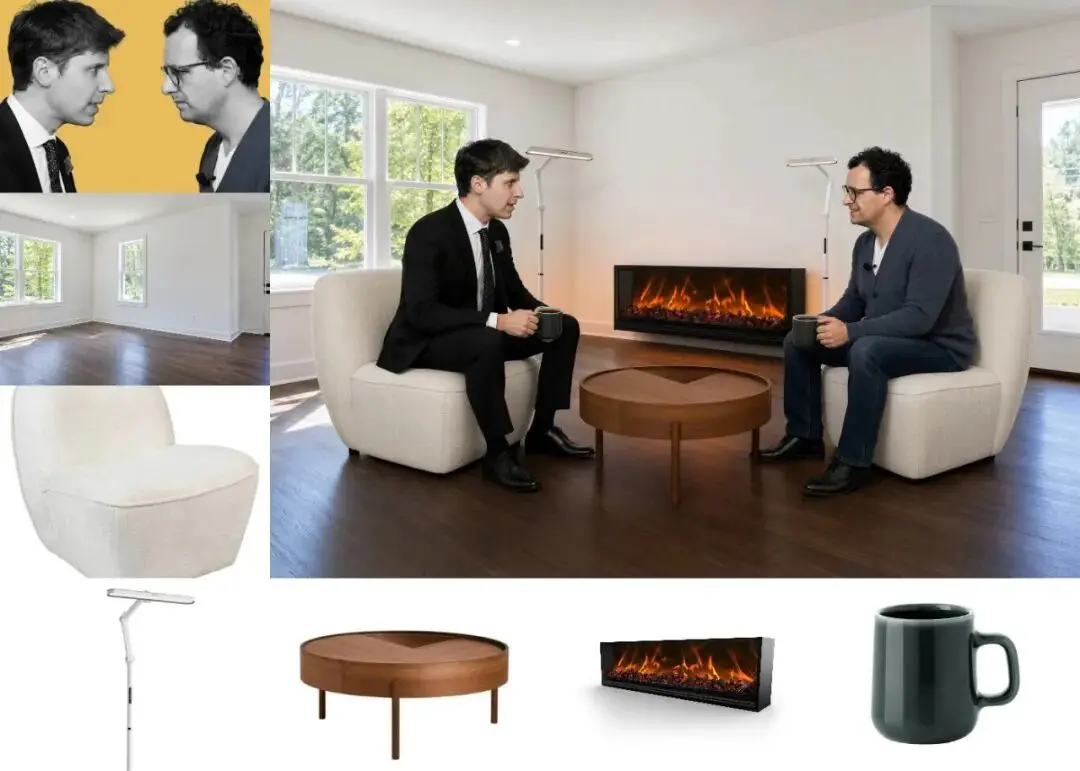
不同的衣饰穿戴现在也能快速给一个人穿搭上看效果,你现在也能把不同的单人拍照组合成多人合照。
技术上,它们考验的不只是 AI 模型能接收多少张图片的输入,还包括参考对象能否在最终画面中各就其位,比例、位置和整体风格是否协调。
组合出了整体画面,接下来通常还有局部调整。
Qwen-Image-2.1 提供圈选、涂抹和独立掩码等方式,让用户更明确地表达编辑位置。比如你可以用几种颜色标出不同区域,要求一次修改同时去掉照片中人物的部分穿戴、把头发改色。
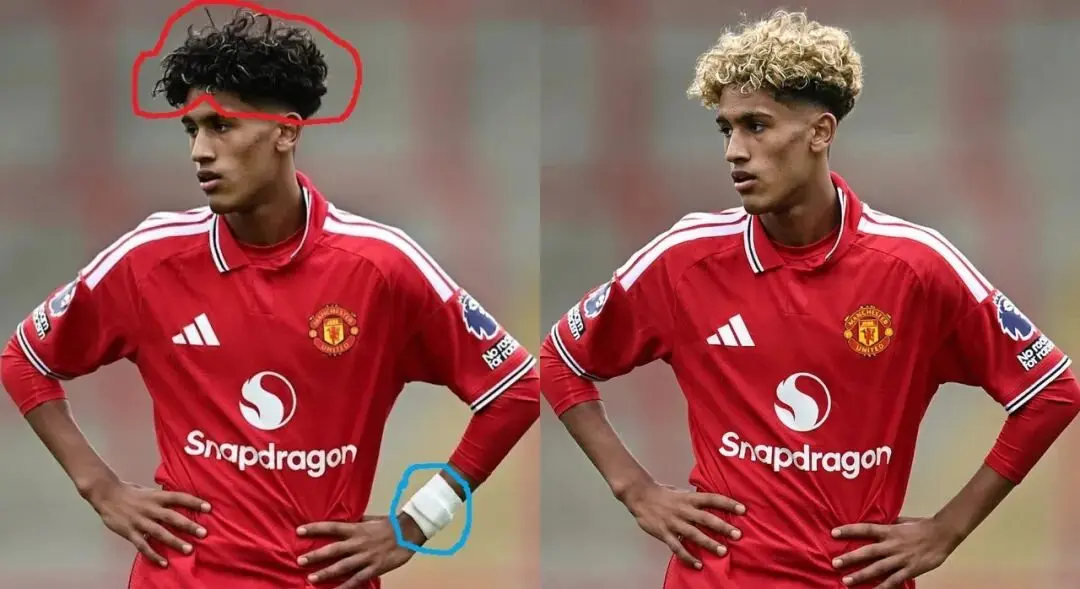
这种交互让空间位置与文字要求建立起对应关系。对于涉及多个区域的编辑,用户可以分别指出哪里需要删除、哪里需要替换,以及希望改成什么。
涂抹方式则适合直接标出新增对象的位置,但直接在原图上圈选或涂抹也会遮住一部分画面。为此,模型还支持通过额外的掩码图片指定编辑区域,这让原图信息能够完整地输入模型。对于包含人物和商品的设计来说,这种保留能力尤为关键。
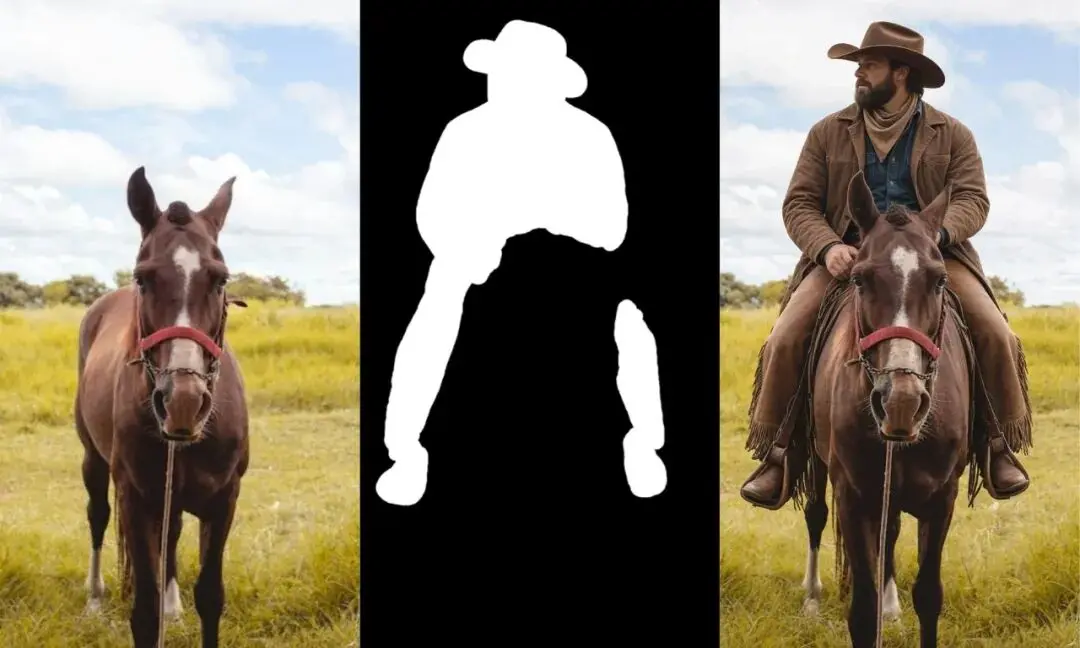
文字准确性、画面质感
换了发型或场景,人像仍应保有原来的身份特征;商品换了摆放环境,包装文字、纹理和形状也需要尽可能一致。否则,画面即使好看,也可能无法用于原本的展示任务。Qwen-Image-2.1 重点介绍了人像与商品两类场景的编辑保真能力,看起来效果还不错。
我们尝试了一下,比如让它把小学《信息科技 三年级上册》的这页截图里面,DeepSeek 的欢迎语「我是 DeepSeek,很高兴见到你!」改成「你好,我能帮上什么忙吗?」,再把深度思考(R1)改成最新版本的深度思考按钮,再点亮:
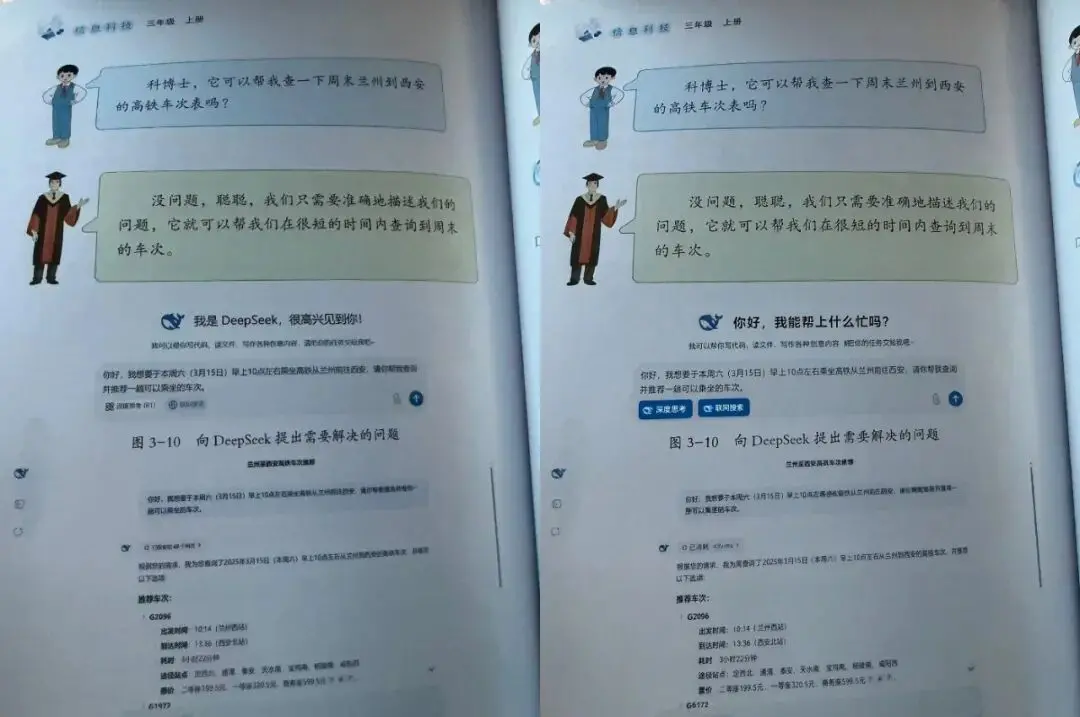
在生成和编辑之外,Qwen-Image-2.1 也继续改善了在文字与人物上的表现。不论是文字密集的图文页面、信息图、论文配图,内容的准确性和排版美观程度都被提升到了一个可观的程度。
人像部分,Qwen-Image-2.1 进一步增强了光影与细节表现。现在 AI 生成的图像不论是人物的发丝、服装纹理、面部细节还是环境光线都变得更加协调,画面质感更加细腻了。
另外还有更好的全景图生成、信息图、三视图、分镜图生成能力,它们拓展了静态图像生成和编辑的应用范围,为角色展示、视觉策划等任务提供了更多可能。我们试了一下,使用社区制作的 Qwen 二次元形象生成一系列分镜插画:
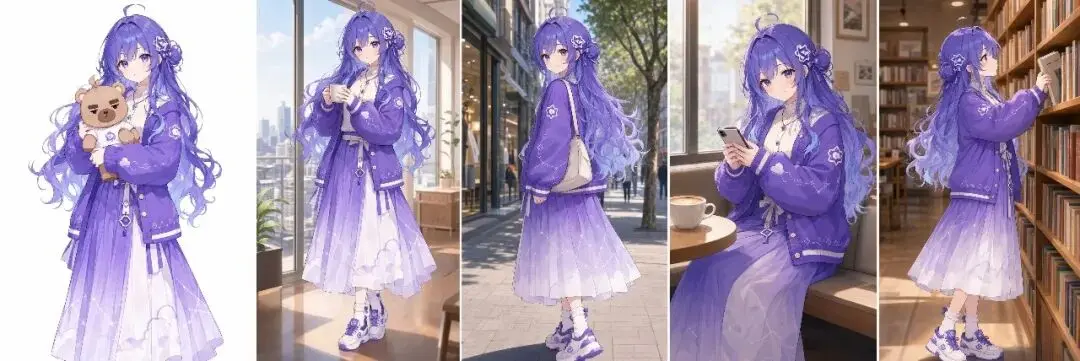
这些能力组合在一起,让 Qwen-Image-2.1 覆盖了更为完整的图片处理链条,现在我们可以基于一个 AI 模型完成大量工作,先使用多张参考图组织画面,再对区域进行调整,同时尽量保留人物与商品的关键特征。一个视觉生成部分仅有 7B 的开源 AI 最终能把返工减少到什么程度,将是后续实测中值得关注的问题。
应用空间有多大?
Qwen-Image-2.1 的发布让我们看到,图像模型正在覆盖创作流程中更多的细化环节,而且这个趋势在变得越来越快。
不论是透明素材的输出,多图参考、局部编辑与保真度能力的提升,都增加了 AI 模型进入实际工作流程的可能性。对于创作者而言,这意味着更多的素材制作和调整工作,都可以通过更简单的方式交给开源生图模型完成;而对开发者们来说,新模型开源也为围绕这些能力构建设计工具、应用和定制工作流提供了新的基础。
我们可以大胆预测下,随着 Qwen-Image-2.1 这类图像模型的开源,社区还会进一步把生成与编辑能力融入更多内容制作场景,让更多人用上适合自己需求的创作工具。当这些 AI 能力成为日常软件中随手可用的功能,从想法到视觉作品的门槛,或许就能再次大幅降低。
目前,Qwen-Image-2.1 的开放权重已发布至 Hugging Face 与 ModelScope,技术报告已上传至 GitHub 仓库。
-
Blog: https://qwen.ai/blog?id=qwen-image-2.1
-
GitHub: https://github.com/QwenLM/Qwen-Image-2.1
-
Model Scope: https://www.modelscope.cn/models/Qwen/Qwen-Image-2.1
-
Hugging Face: https://huggingface.co/Qwen/Qwen-Image-2.1
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com