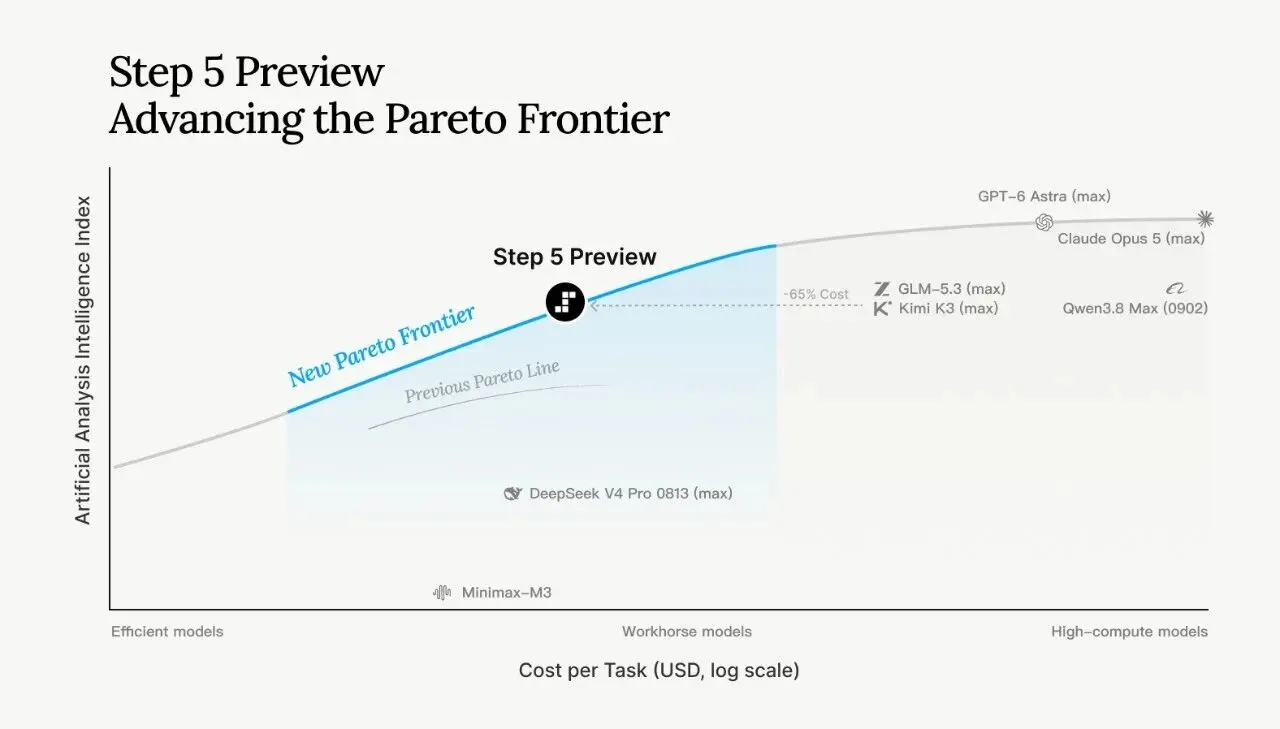
阶跃星辰新版旗舰模型 Step 5 发布了 Preview 版本,它给自己定的命题不是单项性能多强,而是"帕累托前沿"——能力、成本、效率、场景覆盖之间那条最佳平衡的边界。官方话是:随着 Agent 从"回答问题"走向"完成任务",主力模型的标准从"单项能力强"变成了"多项之间平衡"。
- Model Blog:https://www.stepfun.com/step-5-preview
- 国内开放平台 API 接入:https://platform.stepfun.com/
- 国外开放平台 API 接入:https://platform.stepfun.ai/
- Studio平台在线体验:studio.stepfun.com
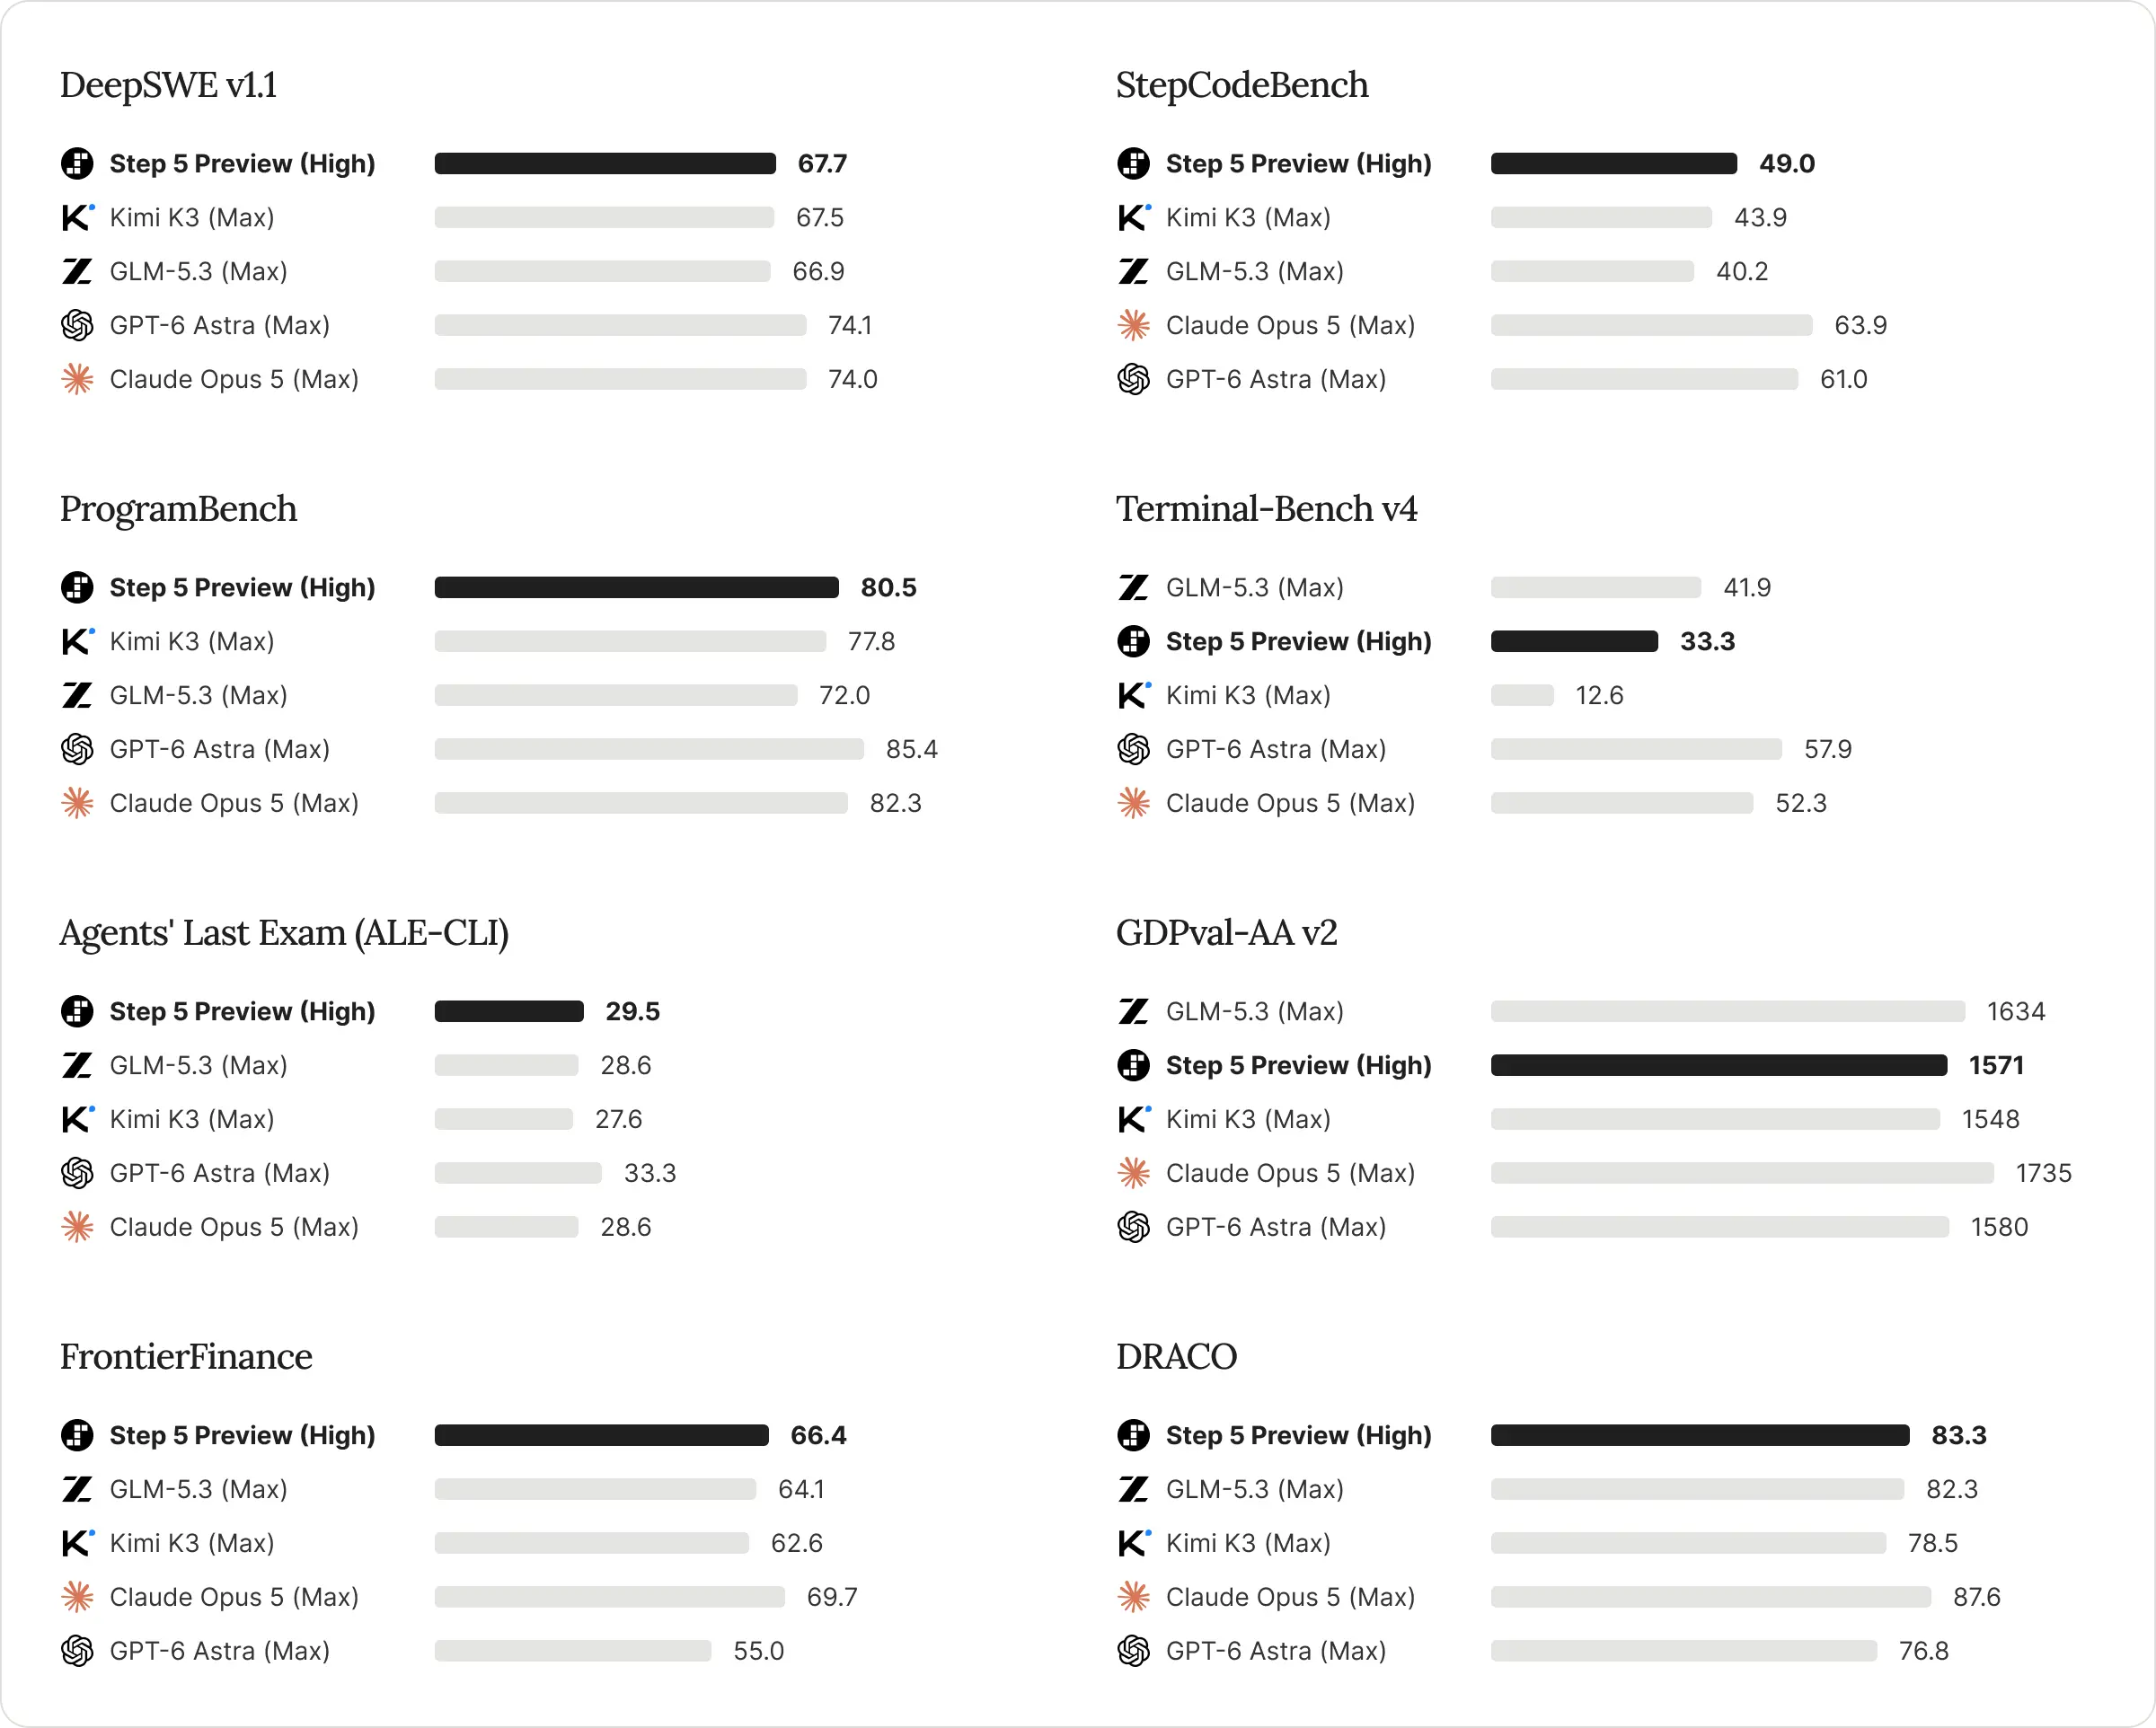
硬参数:稀疏 MoE 架构,总参 600B、激活参数只 27B,支持 100 万 token 上下文,原生文本+视觉输入。单位成本是这次的一个卖点——官方称单任务成本仅为 Claude Opus 5 的 1/8,同时在 Artificial Analysis Intelligence Index 拿到 44 分,位居全球开源模型前三。在 Agents' Last Exam CLI 子集(ALE-CLI)、金融投资研究评测 FrontierFinance、跨领域深度研究评测 DRACO 上,都仅次于 GPT-6 Astra 或 Claude Opus 5,领先其他开源模型。
文章里最值得看的是两个 24 小时长周期实验,都是"让模型自己连续干半天"的 agentic 场景。一个是在单张 NVIDIA H100 上从零优化 MLA GPU 内核,头维度 512、batch size 1、64 个头、8192 token,Step 5 Preview 自主实现、运行、测吞吐,遇到跑得通但更慢的方案就放弃、回退到最佳版本继续调,约 22 小时把峰值性能推到 508 TFLOPS,压过了 Claude Opus 5 的 493。
另一个是自动化后训练,让它自己调用一个接生产数据的 annotator、决定怎么改后训练数据,把一个 Qwen3-30B-A3B 基座在 AIME24 上的准确率从 53.3% 提到 60%,和 Claude Opus 5 持平但消耗的 annotator token 更少。
回应了"Scaling 转向"这个当下最热的争论:过去大模型靠更多计算换更强智能,现在计算成本被同步放大,下一阶段的 Scaling 不只是更多 Compute,也包括更高效率的 Compute——这是从 Step 3.5 Flash、Step 3.7 Flash 到 Step 5 Preview 一路在追的问题。模型全量开放,权重 10 月 15 日放出。
来源: