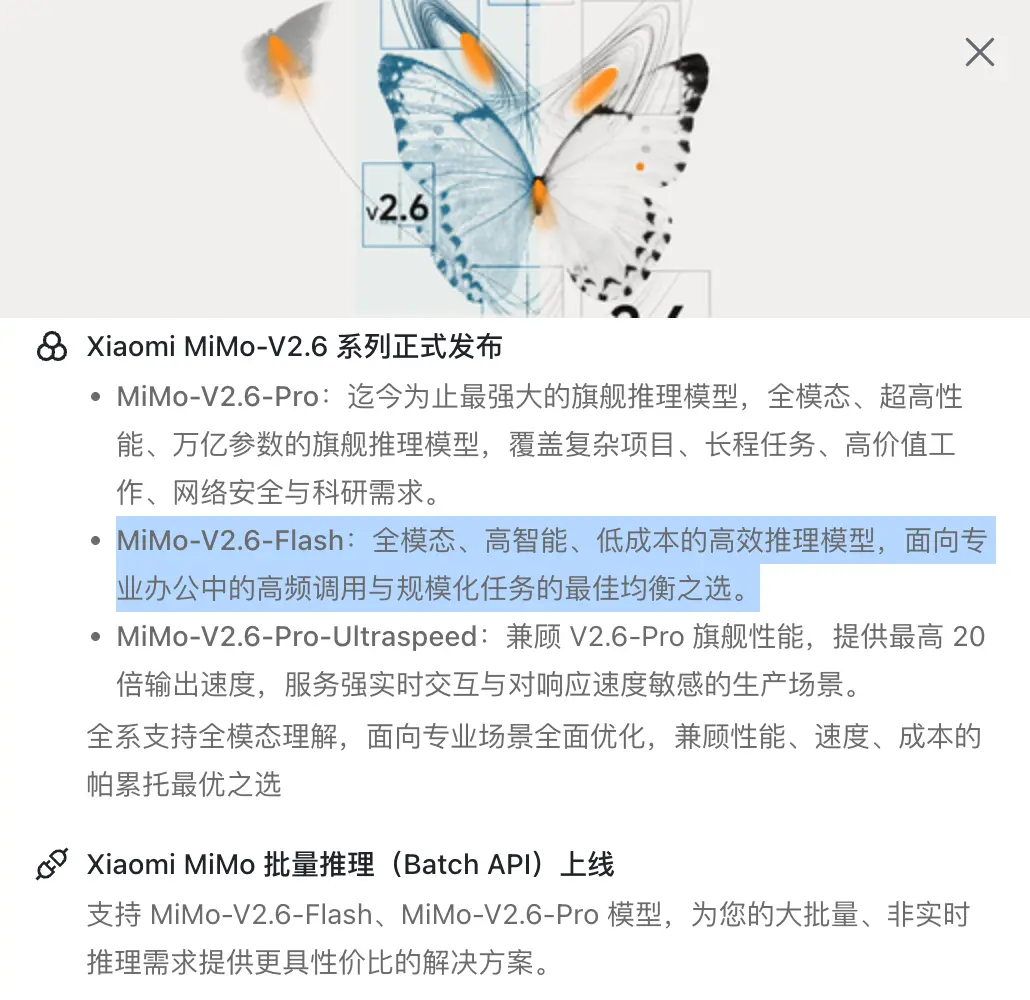
小米开源了 MiMo-V2.6 系列,Pro 和 Flash 两个原生全模态模型一起放出。
这名字在国内开源圈已经不算陌生,但这次发布的重点不在模型本身,而在它背后那 6 天的 Live RL 训练——官方把整个训练过程、成本、技术报告连同 RL 代码和训练环境一起开源了。
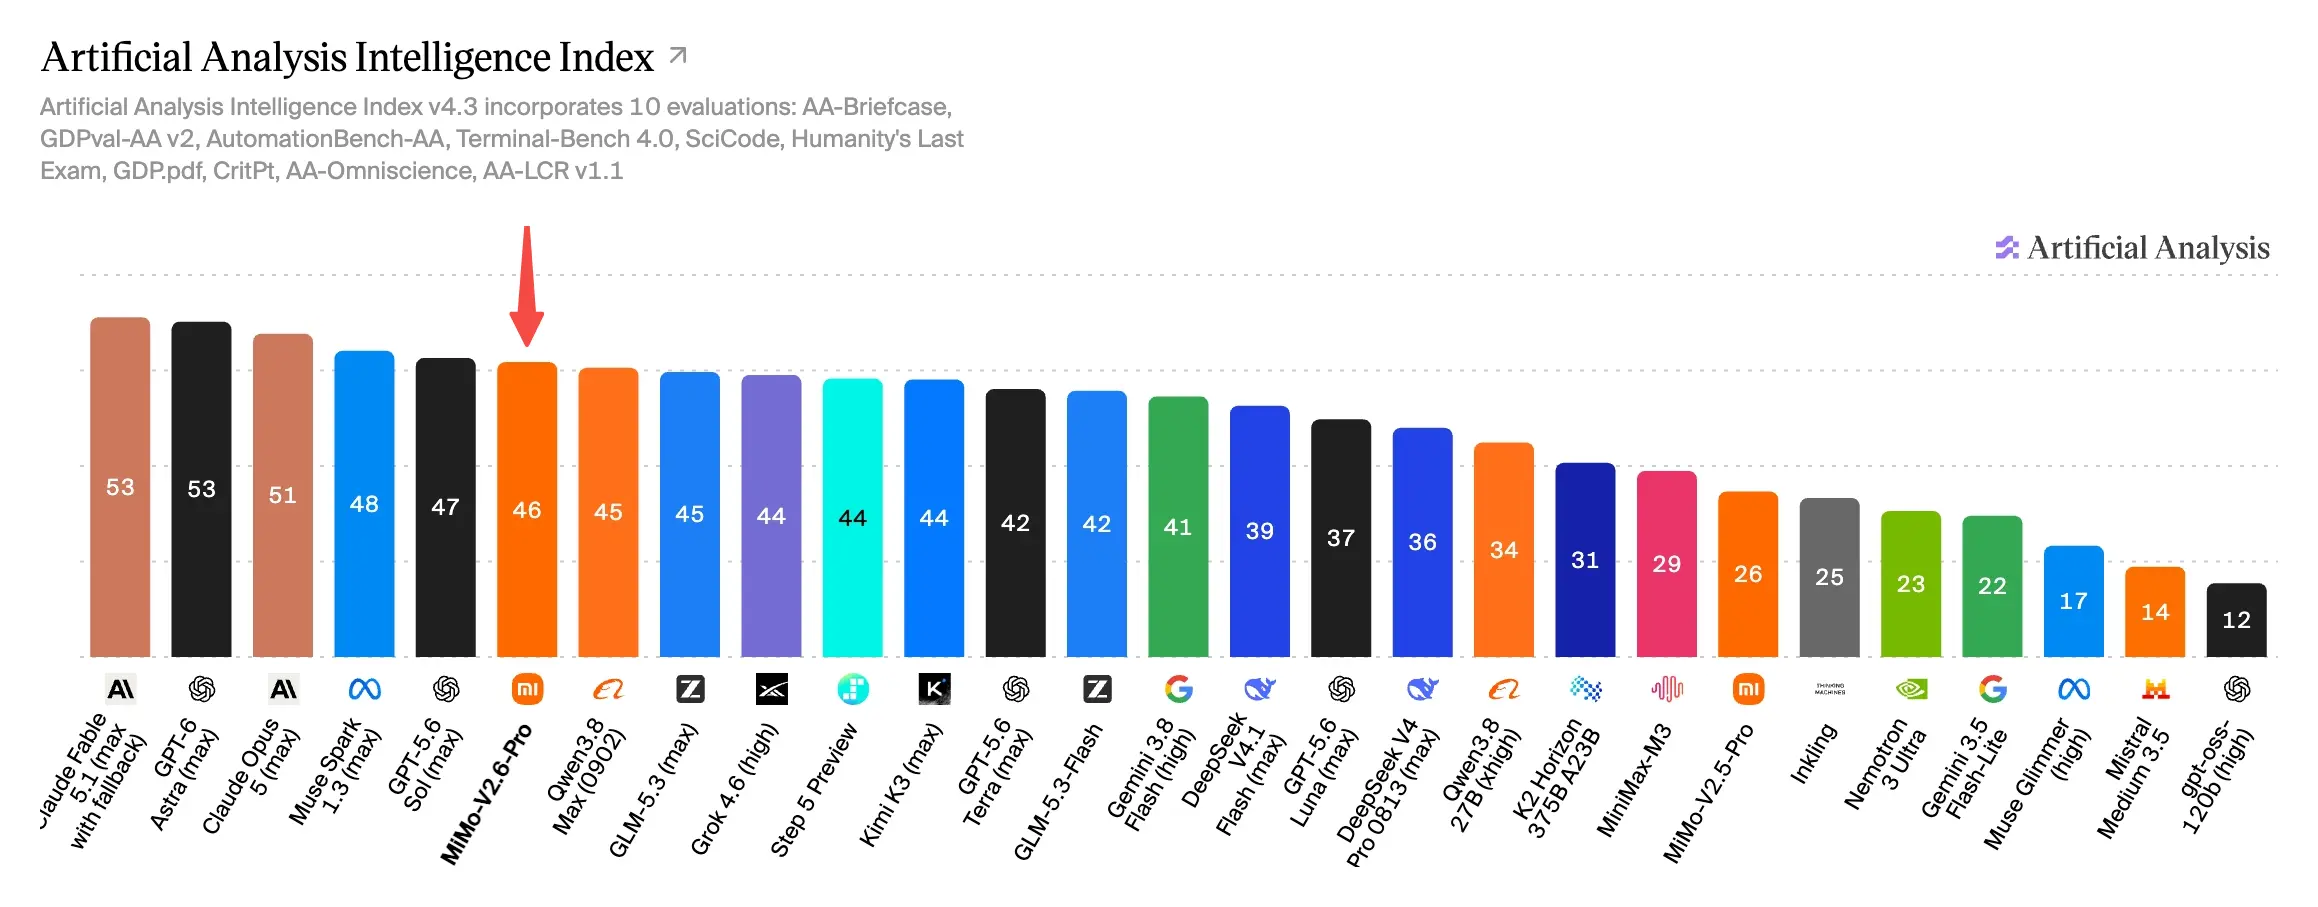
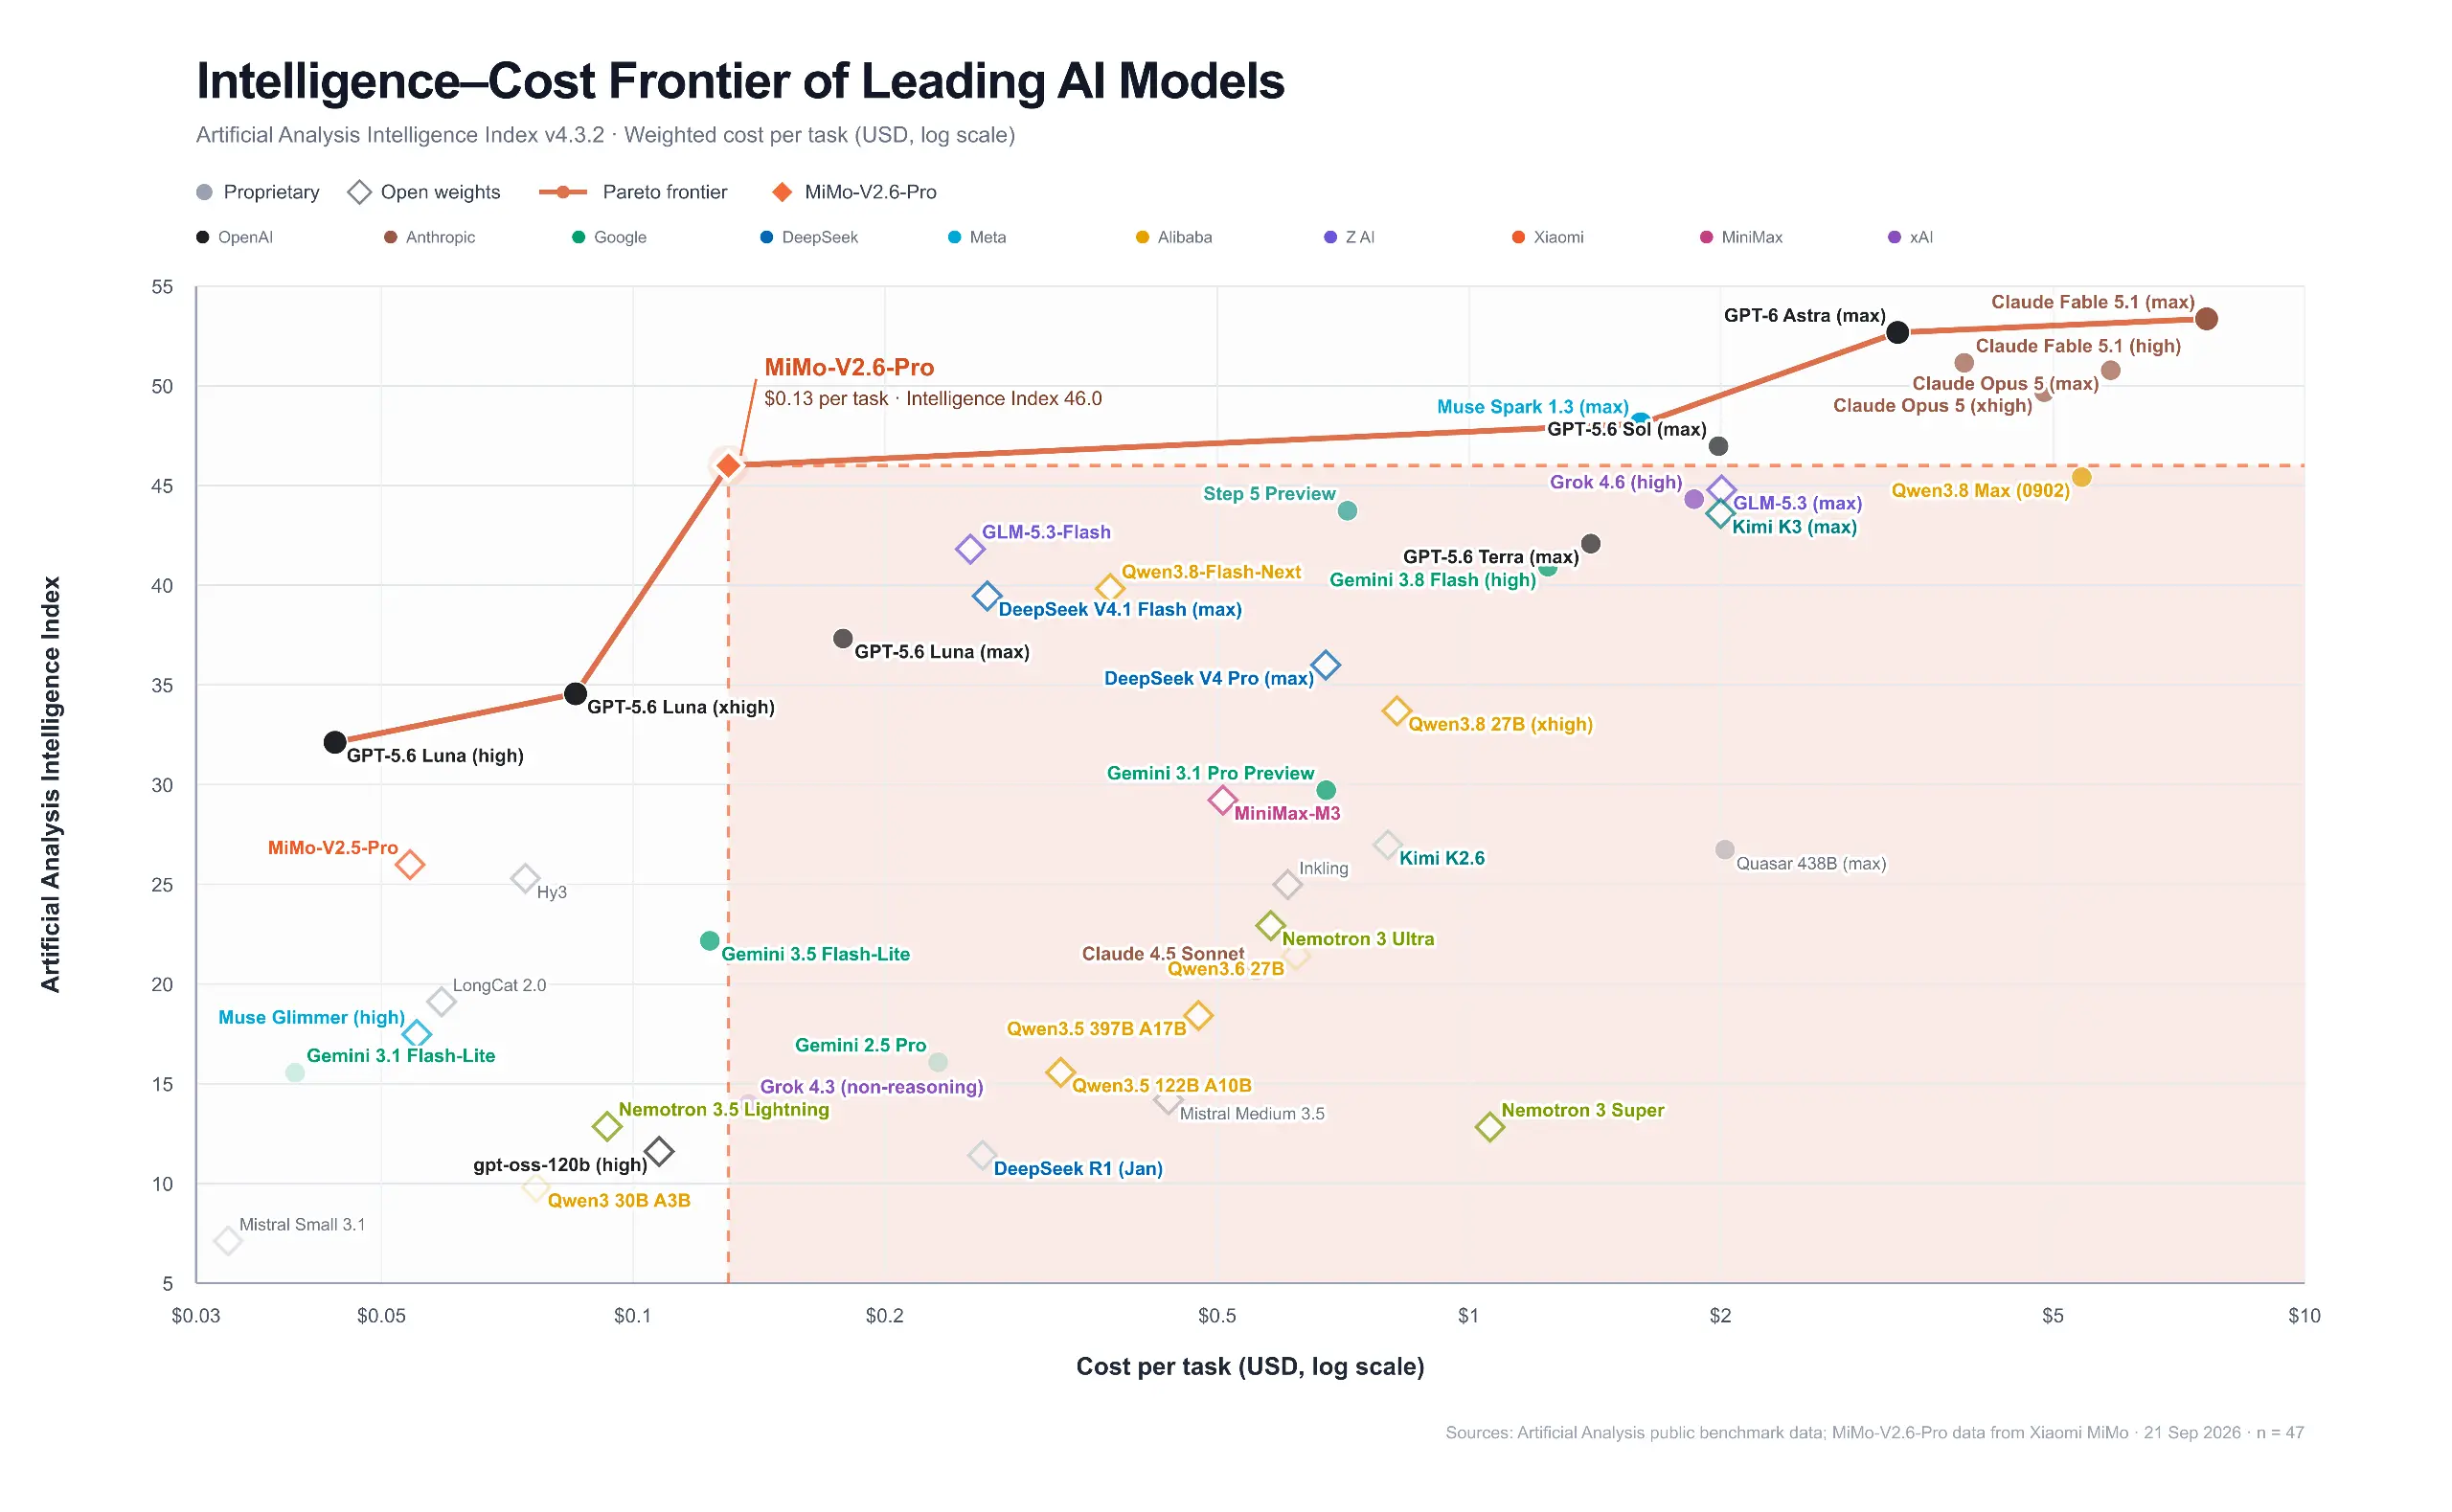
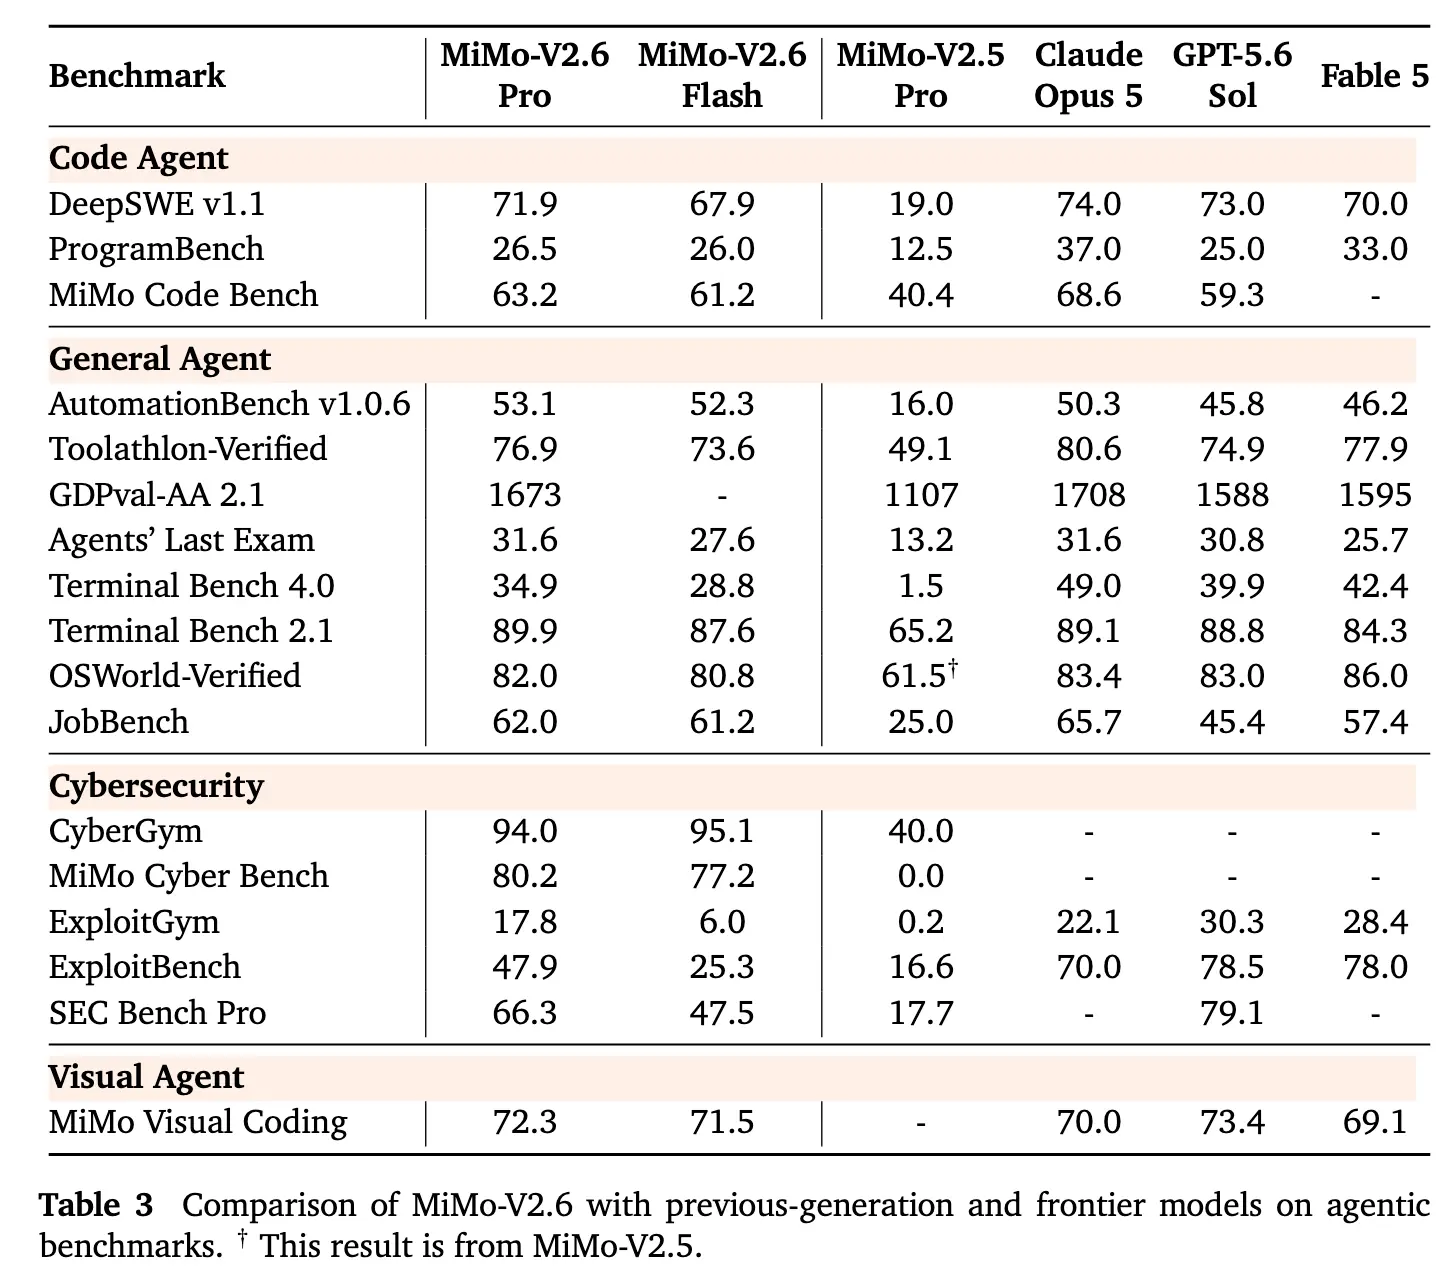
一段话说清楚这次发到了什么位置:MiMo-V2.6-Pro 在 Artificial Analysis 的 Intelligence Index 上拿到 46 分,超过 Kimi K3 和 Qwen3.8 Max,官方称为当前最强开源模型;但对照闭源最强的 Claude Fable 5.1 和 GPT-6 Astra 仍有差距。言下之意很直白——开源这一档,小米认为自己已经站到最前面。
训练数据很能说明这次是把算力砸在哪了。耗时不到 6 天,Flash 和 Pro 的训练成本分别约 85 万和 262 万美元,各完成 30 步,累计约 75 万条轨迹;训练任务平均通过率相对提升 25% 和 12%,样本外的长程软件工程基准 DeepSWE v1.1 上分别涨约 17 分(48.8→65.7)和约 14 分(58.4→72.6)。规模化 RL 的样本效率,这次给了一套能看的公开数据。
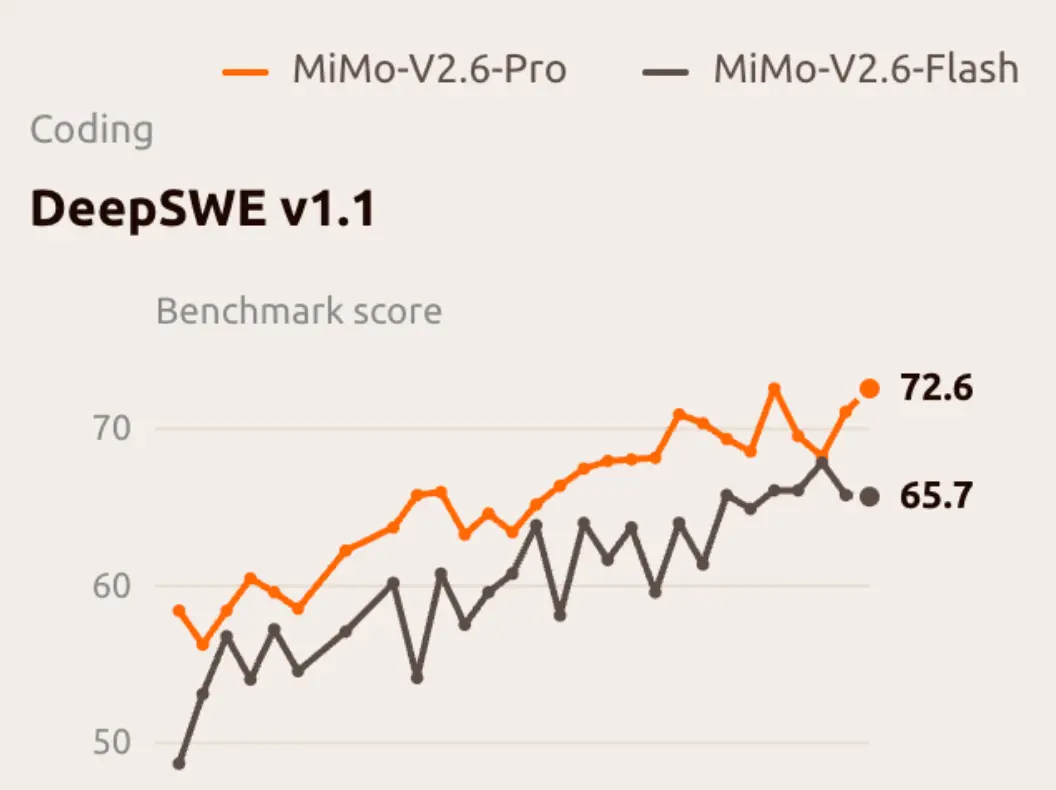
工程细节里值得开发者扒一扒的是它对大规模 RL 的几个处理:单次更新用 1,568 个样本、支持 1M 上下文长度训练、单步训练 Token 达 3.5~3.7B;构建覆盖 Code、General、Visual、Cyber 的多任务训练体系,混合多个 Harness 带动不同能力协同提升;用 Group 内相对比较做奖励信号,形成模型自我改进闭环。训练规模一大,还冻结 MoE Router 抑制专家负载漂移,并建了覆盖奖励设计、对抗性评测、异常检测和验证器交叉校验的 Reward Hacking 防线。
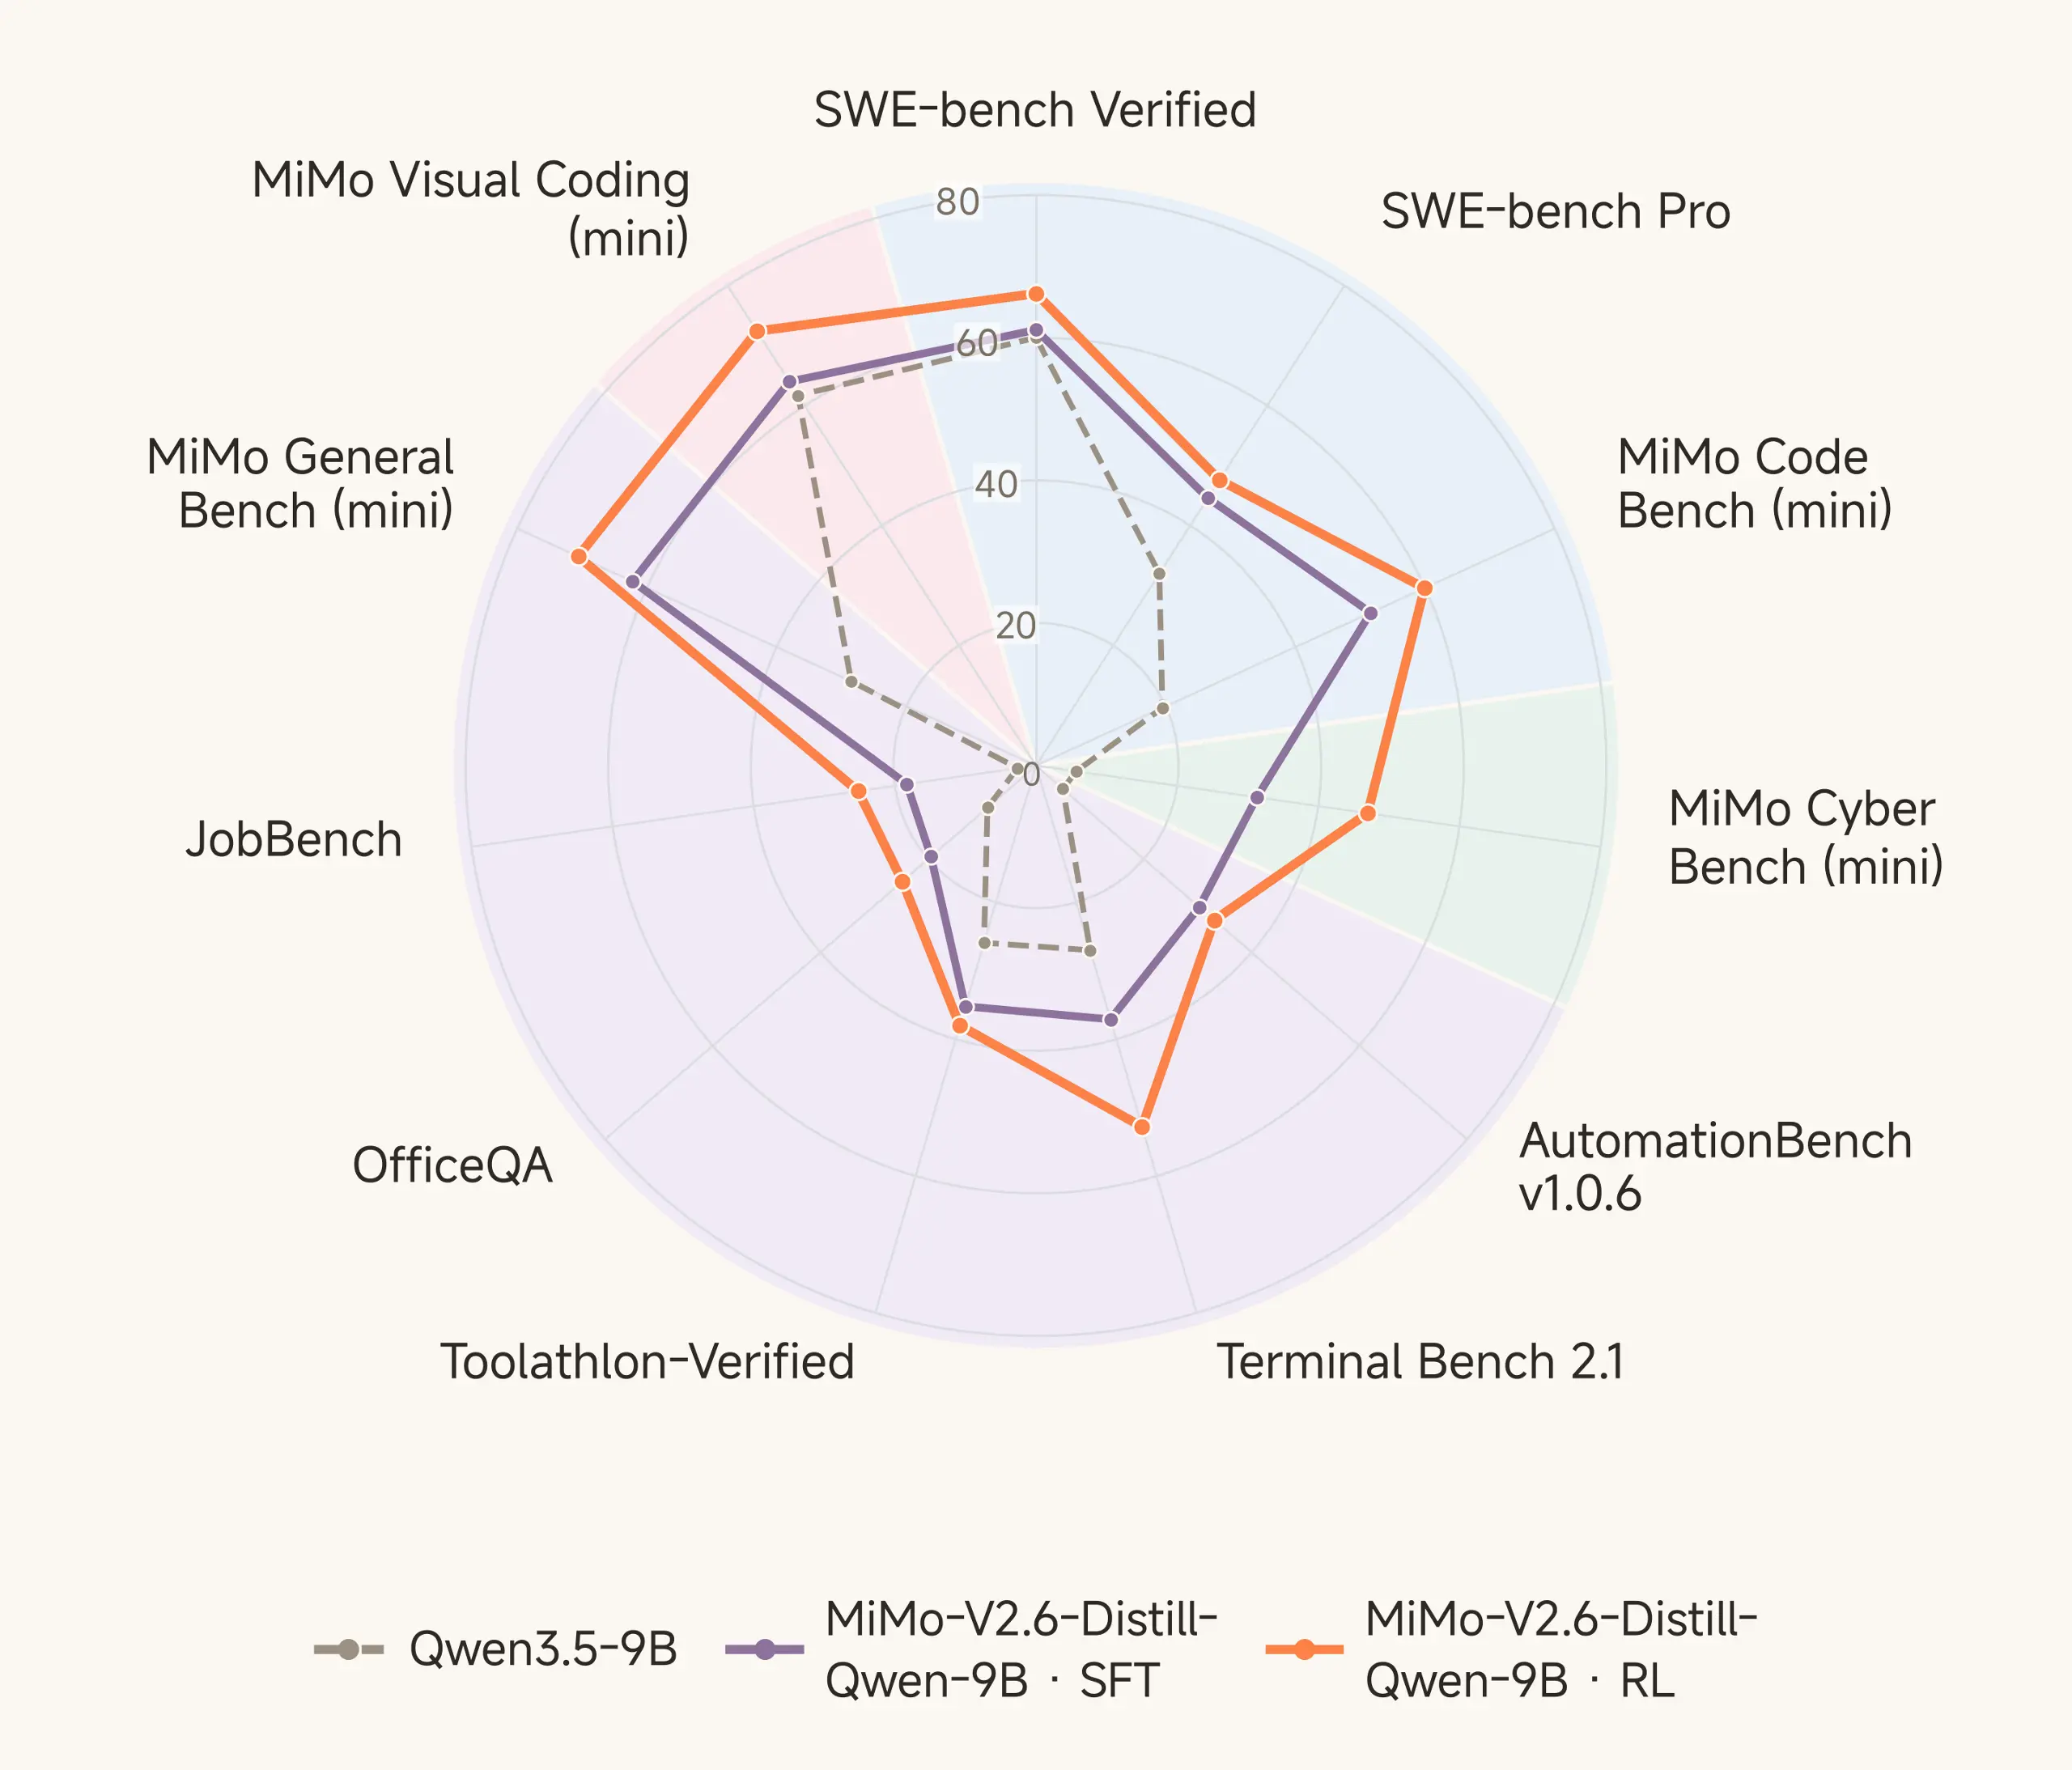
开源内容比模型本身更值得留意。官方放出了 7k+ 高质量 RL 任务环境,覆盖软件工程、漏洞复现、知识型工作、网页设计开发四类智能体任务;以 Distill-Qwen-9B 为起点跑 RL,11 项评测均较 SFT 基线提升——SWE-bench Verified 从 61.1 到 66.2、MiMo Cyber Bench 从 31.3 到 47.0。同时开源基于 verl、uni-agent、mini-swe-agent 的端到端 RL 训练框架,以及把系统提示、工具与上下文管理解耦的极简 mini-harnesses。这套东西的意义在于,以往只有几家大厂会公布这类训练细节,现在能直接复现。
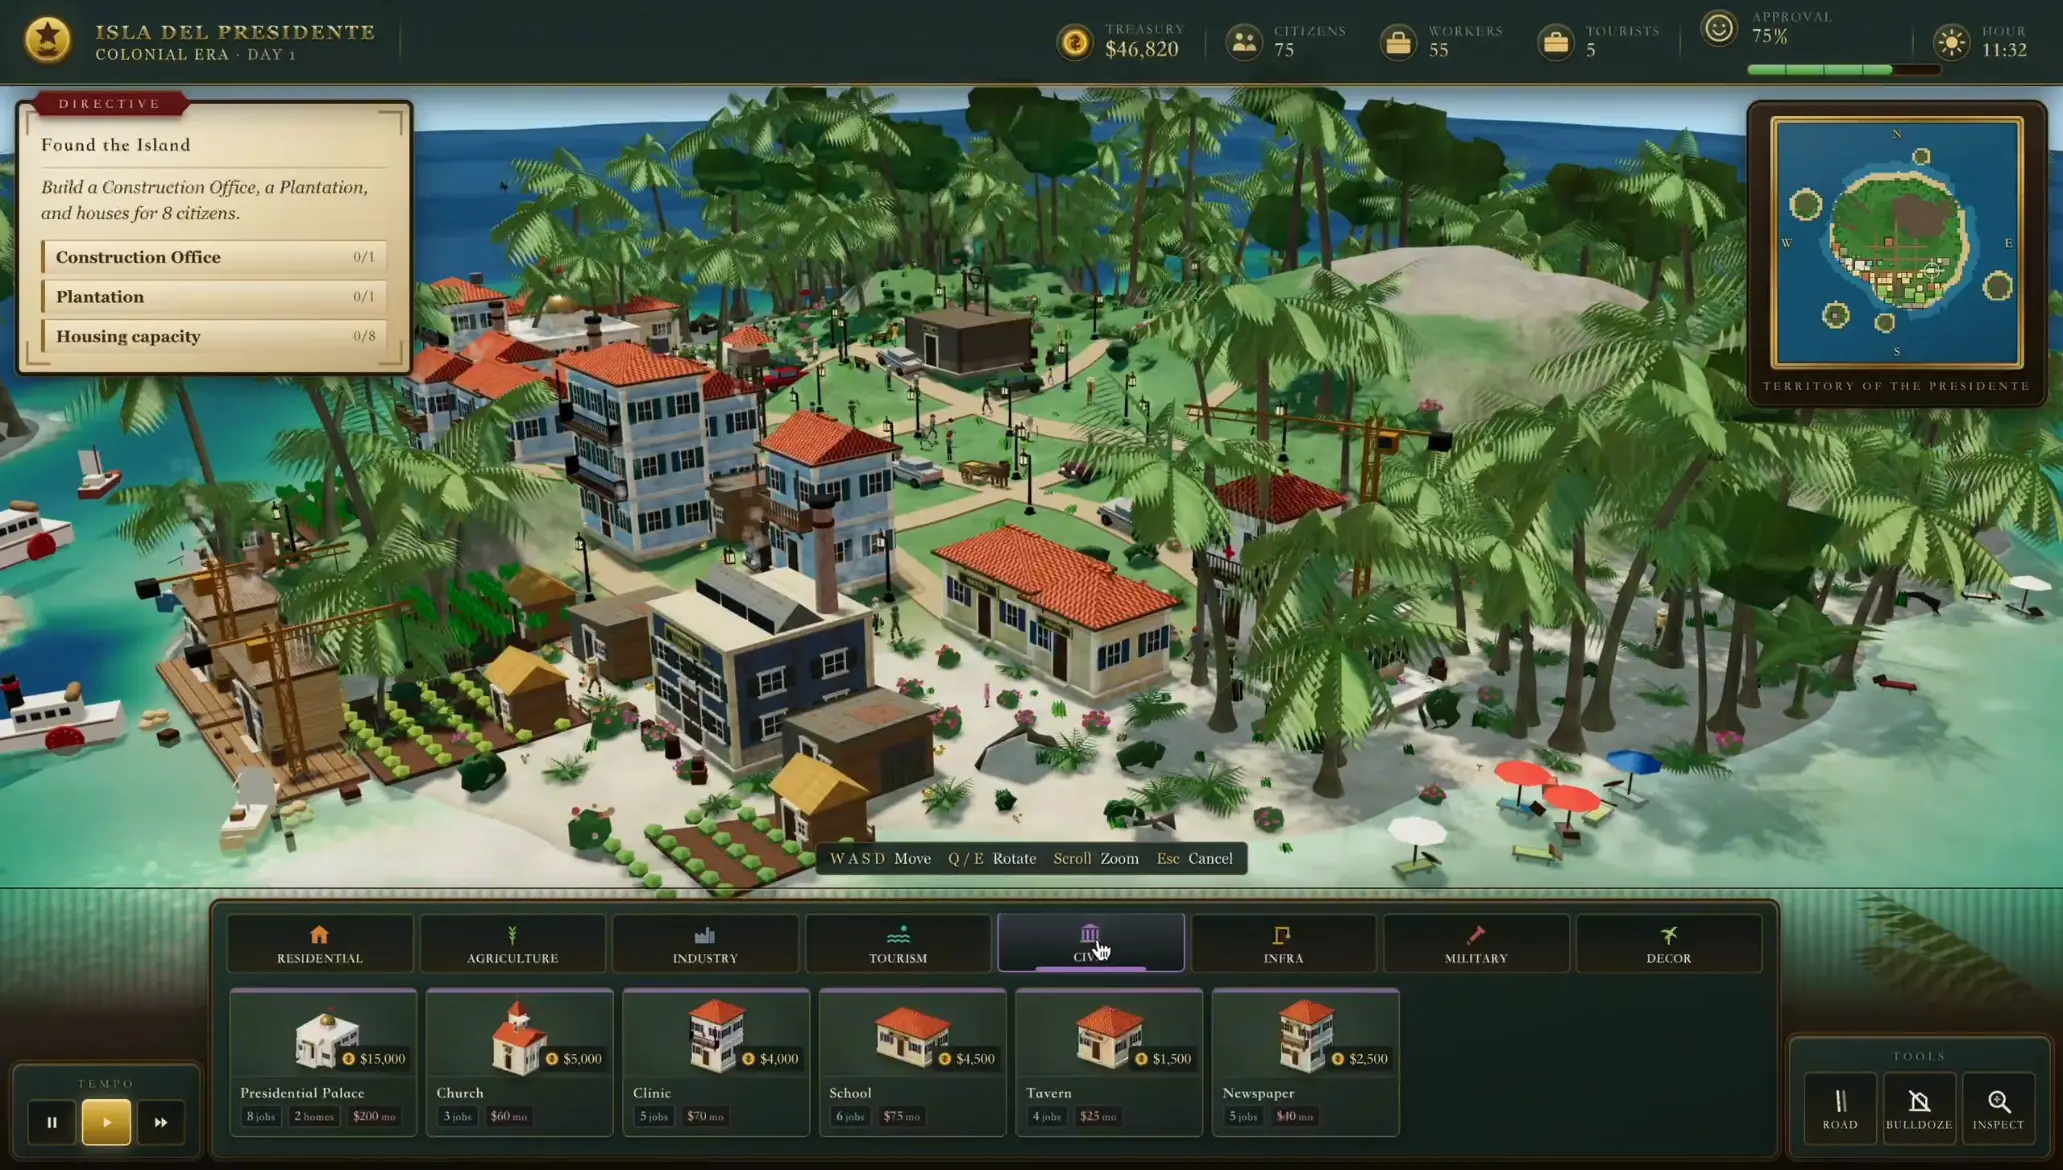
能力展示部分,小米同时调出了 3D 开放世界游戏、Blender 建模、用多视角画面闭环控制 Franka Panda 机械臂的具身智能,以及 Computer Use Agent。科研方向更抓眼球:协助在 Lean 4 里完成了 Li–Yorke 名篇《周期三蕴含混沌》原始主定理的完整形式化,6000 余行 Lean 源码通过内核核验,且模型没做过针对 Lean 的专项后训练。
价格上,MiMo-V2.6 沿用 V2.5 的 API 定价,官方说法是在同等智能水平下价格仅为海外模型的 1/20 至 1/60。
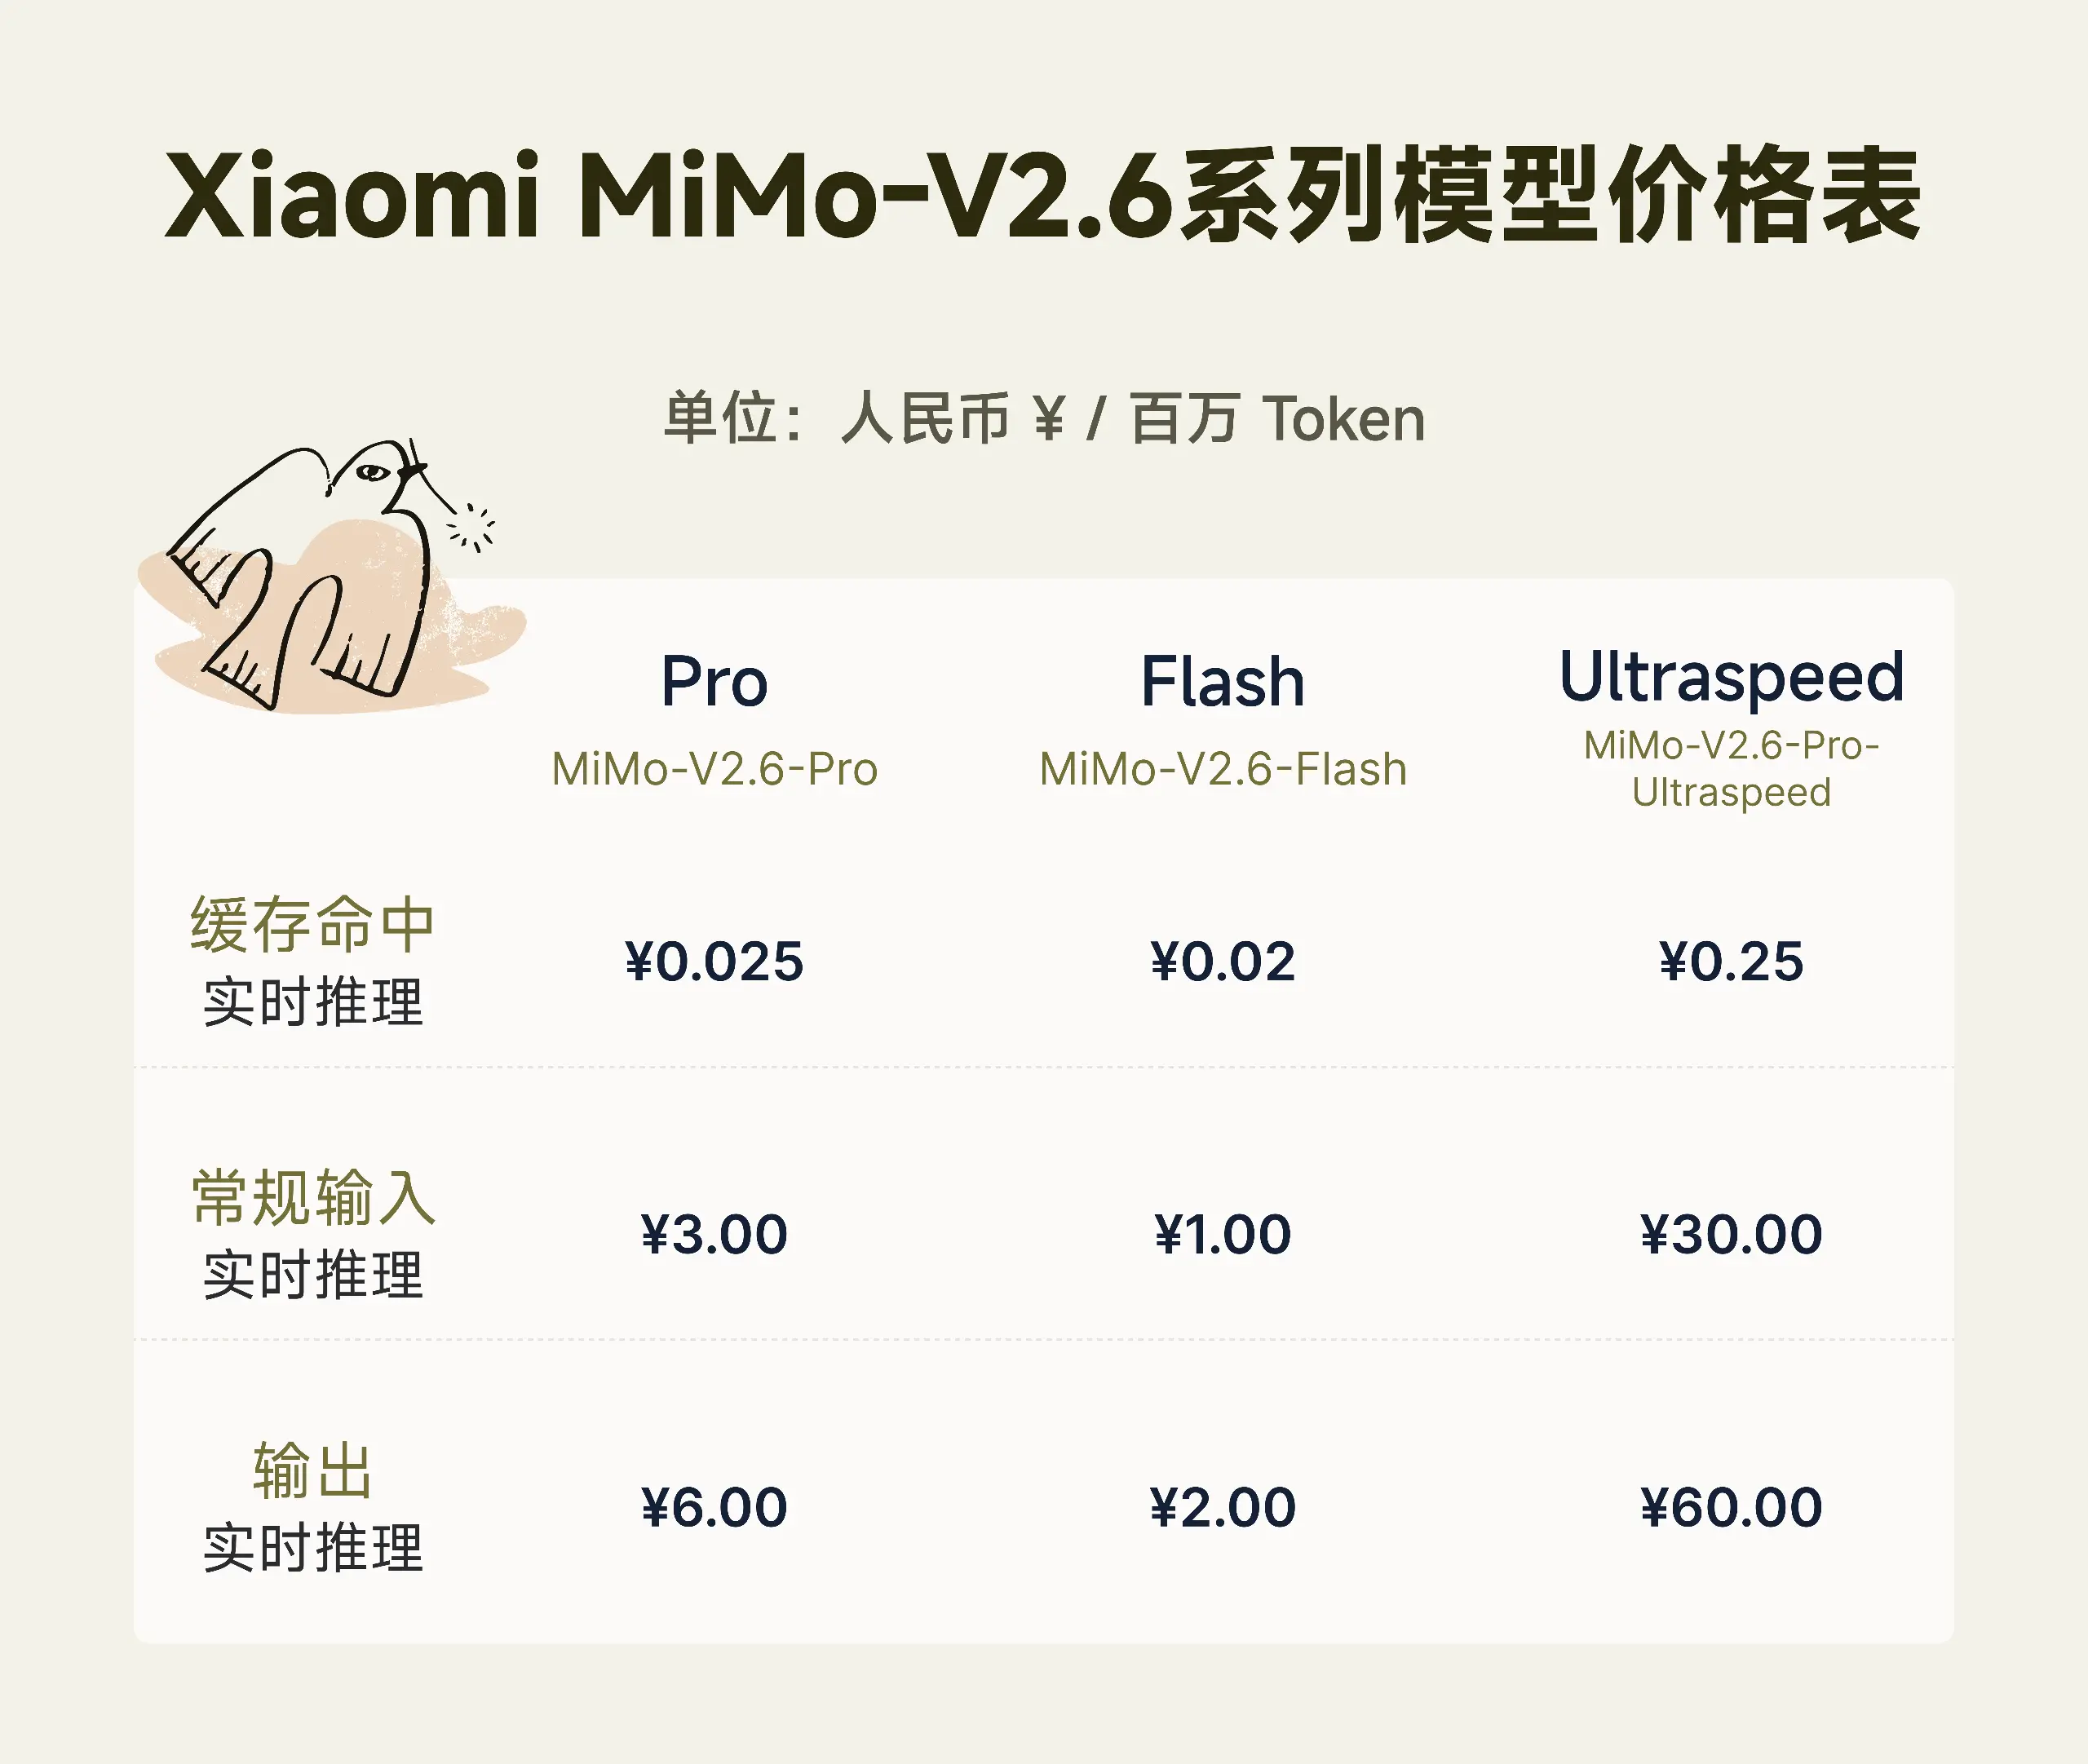
新的 MiMo Desktop 客户端和最高 20 倍输出速度的 UltraSpeed 模式同步上线。
来源: